
Å planlegge, gjennomføre og tolke en test på ekte data; feil av type I og II.
Hypotesetesting i reelle datasett
I de tre forrige kapitlene kom tallene ferdig servert: «et utvalg på 40 gir ». På ekte data er det ikke slik. Da må vi selv bestemme hva vi lurer på, hvor tallene skal komme fra, og hva vi gjør med dem — før vi begynner å regne.
Hele arbeidet har seks skritt:
| skritt | hva du gjør | når |
|---|---|---|
| 1 | formuler problemstillingen i ord | før data |
| 2 | sett opp og | før data |
| 3 | velg og utvalgsstørrelse | før data |
| 4 | samle inn dataene | — |
| 5 | regn ut testobservator og p-verdi | etter data |
| 6 | konkluder i kontekst, med forbehold | etter data |
De tre første skrittene er de viktigste, og de er de eneste som ikke kan gjøres om igjen. Har du sett dataene først, kan du ikke lenger late som du ikke har det.
I dette kapittelet gjør vi hele løpet på et datasett, og ser deretter på de to feilene en test kan gjøre — for en test tar av og til feil, og det er en del av metoden, ikke en svakhet ved den.
På landsbasis bor det i gjennomsnitt 2,12 personer i en husholdning. En kommune med mange barnefamilier tror at tallet er høyere hos dem. De trekker 40 tilfeldige husholdninger fra folkeregisteret og noterer hvor mange som bor der:
| antall personer | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| antall husholdninger | 7 | 15 | 8 | 6 | 3 | 1 |
a) Formuler problemstillingen og sett opp hypoteser.
b) Finn og .
c) Gjennomfør testen på 5 %-nivå.
d) Skriv konklusjonen med de forbeholdene som hører hjemme.
a) Problemstilling: Er gjennomsnittlig husholdningsstørrelse i kommunen høyere enn landsgjennomsnittet på 2,12?
Kommunen har en klar retning i tankene, så testen er ensidig:
Signifikansnivå: , valgt på forhånd.
b) Vi regner fra frekvenstabellen. Summen av alle husholdningsstørrelsene:
regneark:   =SUMMERPRODUKT(A2:F2;A3:F3)/SUMMER(A3:F3)   gir 2,65
            =STDAV.S(...)  på de 40 enkeltverdiene        gir 1,29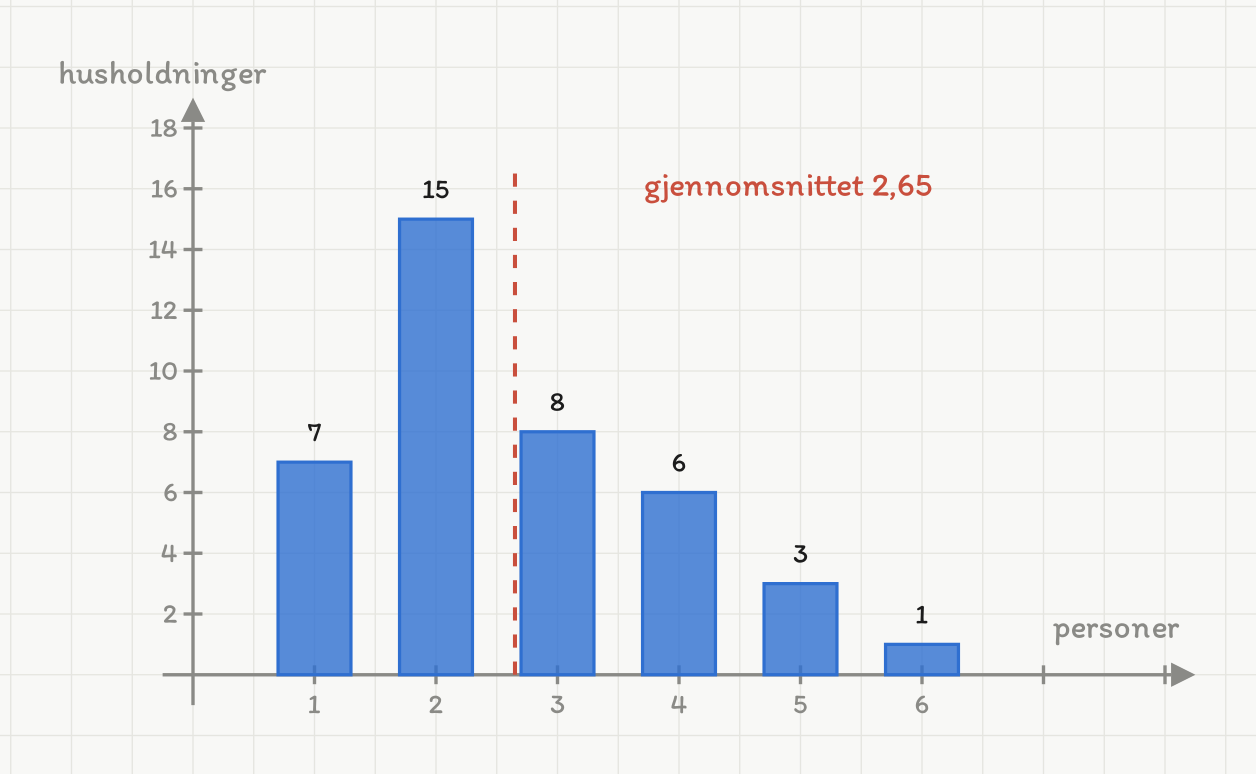
Trinn 1 i analysen: beskriv først. De 40 husholdningene fordeler seg med toppen ved to personer og en hale mot høyre. Gjennomsnittet 2,65 ligger til høyre for typetallet, slik det alltid gjør i en høyreskjev fordeling — og skjevheten er nettopp forbeholdet som må drøftes når testen bygger på normaltilnærming.
c) Standardfeilen:
Testobservatoren:
p-verdien:
forkastes.
d) Konklusjon med forbehold:
Undersøkelsen gir grunnlag for å si at husholdningene i kommunen i gjennomsnitt er større enn landsgjennomsnittet på 2,12 personer (). Vårt anslag er 2,65 personer, med 95 % konfidensintervall .Forbehold: (1) Konklusjonen gjelder bare hvis de 40 husholdningene virkelig er trukket tilfeldig — er de hentet fra ett boligfelt, måler vi boligfeltet og ikke kommunen. (2) Enkeltmålingene er langt fra normalfordelte (de er hele tall fra 1 til 6, og fordelingen er skjev), men det er greit: det er som skal være tilnærmet normalfordelt, og med sørger sentralgrensesetningen for det. (3) Testen sier ingenting om hvorfor husholdningene er større.
Svar: a) mot , . b) og . c) , — forkastes. d) Se konklusjonen over.
NB — forbehold nummer 2 er det viktigste å forstå. Mange tror normalfordeling er et krav til dataene. Det er det ikke. Kravet gjelder fordelingen til gjennomsnittet, og den blir normal av seg selv når er stor nok.
Gjør den samme utregningen som i eksempel 1. En bilverksted-kjede oppgir at gjennomsnittlig reparasjonstid er 20 minutter for en bestemt type service. En kunde mistenker at det tar lengre tid, og får tilgang til 28 tilfeldige registrerte tider. Utvalget gir minutter og minutter.
Sett opp og .
Finn standardfeilen.
Regn ut .
Finn p-verdien og konkluder.
Hvilket forbehold bør nevnes om ?
| er sann | er usann | |
|---|---|---|
| vi forkaster | type I-feil (falsk alarm) | riktig |
| vi beholder | riktig | type II-feil (bom) |
Type I-feil: vi roper varsku om noe som ikke er der. Sannsynligheten for dette er nøyaktig signifikansnivået:
Type II-feil: det er en virkelig effekt, men testen oppdager den ikke. Sannsynligheten kalles :
Styrken til testen er sannsynligheten for å oppdage en effekt som virkelig er der:
NB: velger vi selv. kan vi ikke velge — den avhenger av hvor stor den virkelige effekten er, hvor mange vi måler, og hvilket vi valgte. Og den kan bare regnes ut hvis vi sier hvilken alternativ verdi vi tenker på.
En maskin skal fylle 500 ml. Standardavviket er ml. Kvalitetskontrollen tester mot med flasker og .
a) Finn forkastningsområdet i ml.
b) Hva er sannsynligheten for type I-feil?
c) Anta at maskinen i virkeligheten fyller ml. Finn og styrken.
d) Gjør det samme for ml.
a) Standardfeilen:
Venstresidig test på 5 %-nivå gir kritisk :
Vi forkaster hvis ml.
b) . Er maskinen riktig innstilt, vil kontrollen likevel slå alarm i 5 % av tilfellene — omtrent hver tjuende gang.
c) Nå antar vi at er sann. Da er normalfordelt om 495, fortsatt med standardavvik 2. Type II-feil betyr at vi ikke forkaster, altså at havner over grensen:
Vi standardiserer — nå med 495 i midten:
Fyller maskinen 495 ml, oppdager kontrollen det altså i omtrent 80 % av tilfellene — og overser det i 20 %.
d) Med :
Et avvik på 2 ml oppdages altså bare i omtrent hvert fjerde tilfelle.
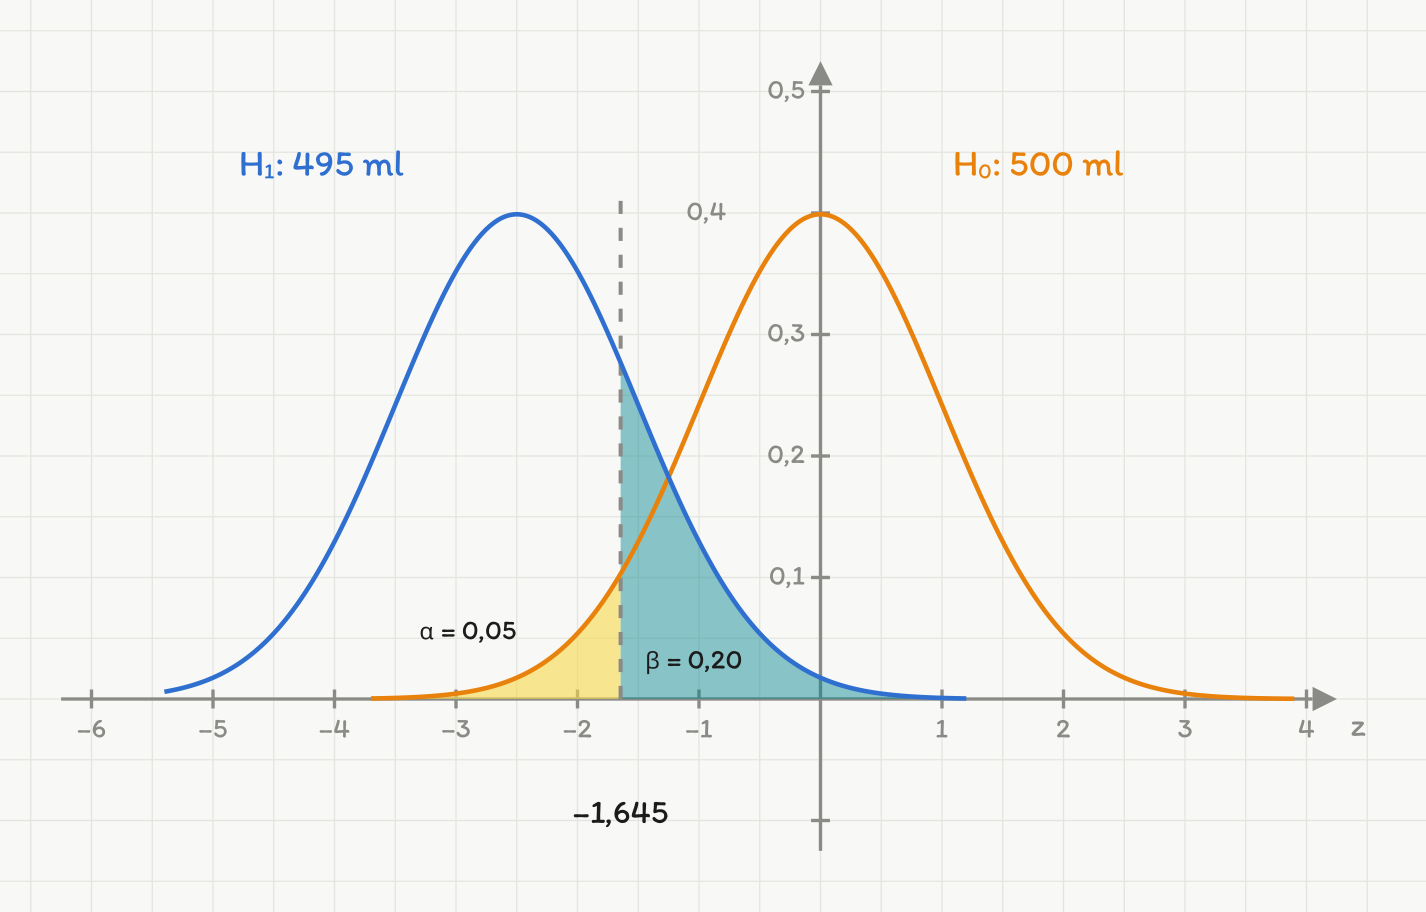
De to feiltypene i samme bilde. Aksen måler standardfeil fra 500 ml, så forkastningsgrensen 496,7 ml står som . Gult areal er : sannsynligheten for å slå alarm når maskinen er riktig innstilt. Turkist areal er : sannsynligheten for å overse at maskinen fyller 495 ml. Flytter vi linja mot venstre, krymper og vokser — de to kan ikke reduseres samtidig uten å måle flere flasker.
Svar: a) ml. b) 0,05. c) , styrke . d) , styrke .
Hva dette betyr i praksis: testen er god til å oppdage store avvik og nesten blind for små. Det er derfor «testen fant ingen feil» aldri betyr «maskinen er riktig innstilt» — det kan like gjerne bety at avviket var for lite for denne testen å se.
En pakkemaskin skal fylle 250 gram. Standardavviket er gram. Kontrollen tester mot med pakker og .
Finn standardfeilen og forkastningsområdet i gram.
Hva er sannsynligheten for type I-feil?
Finn og styrken hvis maskinen i virkeligheten fyller 252 gram.
Finn styrken hvis maskinen fyller 253 gram.
Forklar hvorfor styrken vokser når det virkelige avviket vokser.
Vi fortsetter med fyllmaskinen (, , ensidig test, ).
a) Sett opp en tabell over styrken for , 100 og 400, mot de sanne verdiene , 497, 496 og 495.
b) Hva skjer med hvis vi setter i stedet, med og sann ?
c) Oppsummer hva styrken avhenger av.
a) For hver regner vi først grensen , og deretter for hver sanne :
| grense | |||||
|---|---|---|---|---|---|
| 36 | 496,71 | 0,26 | 0,44 | 0,64 | 0,80 |
| 100 | 498,03 | 0,51 | 0,80 | 0,95 | 0,99 |
| 400 | 499,01 | 0,95 | 1,00 | 1,00 | 1,00 |
Les tabellen på to måter. Bortover: med fast vokser styrken når avviket vokser. Nedover: med fast avvik vokser styrken når vokser.
b) Med blir kritisk lik 2,326, og grensen flyttes til
Med sann :
Styrken faller fra 0,64 til 0,37. Å gjøre mindre gjør større.
c) Styrken avhenger av tre ting:
1. Effektstørrelsen — hvor langt den sanne verdien er fra . Store avvik er lette å se.
2. Utvalgsstørrelsen — flere målinger krymper og skiller fordelingene bedre.
3. Signifikansnivået — strengere krav mot falsk alarm gir flere oversette effekter.
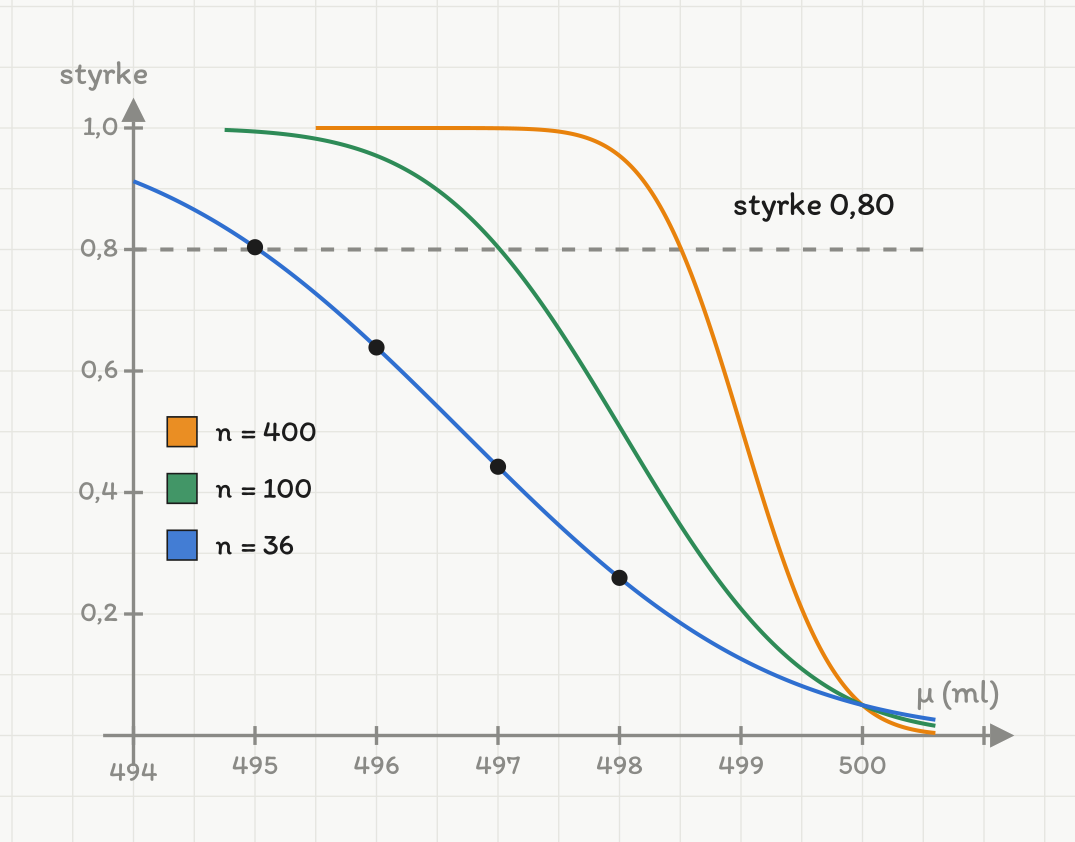
Styrken mot den sanne . Tre ting leses av på én gang: styrken vokser når avviket fra 500 blir større (til venstre), den vokser med (kurvene stiger med utvalgsstørrelsen), og alle tre ender i når faktisk er 500. Punktene på den blå kurven er tallene i tabellen over. Kurvene for og er tegnet fra det punktet der de skiller seg fra 1,00 — lenger til venstre ligger de pikselvis oppå hverandre.
Svar: a) Se tabellen. b) vokser fra 0,36 til 0,63, styrken faller fra 0,64 til 0,37. c) Effektstørrelse, utvalgsstørrelse og .
NB: Bare én av de tre gir forbedring uten motytelse, og det er . og er en byttehandel; flere målinger er den eneste måten å redusere begge på samtidig.
Vi fortsetter med pakkemaskinen fra oppgave 2: , , ensidig test på 5 %-nivå, og vi er interessert i å oppdage et avvik til gram.
Finn styrken med .
Finn styrken med .
Hvor mange pakker trengs for styrke minst 0,80?
Hvor mange pakker trengs for styrke minst 0,90?
Bedriften vil ha «rimelig sikkerhet» for å oppdage et avvik på 2 gram, men kan bare kontrollere 25 pakker. Hva bør de få vite?
Valget av er ikke et matematisk spørsmål, men et spørsmål om konsekvenser. Vurder hva type I- og type II-feil betyr i disse tre situasjonene, og hvilket signifikansnivå du ville valgt.
a) En brannalarm.
b) Godkjenning av et nytt legemiddel.
c) En nettbutikk tester om en ny knappefarge gir flere kjøp.
a) Brannalarm. : det brenner ikke.
- Type I-feil: alarmen går uten brann. Irriterende, men ufarlig.
- Type II-feil: det brenner, og alarmen tier. Katastrofalt.
Her vil vi ha svært liten , og godtar en stor . Derfor er brannalarmer stilt inn så følsomt at de går av når noen brenner brødskiver.
b) Legemiddel. : medisinen virker ikke bedre enn dagens behandling.
- Type I-feil: vi godkjenner en medisin som ikke virker. Pasienter får bivirkninger uten nytte, og en virksom behandling kan bli erstattet.
- Type II-feil: vi avviser en medisin som faktisk virker. Også alvorlig, men den kan prøves på nytt senere.
Her settes lavt, ofte 0,01 eller lavere, og man kompenserer for den økte ved å kreve store studier.
c) Knappefarge. : fargen har ingen effekt.
- Type I-feil: de bytter farge uten grunn. Koster nesten ingenting.
- Type II-feil: de beholder en dårligere farge. Koster også lite.
Her kan være helt forsvarlig. Ingen kommer til skade av en knapp.
Svar: a) Type II er verst — velg stor (følsom alarm). b) Type I er alvorligst — velg liten , og kompenser med stort utvalg. c) Begge feilene er billige — er greit.
Regelen bak alle tre: sett lavt når falsk alarm er dyrt, og sørg for stort nok utvalg når det å overse noe er dyrt. Statistikken gir deg tallene; hva de er verdt, må du avgjøre selv.
En siste ting å legge merke til: i alle tre tilfellene er satt til «det skjer ingenting». Det er ikke tilfeldig. Testen er bygget slik at det kreves holdepunkter for å påstå at noe skjer — den som hevder noe nytt, har bevisbyrden.
Beskriv hva type I-feil og type II-feil betyr i hver situasjon, og si hvilken som er mest alvorlig.
En kvalitetskontroll tester : «partiet holder kravene» mot : «partiet holder ikke kravene».
En rettssak, med : «tiltalte er uskyldig».
En screeningtest for sykdom, med : «pasienten er frisk».
En skole tester om et nytt leseopplegg virker, med : «ingen effekt».
I hvilke av tilfellene a)–d) bør settes lavere enn 0,05, og i hvilke bør man heller øke utvalget?
2. Mange tester, ett funn. Tester du 20 ting på 5 %-nivå, får du i gjennomsnitt én forkastning selv om ingenting er sant — og sannsynligheten for minst én er . Fortell hvor mange tester du gjorde.
3. Utvalget er ikke tilfeldig. De som svarer på en undersøkelse, er sjelden et tverrsnitt. Feilmarginer og p-verdier måler bare tilfeldig variasjon — de retter ikke opp skjevt utvalg, uansett hvor stort det er.
4. Signifikant forveksles med viktig. Med stort nok blir enhver ørliten forskjell signifikant. Oppgi alltid størrelsen på effekten, med konfidensintervall.
5. «Ingen signifikans» tolkes som «ingen effekt». Var styrken lav, ville testen ikke funnet effekten selv om den fantes. Regn ut styrken før du konkluderer med at noe ikke virker.
Alle fem er lette å unngå med én vane: skriv ned problemstilling, hypoteser, og utvalgsstørrelse før du ser på dataene — og hold deg til det du skrev.
Les de fem korte beskrivelsene, og pek på hvilken av fellene fra ramma over som gjør seg gjeldende.
«Vi undersøkte 18 ulike sammenhenger i datasettet, og fant én signifikant på 5 %-nivå.»
«Med 50 000 svar fant vi at gruppe A svarte 0,03 poeng høyere enn gruppe B ().»
«Vi la ut spørreskjemaet på nettsiden vår, og 4200 svarte.»
«Testen ga med 14 deltakere, så metoden har ingen effekt.»
«Da vi så at gutta skåret høyest, satte vi opp : gutter skårer høyere enn jenter.»
Oppsummering
- På ekte data er de tre første skrittene de avgjørende: problemstilling, hypoteser og bestemmes før dataene ses.
- Type I-feil: forkaste en sann (falsk alarm). Sannsynligheten er — den vi velger selv.
- Type II-feil: beholde en usann (oversett effekt). Sannsynligheten er , og den regnes mot en bestemt alternativ verdi.
- Styrken er sannsynligheten for å oppdage en effekt som virkelig er der. Den vokser med effektstørrelsen, med , og med .
- regnes ved å standardisere forkastningsgrensen med den sanne i midten.
- og trekker mot hver sin kant. Bare flere målinger reduserer begge.
- Valget av er et spørsmål om konsekvenser, ikke om matematikk.
- Normalfordeling er et krav til gjennomsnittet, ikke til dataene. Sentralgrensesetningen ordner resten når er stor nok.
- Konklusjonen skrives i kontekst, med p-verdi, konfidensintervall og forbehold om hvordan dataene ble samlet inn.
Dette er siste kapittel i seksjon 7. I seksjon 8 skal du planlegge og gjennomføre din egen undersøkelse — og da er nettopp rekkefølgen i dette kapittelet arbeidsplanen din.
| 15 200 | 17 800 | 14 300 | 19 100 | 16 500 |
| 13 900 | 18 400 | 15 700 | 20 200 | 14 800 |
| 17 200 | 16 100 | 12 700 | 18 900 | 15 400 |
| 19 600 | 13 400 | 17 500 | 16 800 | 14 100 |
| 20 800 | 15 900 | 18 200 | 13 100 | 17 900 |
| 16 300 | 14 600 | 19 300 | 15 100 | 18 700 |
| 12 900 | 17 100 | 16 600 | 14 400 | 19 800 |
| 15 600 | 18 000 | 13 700 | 17 400 | 16 000 |
| 21 300 | 14 900 | 18 600 | 15 300 | 17 700 |
Gjennomfør hele undersøkelsen i regneark.
Sett opp problemstilling, hypoteser og signifikansnivå — før du regner.
Finn , og standardfeilen.
Regn ut og den ensidige p-verdien, og konkluder på 5 %-nivå.
Regn også den tosidige p-verdien og 95 %-intervallet. Hva legger du merke til?
Finn forkastningsgrensen i kWh, og regn styrken mot en sann på 17 000 kWh. Skriv til slutt en kort konklusjon med forbehold.
Tjue forskergrupper undersøker samme påstand uavhengig av hverandre. Påstanden er usann. Hvor mange grupper får signifikant resultat på 5 %-nivå, og hvilke av dem blir publisert?
Hvordan kan man gardere seg mot problemet i a) når man selv gjør mange tester? Regn ut det justerte nivået for 20 tester med samlet risiko 5 %.
«Undersøkelsen vår hadde 5 000 deltakere, så resultatet er sikkert.» Drøft hva stort utvalg gir og ikke gir.
En kommune tester hver måned om innbyggertilfredsheten har endret seg, på 5 %-nivå. Hva vil skje over noen år, selv om tilfredsheten er helt stabil?
En elev skriver: «Vi beholdt , så vi har vist at det ikke er noen forskjell.» Skriv om til en riktig konklusjon, og forklar hva eleven må regne ut for å kunne si noe mer.
Dette kapitlet er skrevet av Anthropics toppmodeller (Claude Opus og Claude Fable) og er foreløpig ikke manuelt gjennomgått — kvalitetskontrollen gjøres av uavhengige KI-agenter, og innmeldte feil rettes fortløpende. Funnet en feil? Meld fra, så retter vi den. Les mer om hvordan innholdet lages.