
Hypotesetest for en andel, binomisk og med normaltilnærming.
Test av en andel
I kapittel 7.4 testet vi andeler med den binomiske fordelingen og regnet p-verdien som en hale i den. I kapittel 7.5 testet vi gjennomsnitt med normalfordelingen og en testobservator .
For andeler har vi begge veiene åpne, og dette kapittelet handler om å velge riktig:
| metode | når | p-verdi |
|---|---|---|
| eksakt binomisk | alltid gyldig, men tungvint for hånd ved stor | hale i binomisk fordeling |
| normaltilnærming | når og | hale i normalfordelingen |
Den eksakte metoden er alltid riktig. Normaltilnærmingen er en snarvei som blir god når utvalget er stort nok — og vi skal måle hvor stor forskjellen faktisk er.
Merk deg allerede nå ett punkt: når vi tester, regner vi standardfeilen med fra nullhypotesen, ikke med fra dataene. Det er den eneste stedet der testen skiller seg fra konfidensintervallet i kapittel 7.3.
Når er sann og og , er tilnærmet standard normalfordelt. p-verdiene finnes som i kapittel 7.5:
| p-verdi | |
|---|---|
Den eksakte binomiske p-verdien regnes direkte på antallet , under :
NB — hvorfor og ikke i nevneren? Hele testen bygger på spørsmålet «hvis er sann, hvor rart er dette?». Da må også spredningen regnes ut fra . I konfidensintervallet finnes det ingen — der er det eneste vi har.
Et apotek lover at 90 % av kundene er ekspedert innen fem minutter. En kontroll av 30 tilfeldige kunder viser at 22 ble ekspedert i tide.
a) Sett opp hypoteser.
b) Kontroller om normaltilnærmingen kan brukes.
c) Finn den eksakte p-verdien og konkluder på 5 %-nivå.
d) Hvor galt hadde det gått med normaltilnærmingen?
a) Kontrollen er ute etter om løftet ikke holdes:
b) Under :
Den andre betingelsen svikter. Normaltilnærmingen kan altså ikke brukes her, og vi må regne eksakt.
c) Under er antall kunder ekspedert i tide binomisk fordelt med og . Forventet antall er 27; vi observerte 22.
regneark: =BINOM.FORDELING.N(22;30;0,9;SANN) gir 0,0078forkastes.
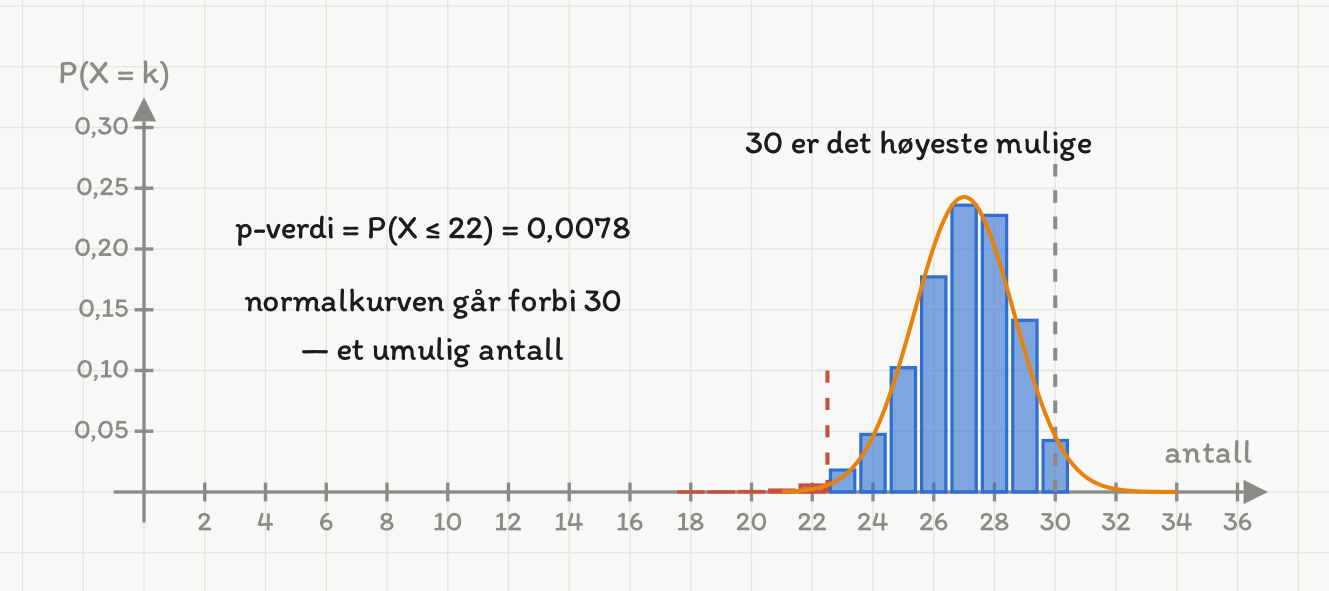
Her svikter normaltilnærmingen. Med og er , altså langt under 5, og fordelingen er presset opp mot 30. Normalkurven fortsetter forbi 30 og gir sannsynlighet til antall som ikke finnes. Alt til venstre for den røde streken er -verdien; søylene der er for lave til å ses.
Konklusjon i kontekst: Kontrollen gir grunnlag for å si at apoteket ekspederer færre enn 90 % av kundene innen fem minutter. Holdt løftet, ville 22 eller færre i tide forekommet i under 1 av 100 kontroller.
d) Regner vi likevel med normaltilnærmingen:
Det er 0,0012 mot 0,0078 — snarveien gir en p-verdi som er over seks ganger for liten. Konklusjonen blir riktignok den samme her, men i et grensetilfelle ville den vært feil.
Svar: a) mot . b) Nei — . c) , forkastes. d) Normaltilnærmingen gir 0,0012, altså over seks ganger for lite.
NB: Betingelsen er ikke en formalitet man kan hoppe over når tallene er nesten store nok. Det er nettopp i halene — der p-verdiene bor — at tilnærmingen er dårligst.
Gjør den samme utregningen som i eksempel 1. Erfaring viser at 60 % av pasientene blir bedre av en standardbehandling. En ny behandling prøves på 15 pasienter, og 13 blir bedre.
Sett opp og .
Hvor mange ville vi ventet under ?
Finn den eksakte p-verdien.
Konkluder på 5 %-nivå og på 1 %-nivå.
Regn også normaltilnærmingen, og sammenlign. Hvilken bør oppgis?
På landsbasis sykler 5 % av de yrkesaktive til jobb. En kommune som har satset på sykkelveier, spør 600 tilfeldig valgte yrkesaktive innbyggere, og 42 sier de sykler til jobb.
a) Sett opp hypoteser og kontroller forutsetningen.
b) Regn ut og finn p-verdien.
c) Konkluder på 5 %-nivå og på 1 %-nivå.
d) Sammenlign med den eksakte binomiske p-verdien.
Hva vet vi? , , .
a) Kommunen vil vise at andelen er høyere:
Forutsetningen, regnet under :
Normaltilnærmingen kan brukes.
b) Estimatet:
Standardfeilen under — altså med , ikke med 0,07:
Testobservatoren:
p-verdien:
c) På 5 %-nivå: — forkastes. På 1 %-nivå: — beholdes.
Konklusjon i kontekst: På 5 %-nivå gir undersøkelsen grunnlag for å si at andelen som sykler til jobb, er høyere i kommunen enn de 5 prosentene på landsbasis.
d) Den eksakte binomiske p-verdien er
mot normaltilnærmingens 0,0122. Begge gir forkastning på 5 %-nivå, men den eksakte er nesten 60 % større. Tilnærmingen er altså litt for rask til å forkaste — noe den ofte er når ligger nær 0 eller 1.
Svar: a) mot ; forutsetningen er oppfylt. b) og . c) Forkast på 5 %-nivå, behold på 1 %-nivå. d) Eksakt: 0,0193 — samme konklusjon, men større p-verdi.
fordi det er akkurat den standardfeilen vi brukte i konfidensintervallet i kapittel 7.3. Men i en test regner vi under , og da hører også spredningen til .
| standardfeil | hvorfor | |
|---|---|---|
| konfidensintervall | vi har ingen — bare dataene | |
| hypotesetest | alt regnes som om var sann |
I eksempel 2 ville feilen gitt i stedet for 0,0089, og dermed i stedet for 2,25 — p-verdi 0,027 i stedet for 0,012. Samme konklusjon her, men feil tall, og i et grensetilfelle feil svar.
Huskeregel: Testen låner alt fra nullhypotesen. Intervallet låner alt fra dataene.
En kommune har tidligere målt at 60 % av innbyggerne kildesorterer riktig. Etter en informasjonskampanje kontrollerer de 400 tilfeldige husholdninger, og 268 sorterer riktig.
Sett opp og , og kontroller forutsetningen.
Finn og standardfeilen under .
Regn ut .
Finn p-verdien og konkluder på 1 %-nivå.
Finn den eksakte binomiske p-verdien og sammenlign.
Vi planlegger sykkelundersøkelsen fra eksempel 2 på nytt: og mot , på 5 %-nivå.
a) Finn forkastningsområdet uttrykt i .
b) Gjør det om til antall syklister.
c) Finn det eksakte forkastningsområdet med den binomiske fordelingen, og sammenlign.
a) Kritisk for ensidig test på 5 %-nivå er 1,645. Da er grensen
Forkastningsområdet er , altså 6,46 % eller mer.
b) Vi ganger med :
Siden antall syklister er et helt tall, forkastes ved 39 eller flere syklister.
c) Eksakt regning gir
| 38 | 39 | 40 | 41 | |
|---|---|---|---|---|
| 0,0836 | 0,0599 | 0,0420 | 0,0288 |
Den minste som gir sannsynlighet under 5 %, er 40. Det eksakte forkastningsområdet er altså , mens tilnærmingen sa 39.
Forskjellen er én person. Ved er den virkelige sannsynligheten 0,0599 — altså er den «5 %-testen» tilnærmingen foreslår, i virkeligheten en 6 %-test.
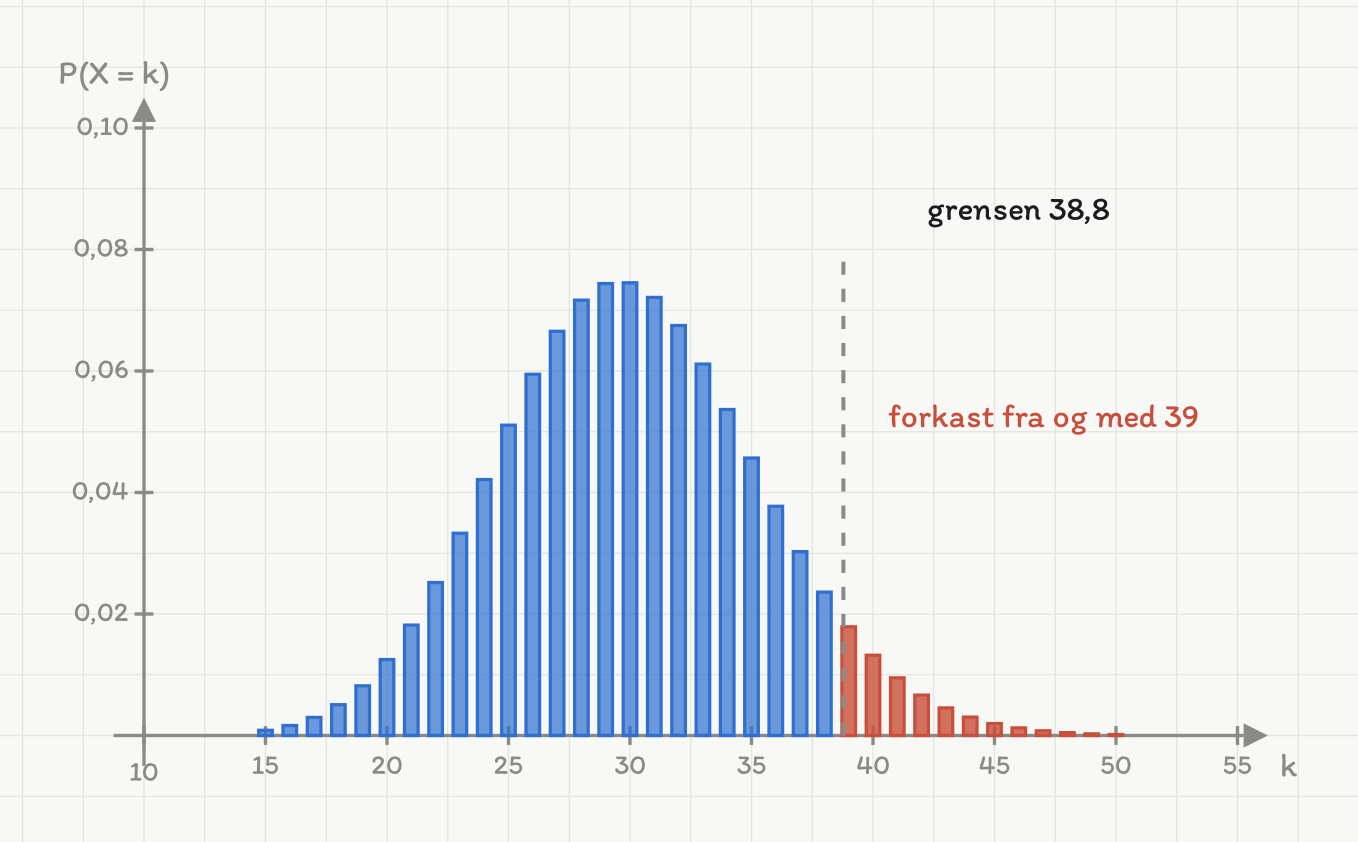
Grensen ligger mellom to hele tall. Antallet kan bare være et helt tall, så forkastningsområdet må starte ved 39 — og da blir den virkelige sannsynligheten for å forkaste litt mindre enn 5 %. Det er derfor en test på et diskret antall sjelden treffer signifikansnivået eksakt.
Svar: a) . b) 39 eller flere syklister. c) Eksakt: 40 eller flere. Tilnærmingen bommer med én observasjon, og gir et faktisk signifikansnivå på 6,0 % i stedet for 5 %.
NB: Sprang som dette er uunngåelige med en diskret fordeling. Antall syklister er et helt tall, og da finnes det sjelden en grense som treffer akkurat 5 %. Det faktiske signifikansnivået blir derfor ofte litt lavere enn det vi ba om — her 4,2 % i stedet for 5 %.
En nettbutikk vil undersøke om andelen kunder som velger et abonnement framfor et engangskjøp, har endret seg fra de vanlige 50 %. De ser på 400 tilfeldige kjøp, og 176 er abonnement.
Sett opp og , og si om testen er ensidig eller tosidig.
Finn og standardfeilen under .
Regn ut og finn den tosidige p-verdien.
Konkluder på 5 %-nivå, i kontekst.
Regn 95 % konfidensintervallet for , og vis at det gir samme konklusjon. Legg merke til hvilken standardfeil du bruker her.
Vi bruker tallene fra eksempel 2: , , mot .
a) Sett opp regnearket som gir begge p-verdiene.
b) Gjør det samme i GeoGebra.
c) Hvilken p-verdi bør rapporteres?
a) Vi legger inn de tre tallene og bygger videre:
A1: 600       (n)
A2: 42        (x)
A3: 0,05      (p0)

A4: =A2/A1                       gir 0,07       (p-hatt)
A5: =ROT(A3*(1-A3)/A1)           gir 0,008898   (SE under H0)
A6: =(A4-A3)/A5                  gir 2,2478     (z)
A7: =1-NORM.S.FORDELING.N(A6;SANN) gir 0,01229    (normaltilnærming)
A8: =1-BINOM.FORDELING.N(A2-1;A1;A3;SANN)
                                 gir 0,01933    (eksakt binomisk)
Legg merke til A2-1 i den siste: BINOM.FORDELING.N(...;SANN) gir , så er .
b) I GeoGebra:
FordelingBinomial(600, 0.05, 41, true)     gir 0.98067
1 - 0.98067                                gir 0.01933
c) Den eksakte verdien 0,0193. Den er riktig uansett utvalgsstørrelse, og verktøyet regner den like raskt som tilnærmingen. Normaltilnærmingen hører hjemme på Del 1, der vi bare har tabellen — og der er -veien den eneste farbare.
Svar: a) NORM.S.FORDELING for tilnærmingen, BINOM.FORDELING.N for den eksakte. b) FordelingBinomial(600, 0.05, 41, true) og trekk fra 1. c) Den eksakte, 0,0193.
NB — en god vane: oppgi alltid hvilken metode du har brukt. « (eksakt binomisk)» og « (normaltilnærming)» er to forskjellige opplysninger om de samme dataene, og leseren har krav på å vite hvilken av dem hun ser.
Avgjør for hvert tilfelle om normaltilnærmingen kan brukes, eller om testen må gjøres eksakt binomisk. Regn og hver gang.
Formuler med egne ord når normaltilnærmingen svikter.
En kinokjede har erfart at 25 % av gjestene kjøper mat i kiosken. Etter en ny meny vil de teste mot på 5 %-nivå, med gjester.
Hvor mange kjøp ville vi ventet under ?
Finn standardfeilen under .
Finn forkastningsområdet uttrykt i , og gjør det om til antall.
Kontroller grensen eksakt: regn og .
Kjeden observerer 58 kjøp. Hva blir konklusjonen, og hva ville du rådet dem til?
Oppsummering
- Testobservator for en andel:
- Standardfeilen regnes med , ikke med — alt i en test regnes som om var sann. Konfidensintervallet bruker derimot .
- Forutsetning for normaltilnærming: og . Det er den minste av dem som avgjør, og stor redder ikke en nær 0 eller 1.
- Eksakt binomisk p-verdi er alltid riktig: eller under , regnet med BINOM.FORDELING.N.
- Tilnærmingen gir for små p-verdier når fordelingen er skjev — i eksempel 1 var 0,0012 mot eksakte 0,0078.
- Forkastningsområdet kan skrives i eller i antall. Fordi antallet er et helt tall, treffer testen sjelden signifikansnivået eksakt.
- p-verdier oppgis med metoden: « (eksakt binomisk)».
I kapittel 7.7 setter vi alt sammen på et reelt datasett, og ser på de to feilene en test kan gjøre.
Sett opp hypotesene, og begrunn ensidig eller tosidig.
Finn , standardfeilen under og .
Finn den tosidige p-verdien og konkluder på 5 %-nivå.
Regn 95 % konfidensintervallet for , og vis at det stemmer med konklusjonen i c).
Hvor stort måtte utvalget vært for at det samme avviket (2,13 prosentpoeng) skulle blitt signifikant på 5 %-nivå? Drøft om kommunen bør spørre så mange.
Et avvik på ett prosentpoeng fra . Regn og tosidig p-verdi for , og .
Hvor stort må være for at ett prosentpoeng skal bli signifikant (tosidig, 5 %)?
«Vi testet med og fikk ikke signifikans, så det er ingen forskjell.» Hva er feilen?
En bedrift tester (andel defekte) med . Er testen brukbar?
To aviser melder om samme undersøkelse. Den ene skriver «signifikant økning ()», den andre «økningen var på 1,2 prosentpoeng, fra 23,0 % til 24,2 %». Hvilken opplysning er mest nyttig, og hvorfor?
Dette kapitlet er skrevet av Anthropics toppmodeller (Claude Opus og Claude Fable) og er foreløpig ikke manuelt gjennomgått — kvalitetskontrollen gjøres av uavhengige KI-agenter, og innmeldte feil rettes fortløpende. Funnet en feil? Meld fra, så retter vi den. Les mer om hvordan innholdet lages.