
Nullhypotese, alternativ hypotese, signifikansnivå og p-verdi forklart fra bunnen av.
Hypotesetesting — grunnideen
En kafé påstår at baristaen kan kjenne forskjell på to kaffetyper bare ved å smake. Vi lar henne prøve ti ganger, uten å se hva hun får. Hun treffer ni av ti.
Hva nå? To forklaringer står mot hverandre:
- Hun gjettet, og var heldig.
- Hun kan det, og ni av ti er resultatet av ekte ferdighet.
Matematikken kan ikke velge for oss. Men den kan svare på ett presist spørsmål, og det er hele hypotesetestingen:
Hvis hun bare gjettet — hvor sannsynlig var det da å få ni eller flere riktige?
Er det svaret stort, er ni riktige ikke noe å heve øyenbrynene over. Er svaret lite, må vi enten tro at noe svært usannsynlig har skjedd, eller forkaste antakelsen om at hun gjettet.
Legg merke til tankegangen: vi regner på den kjedelige forklaringen, ikke på den spennende. Det er en variant av et kjent grep fra matematikken — vi antar det motsatte av det vi tror, og ser om antakelsen fører til noe urimelig.
Den alternative hypotesen er påstanden vi vil undersøke om det er dekning for.
I kaffeeksempelet:
Tre regler for oppsettet:
1. inneholder alltid et likhetstegn — ellers har vi ikke noe tall å regne med.
2. er det vi vil vise. Den kommer fra spørsmålet, ikke fra dataene.
3. Hypotesene settes opp før vi ser resultatet.
Regel 3 er ikke en formalitet. Lager du hypotesen etter at du har sett tallene, kan du alltid finne noe som ser oppsiktsvekkende ut — og da tester du ingenting.
Baristaen får ti kopper i tilfeldig rekkefølge og skal si hvilken type hver av dem er. Hun treffer på 9 av 10.
a) Sett opp og .
b) Regn ut sannsynligheten for å få minst 9 riktige hvis hun bare gjetter.
c) Konkluder på 5 % signifikansnivå.
d) Hva om hun hadde truffet 8 av 10?
a) La være sannsynligheten for at hun treffer på en enkelt kopp.
b) Vi regner under , altså som om hun gjetter. Da er antall riktige binomisk fordelt med
Vi skal finne , altså «9 eller 10 riktige»:
(Her er nevneren den samme i alle leddene fordi uansett . Det gjør til det enkleste tilfellet å regne for hånd.)
c) Dette tallet kalles p-verdien. Den er 0,0107, altså omtrent 1 %.
Vi sammenligner med signifikansnivået:
Hadde hun gjettet, ville et resultat som dette (eller bedre) forekommet i bare omtrent 1 av 100 forsøk. Vi forkaster og konkluderer med at hun ser ut til å kunne smake forskjell.
d) Med 8 riktige:
Nå er . Vi beholder — resultatet er ikke overraskende nok på 5 %-nivå.
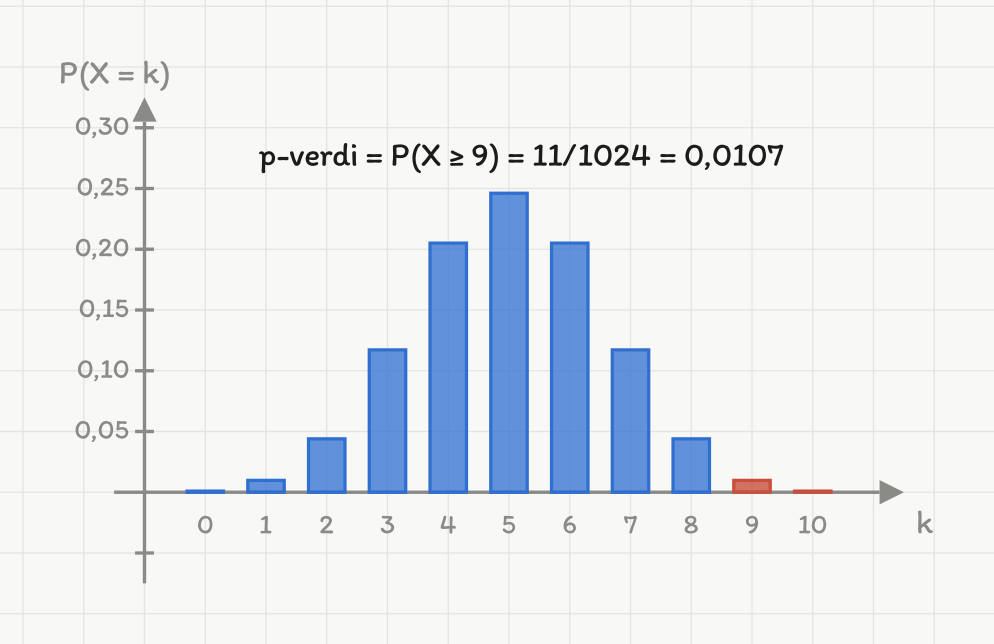
-verdien er en hale i fordelingen. Under gjetter baristaen, og da er antall riktige binomisk fordelt med og . De to røde søylene er alt som er minst like ekstremt som det observerte: . Legg merke til hvor lite det området er sammenlignet med resten.
Svar: a) mot . b) . c) forkastes på 5 %-nivå. d) , så beholdes.
NB: Legg merke til hvor tett d) ligger på grensen. Én kopp til eller fra snur konklusjonen. Det betyr ikke at 9 riktige er «bevis» og 8 riktige er «ingenting» — det betyr at 10 forsøk er et tynt grunnlag, og at grensen 5 % er et valg vi har gjort, ikke en naturlov.
Gjør den samme utregningen som i eksempel 1. En elev mistenker at en mynt ikke er rettferdig. Hun kaster den 20 ganger og får kron 15 ganger.
Sett opp og når hun mistenker at mynten gir kron for ofte.
Hvor mange kron ville vi ventet under ?
Finn p-verdien, altså under .
Konkluder på 5 % signifikansnivå.
Hva er det minste antall kron som ville gitt forkastning på 5 %-nivå?
p-verdien er sannsynligheten for å få et resultat minst så ekstremt som det vi observerte, gitt at er sann.
Konklusjonsregelen:
| forkast — resultatet er signifikant på nivået | |
| behold — ikke grunnlag for å forkaste |
En hypotesetest føres alltid i de samme fem skrittene:
1. Sett opp og .
2. Velg signifikansnivå .
3. Regn ut p-verdien under .
4. Sammenlign med .
5. Skriv konklusjonen i oppgavens kontekst — ikke bare « forkastes».
2. «Behold » betyr ikke at er bevist. Det betyr at dataene ikke er sterke nok til å forkaste den. Åtte av ti riktige beviser ikke at baristaen gjetter; vi har bare ikke nok grunnlag til å si at hun ikke gjør det. Fravær av bevis er ikke bevis for fravær.
3. Den sier ingenting om hvor stor effekten er. Med et enormt utvalg kan en helt ubetydelig forskjell få en bitteliten p-verdi. Statistisk signifikant er ikke det samme som viktig. Konfidensintervallet i kapittel 7.2 og 7.3 sier noe om størrelsen; p-verdien gjør ikke det.
4. Grensen 0,05 er ikke magisk. En p-verdi på 0,049 og en på 0,051 er omtrent like overraskende. Konklusjonene «forkast» og «behold» er derimot forskjellige — det er prisen for å ha en fast beslutningsregel, og en grunn til alltid å oppgi selve p-verdien og ikke bare dommen.
En leverandør garanterer at høyst 5 % av enhetene er defekte. En kunde kontrollerer 200 tilfeldige enheter og finner 16 defekte.
a) Sett opp hypoteser.
b) Hvor mange defekte ville vi ventet under ?
c) Finn p-verdien.
d) Konkluder på 5 %-nivå, og skriv konklusjonen i kontekst.
a) La være andelen defekte i produksjonen.
Garantien «høyst 5 %» blir til likhetstegnet i — vi regner i det verste tilfellet garantien tillater.
b) Under er antall defekte binomisk fordelt med og :
Vi observerte 16. Det er 6 mer enn ventet — men er det mye? Standardavviket under er
Avviket er altså omtrent to standardavvik. Det er mye, men ikke ekstremt — vi må regne.
c) p-verdien er sannsynligheten for 16 eller flere defekte under :
regneark: =1-BINOM.FORDELING.N(15;200;0,05;SANN) gir 0,0444d) Vi sammenligner:
forkastes på 5 %-nivå.
Konklusjon i kontekst: Kontrollen gir grunnlag for å si at andelen defekte er høyere enn de garanterte 5 %. Hadde leverandøren holdt garantien, ville en kontroll som denne gitt 16 eller flere defekte i bare omtrent 4 av 100 tilfeller.
Svar: a) mot . b) 10 defekte. c) . d) forkastes — dataene taler for at mer enn 5 % er defekte.
NB: Legg merke til hvor nær grensen vi er. På 1 %-nivå ville vi beholdt , siden . Signifikansnivået må derfor velges før vi regner — ellers blir valget en måte å få det svaret man vil ha.
En frøprodusent skriver på pakken at 80 % av frøene spirer. En gartner sår 50 frø og får 44 til å spire. Han mener pakken underdriver.
Sett opp og .
Hvor mange spirte frø ville vi ventet under ?
Finn p-verdien.
Konkluder på 5 %-nivå, i kontekst.
Hvor mange frø måtte spirt for at han skulle fått forkastet på 5 %-nivå?
Forkastningsområdet — samme avgjørelse, motsatt vei
I eksempel 2 regnet vi p-verdien og sammenlignet med . Det finnes en annen vei til nøyaktig samme konklusjon: å finne på forhånd hvilke resultater som skal føre til forkastning.
Den mengden av utfall kalles forkastningsområdet. For leverandørkontrollen finner vi den ved å lete oppover:
| 14 | 15 | 16 | 17 | |
|---|---|---|---|---|
| 0,1299 | 0,0781 | 0,0444 | 0,0238 |
Det minste antallet som gir sannsynlighet under 5 %, er 16. Forkastningsområdet er altså
Bestemmer vi dette før kontrollen, trenger vi ikke regne noen p-verdi etterpå — vi teller bare, og ser om tallet havner i området.
De to veiene gir alltid samme svar:
| p-verdi-metoden | forkastningsområde-metoden | |
|---|---|---|
| regner | hvor sjeldent resultatet er | hvilke resultater som er sjeldne nok |
| sammenligner | p-verdi mot | observasjonen mot grensen |
| brukes helst | når vi har tallet og skal vurdere det | når vi planlegger testen på forhånd |
Når vi går over til normalfordelingen i kapittel 7.5, tegnes forkastningsområdet som et areal ute i halen av klokkekurven.
Sett opp og i disse tre situasjonene, og avgjør om testen blir ensidig eller tosidig.
a) En kommune vil undersøke om en ny sykkelvei har ført til flere syklister enn før. Tidligere syklet 18 % av de reisende.
b) Et laboratorium skal kontrollere om en maskin fyller riktig mengde, 500 ml.
c) En skole vil vite om en ny undervisningsmetode gir bedre resultater enn landsgjennomsnittet på 3,4.
a) Spørsmålet er om andelen har økt. Vi bryr oss bare om den ene retningen:
Dette er en ensidig test (høyresidig). Hele legges i den ene halen.
b) Her er både for mye og for lite et problem. Begge avvik teller:
Dette er en tosidig test. Signifikansnivået deles i to, med i hver hale — og det er nettopp derfor grensen blir 1,96 i stedet for 1,645.
c) Spørsmålet er om metoden er bedre:
Ensidig igjen.
Svar: a) , — ensidig. b) , — tosidig. c) , — ensidig.
Hvordan velge? Still deg spørsmålet: ville et avvik den andre veien vært interessant? Ville laboratoriet i b) vært likegyldig til at flaskene inneholdt 530 ml? Nei — da er testen tosidig. Er kommunen i a) interessert i om sykling gikk ned? I denne undersøkelsen ikke, så testen er ensidig.
NB — én ufravikelig regel: valget mellom ensidig og tosidig tas før dataene ses. Å velge ensidig etter at man har sett hvilken vei avviket gikk, halverer p-verdien uten at det er dekning for det, og er en av de vanligste måtene statistikk misbrukes på.
En kjede har målt at 75 % av kundene er fornøyde. Etter en omlegging spør de 80 tilfeldige kunder, og 68 sier de er fornøyde. Ledelsen vil vite om tilfredsheten har gått opp.
Sett opp og , og si om testen er ensidig eller tosidig.
Hvor mange fornøyde ville vi ventet under ?
Finn p-verdien.
Konkluder på 5 %-nivå og på 1 %-nivå.
Finn forkastningsområdet på 5 %-nivå.
En artikkel melder: «Undersøkelsen viser at den nye metoden virker ().» Vurder de fire påstandene en leser kan komme til å trekke ut av dette.
a) «Det er 3 % sannsynlighet for at metoden ikke virker.»
b) «Det er 97 % sannsynlighet for at metoden virker.»
c) «Effekten er stor.»
d) «Hadde metoden ikke virket, ville et slikt resultat vært sjeldent.»
a) Galt. p-verdien er regnet under antakelsen om at metoden ikke virker. Den er en sannsynlighet for dataene gitt , ikke for gitt dataene. Å bytte om på de to er den vanligste feiltolkningen av p-verdier som finnes.
Et bilde som gjør forskjellen tydelig: sannsynligheten for å være våt gitt at det regner, er nær 1. Sannsynligheten for at det regner gitt at du er våt, er noe helt annet — du kan ha vært i dusjen.
b) Galt, av samme grunn. er ikke sannsynligheten for at er sann.
c) Galt. p-verdien sier bare noe om hvor godt dataene taler mot , ikke hvor stor effekten er. Med et stort nok utvalg kan en ørliten forskjell gi . Skal vi vite hvor stor effekten er, trenger vi et konfidensintervall.
d) Riktig. Dette er nettopp definisjonen: hadde vært sann, ville et resultat minst så ekstremt forekommet i omtrent 3 % av forsøkene.
Svar: a) galt, b) galt, c) galt, d) riktig — d) er selve definisjonen av p-verdien.
Hvordan bør setningen vært skrevet? For eksempel slik: «Forskjellen var statistisk signifikant på 5 %-nivå (). Metoden ga i gjennomsnitt 0,4 karakterpoeng bedre resultat, med 95 % konfidensintervall fra 0,05 til 0,75.» Da får leseren både om det er en effekt og hvor stor den er.
Avgjør om hvert utsagn er riktig eller galt, og begrunn kort.
«p-verdien er sannsynligheten for at nullhypotesen er sann.»
«Når vi beholder , har vi vist at er riktig.»
«En p-verdi på 0,001 betyr at effekten er stor.»
«Signifikansnivået skal velges før vi regner p-verdien.»
«Hvis p-verdien er 0,06, kan vi si at resultatet 'nesten var signifikant'.»
Sett opp og i hver situasjon, og si om testen er ensidig eller tosidig. Du skal ikke regne.
En butikk vil undersøke om gjennomsnittlig handlebeløp har endret seg fra fjorårets 412 kr.
En idrettsklubb vil vise at et nytt treningsopplegg gir kortere løpstid enn dagens gjennomsnitt på 14,2 sekunder.
En kommune vil sjekke om andelen som leverer søknader digitalt, fortsatt er 62 %.
En produsent vil vise at mindre enn 2 % av varene er defekte.
En elev har allerede sett at gjennomsnittet i utvalget ble høyere enn 412 kr, og velger derfor i situasjon a). Hva er problemet?
Oppsummering
- En hypotesetest svarer på ett spørsmål: hvor overraskende er dette resultatet hvis ingenting spesielt foregår?
- er antakelsen om ingen effekt, og den inneholder alltid et likhetstegn. er det vi vil undersøke. Begge settes opp før dataene ses.
- p-verdien er sannsynligheten for et minst så ekstremt resultat, regnet under .
- Konklusjonsregelen: gir forkastning, gir at beholdes. Konklusjonen skrives i oppgavens kontekst.
- Forkastningsområdet er de utfallene som gir forkastning. Det bestemmes på forhånd og gir samme svar som p-verdien.
- Ensidig test når bare én retning er interessant, tosidig når begge er det. Ved tosidig test fordeles med halvparten i hver hale.
- p-verdien er ikke sannsynligheten for at er sann, og «behold » er ikke et bevis for .
- p-verdien sier om det er en effekt, ikke hvor stor den er. Konfidensintervallet svarer på det siste.
I kapittel 7.5 gjør vi testen for et gjennomsnitt med normalfordelingen, og i 7.6 for en andel.
En person påstår å kunne gjette riktig oftere enn halvparten av gangene i et forsøk med 12 kast. Vi lar 100 personer som alle bare gjetter, prøve.
Finn p-verdien hvis en person treffer 9 av 12, under .
Finn p-verdien for 10 av 12, og avgjør hvor forkastningsgrensen går på 5 %-nivå.
Lag 100 rader i regneark der hver rad er 12 kast med =TILFELDIGMELLOM(0;1), og summer hver rad. Hvor mange av de 100 radene bør havne i forkastningsområdet?
Trykk F9 noen ganger og se på antallet «vinnere». Hva forteller det om personer som annonserer at de har klart et slikt forsøk?
Regn sannsynligheten for at minst én av 20 uavhengige tester på 5 %-nivå gir forkastning, når er sann i alle.
Et forskningsmiljø tester 20 ulike kosttilskudd mot samme sykdom, alle uten virkning. De publiserer det ene som ga . Drøft.
«Testen viste ingen forskjell mellom de to gruppene, så metodene er like gode.» Hva er feilen?
To forskere tester samme påstand. Den ene får og den andre . Har de funnet forskjellige ting?
En bedrift tester om en ny nettside gir flere kjøp, og velger i stedet for 0,05. Hva er argumentet for og imot?
En elev skriver: «, altså er bevist.» Formuler konklusjonen riktig.
Dette kapitlet er skrevet av Anthropics toppmodeller (Claude Opus og Claude Fable) og er foreløpig ikke manuelt gjennomgått — kvalitetskontrollen gjøres av uavhengige KI-agenter, og innmeldte feil rettes fortløpende. Funnet en feil? Meld fra, så retter vi den. Les mer om hvordan innholdet lages.