
Konfidensintervall for en andel p, og hva utvalgsstørrelsen betyr.
Konfidensintervall for andel
De fleste tallene vi møter i nyhetene, er andeler: hvor mange prosent som stemmer på et parti, som har fullført videregående, som sykler til jobb, som er fornøyde med kommunen sin. Og nesten alltid står det et lite tall bak: feilmarginen er ±3 prosentpoeng.
Dette kapittelet forklarer hvor det tallet kommer fra.
Oppskriften er den samme som i kapittel 7.2 — estimat pluss/minus ganger standardfeil. Det eneste nye er standardfeilen, og den har vi allerede utledet i kapittel 7.1:
Legg merke til at vi må bruke inni rottegnet også — den sanne er jo det vi leter etter.
med de samme -verdiene som før: 1,645 (90 %), 1,96 (95 %) og 2,576 (99 %).
Forutsetningen er at normaltilnærmingen til den binomiske fordelingen kan brukes (kapittel 6.5). Kravet er
Det betyr i praksis: minst fem i hver av de to gruppene. Er en av dem mindre, er utvalget for lite eller andelen for ekstrem til at denne formelen kan brukes.
En kommune spør 1000 tilfeldig valgte innbyggere om de vil bruke kollektivtransport oftere hvis avgangene blir hyppigere. 234 svarer ja.
a) Kontroller at formelen kan brukes, og finn et 95 % konfidensintervall for andelen .
b) Kommunen har hevdet at «omtrent en fjerdedel» vil reise mer kollektivt. Stemmer det med målingen?
c) Hva blir 99 %-intervallet?
Hva vet vi? spurte og ja-svar. Hva skal vi finne? Intervallet for .
a) Først estimatet:
Så kontrollen av forutsetningen:
Standardfeilen — formelen tom først, så med tall:
Feilmarginen ved 95 %:
Intervallet:
Altså fra 20,8 % til 26,0 %.
b) «En fjerdedel» er 25 %, og 0,25 ligger inne i intervallet. Påstanden er altså forenlig med målingen — vi kan ikke avvise den.
c) Samme standardfeil, ny :
Altså fra 20,0 % til 26,8 %.
Svar: a) , altså 20,8 % til 26,0 %. b) Ja — 25 % ligger inne i intervallet. c) , altså 20,0 % til 26,8 %.
NB — prosentpoeng igjen. Marginen på 0,0262 skrives som 2,6 prosentpoeng, ikke 2,6 prosent. Den legges til og trekkes fra 23,4 %-tallet.
Gjør den samme utregningen som i eksempel 1. En skole spør 500 tilfeldig valgte elever om de spiser frokost før skolen. 185 svarer ja. Rund av til fire desimaler underveis og til to i svaret.
Finn .
Kontroller forutsetningen og .
Finn standardfeilen.
Finn 95 % konfidensintervallet, og oppgi det i prosent.
En avis skriver «fire av ti elever spiser frokost». Er det forenlig med målingen?
Hvor «±3 prosentpoeng» kommer fra
Meningsmålinger oppgir nesten alltid en feilmargin på rundt 3 prosentpoeng. Det er ikke tilfeldig, og det er ikke et anslag — det er en regning.
Uttrykket er størst når . Da er produktet , og standardfeilen blir så stor den kan bli. Byråene regner derfor verste fall når de planlegger:
I prosentpoeng blir det — et uttrykk som er verdt å legge merke til, fordi det gir hele sammenhengen på én linje:
| 400 | 600 | 1000 | 1500 | 2000 | 2500 | |
|---|---|---|---|---|---|---|
| margin (pp) | 4,9 | 4,0 | 3,1 | 2,5 | 2,2 | 2,0 |
Det typiske utvalget på 1000 gir altså 3,1 prosentpoeng. Derfor står det ±3 i avisen.
Kommunen fra eksempel 1 vil gjenta undersøkelsen med en feilmargin på høyst 2 prosentpoeng.
a) Hvor mange må de spørre hvis de ikke vil anta noe om svaret på forhånd?
b) Hvor mange holder det med hvis de regner med at andelen fortsatt blir omtrent 23,4 %?
c) Hvorfor velger de fleste likevel å regne som i a)?
a) Uten forhåndskunnskap regner vi verste fall, . Kravet er
Deler på 1,96 på begge sider:
Kvadrerer begge sider:
Ganger med og deler på det lille tallet:
De må spørre 2401 personer.
(Snarveien er formelen — samme regning, færre linjer.)
b) Med er :
Vi runder opp: 1722 personer. (Kontroll: gir margin 1,9997 pp, gir 2,0003 pp — så 1722 er akkurat det minste som holder.)
c) Fordi svaret i b) hviler på en antakelse om det vi skal måle. Blir andelen 45 % i stedet for 23 %, holder ikke 1722 personer marginen. Regner de verste fall, er de trygge uansett hva folk svarer. Prisen er et større, dyrere utvalg.
Svar: a) 2401 personer. b) 1722 personer. c) Fordi verste fall holder marginen uansett hva svaret blir, mens b) forutsetter at vi allerede kjenner svaret.
NB: Rund alltid opp. Et krav om «høyst 2 prosentpoeng» blir brutt hvis du runder 1721,5 ned.
En bedrift kontrollerer 250 tilfeldig valgte enheter fra produksjonen. 12 av dem er defekte.
Finn , og kontroller at formelen kan brukes.
Finn standardfeilen.
Finn et 95 % konfidensintervall for andelen defekte i produksjonen.
En kunde påstår at 10 % av enhetene er defekte. Hva sier intervallet?
Bedriften vil kunne oppgi andelen defekte med en margin på høyst 1 prosentpoeng. Hvor mange enheter må de kontrollere?
2. Populasjonens størrelse. Verken eller folketallet står i formelen. Et utvalg på 1000 gir samme margin i en kommune på 5000 som i et land på fem millioner. Det overrasker de fleste, men følger direkte av standardfeilen.
3. Intervallet dekker bare tilfeldig feil. Har undersøkelsen skjevt utvalg, ledende spørsmål eller stort frafall, hjelper det ikke at marginen er liten. Feilmarginen måler bare den slingringen som kommer av å trekke et utvalg — ikke om vi trakk riktig, eller om folk svarte ærlig. Se kapittel 3 om datainnsamling og feilkilder.
To byråer måler oppslutningen om et parti samme uke. Begge spør 1000 personer. Byrå A får 82 som sier de vil stemme på partiet, byrå B får 104.
a) Finn 95 % konfidensintervall for hvert byrå.
b) En avis skriver at «partiet steg fra 8,2 til 10,4 prosent». Er det dekning for det?
c) Hva er den mest nærliggende forklaringen på forskjellen?
Byrå A:
Byrå B:
b) De to intervallene overlapper i området fra 8,5 % til 9,9 %. Begge målingene er altså forenlige med at den sanne oppslutningen er for eksempel 9 % — og at de to byråene bare traff på hver sin side av den, slik utvalg gjør.
Det er derfor ikke dekning for å si at partiet har «steget». Vi har ikke engang målt to tidspunkter; vi har målt samme uke to ganger.
c) Tilfeldig utvalgsvariasjon. Forskjellen er 2,2 prosentpoeng, og feilmarginene er på henholdsvis 1,7 og 1,9 prosentpoeng — altså akkurat den størrelsesordenen man må vente seg.
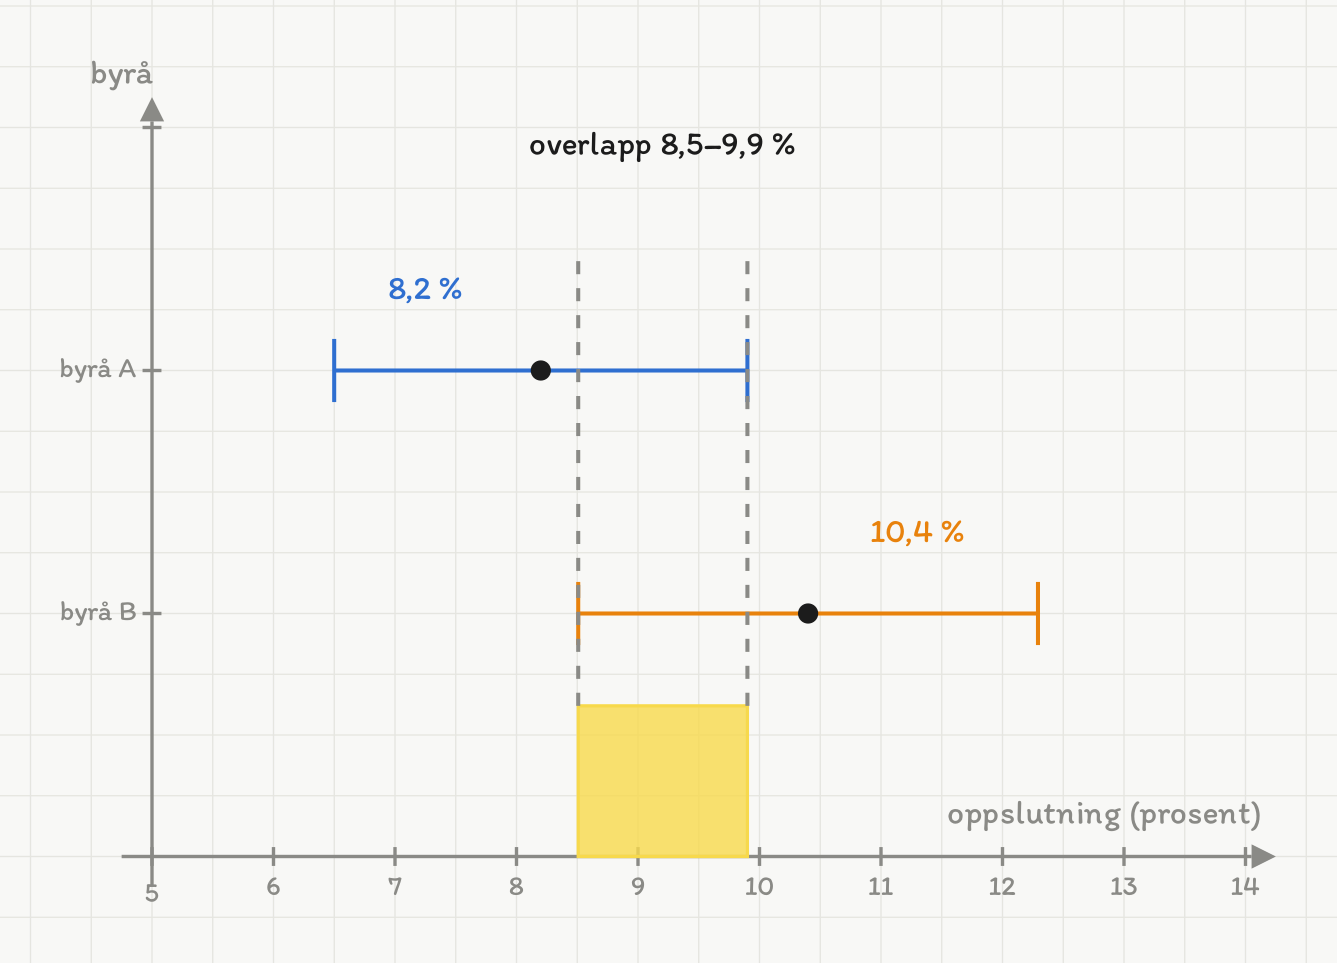
De to målingene er ikke uenige. Det gule feltet er verdiene begge intervallene rommer — begge er forenlige med at den sanne oppslutningen er for eksempel 9 %. Når to måltall skiller seg mindre enn feilmarginene, er «endringen» som regel bare utvalgsvariasjon.
Svar: a) A: , B: . b) Nei — intervallene overlapper. c) Tilfeldig variasjon mellom to utvalg.
NB — en nyttig huskeregel for nyhetene: når to måltall skiller seg mindre enn feilmarginene, er «endringen» som regel støy. Aviser omtaler likevel slike bevegelser som nyheter.
Et analysebyrå planlegger en undersøkelse. De skal oppgi en andel med 95 % konfidens.
Hvor mange må spørres for margin høyst 3 prosentpoeng, når de ikke antar noe om svaret?
Hvor mange holder det med hvis de vet at andelen er omtrent 20 %?
Hvor mange for margin høyst 2,5 prosentpoeng i verste fall?
Hvor mange for margin høyst 3 prosentpoeng hvis de nøyer seg med 90 % konfidens?
Byrået spør 1200 personer og får . Ble marginen bedre enn kravet i a)?
En kommune har svarene fra 640 innbyggere i en kolonne i et regneark. Hver rad inneholder enten «Ja» eller «Nei» på spørsmålet om de har brukt kommunens digitale tjenester siste måned. 96 svarte ja.
a) Sett opp regnearkformlene som gir , standardfeilen og 95 %-intervallet.
b) Finn intervallet.
c) Kommunen vil halvere feilmarginen til neste undersøkelse. Hvor mange må de spørre?
a) Svarene ligger i A2:A641.
=ANTALL.HVIS(A2:A641;"Ja")            gir 96        (antallet x)
=ANTALLA(A2:A641)                     gir 640       (n)
=96/640                               gir 0,15      (p-hatt)
=ROT(0,15*(1-0,15)/640)               gir 0,014114  (SE)
=0,15 - 1,96*0,014114                 gir 0,12234   (nedre grense)
=0,15 + 1,96*0,014114                 gir 0,17766   (øvre grense)
b) Kontrollen først: og , begge godt over 5.
Altså fra 12,2 % til 17,8 %.
c) Halvert margin betyr firedoblet utvalg:
(Kontroll med formelen: .)
Svar: a) ANTALL.HVIS, ROT og de to grenseformlene over. b) , altså 12,2 % til 17,8 %. c) 2560 personer.
Tolkning: Kommunen kan si at mellom 12 og 18 prosent av innbyggerne brukte de digitale tjenestene sist måned. Skal de kunne skille 15 % fra 16 % i en senere måling, må utvalget opp i mange tusen — og da er spørsmålet om forskjellen er verdt prisen.
En undersøkelse oppgir 95 %-intervallet for andelen som har svart ja. Bruk bare intervallet.
Hva var ?
Hva var feilmarginen, i prosentpoeng?
Hva var standardfeilen?
Omtrent hvor mange ble spurt?
Hva ville 99 %-intervallet blitt fra de samme dataene?
Oppsummering
- Konfidensintervall for en andel:
- Forutsetning: og — minst fem i hver gruppe. Ellers kan formelen ikke brukes.
- Standardfeilen er størst når . Verste fall gir marginen prosentpoeng, som er 3,1 ved — derav «±3 prosentpoeng».
- Nødvendig utvalgsstørrelse: , alltid rundet opp. Uten forhåndskunnskap brukes .
- Halvert margin krever firedoblet utvalg.
- Populasjonens størrelse inngår ikke i formelen.
- Overlappende intervaller betyr at forskjellen kan være tilfeldig.
- Feilmarginen dekker bare tilfeldig utvalgsvariasjon — ikke skjevt utvalg, ledende spørsmål eller frafall.
Med kapittel 7.1–7.3 kan vi estimere og oppgi usikkerhet. I kapittel 7.4 snur vi spørsmålet: i stedet for å spørre hvor ligger parameteren, spør vi er denne påstanden om parameteren troverdig?
Avgjør om hvert utsagn er riktig eller galt, og begrunn med én setning.
«Vi spurte 30 personer, og 2 svarte ja. Andelen er prosentpoeng.»
«En undersøkelse i Norge trenger større utvalg enn en tilsvarende i Island, siden Norge har flere innbyggere.»
«Feilmarginen er minst når andelen er nær 0 eller 1.»
«Vi fikk 10 000 svar på nettavstemningen, så feilmarginen er svært liten og resultatet pålitelig.»
«Vi må spørre like stor andel av befolkningen i hver kommune for å få like presise tall.»
| aldersgruppe | antall spurte | antall ja |
|---|---|---|
| 16–29 år | 320 | 148 |
| 30–59 år | 560 | 196 |
| 60 år og over | 420 | 84 |
Legg tabellen i regneark. Rund av til én desimal i prosent.
Finn og 95 %-intervallet for hver aldersgruppe.
Finn og 95 %-intervallet for alle 1300 samlet.
Er den samlede andelen lik gjennomsnittet av de tre gruppeandelene? Forklar.
Hvilket av de tre gruppeintervallene er bredest, og hvorfor?
Kan kommunen si at de yngste bruker portalen mer enn de eldste?
Finn 95 %-intervallet for partiets oppslutning.
Kan byrået si at partiet ligger over sperregrensen?
Hvor mange måtte spørres for at marginen skulle bli 0,6 prosentpoeng?
Sammenlign marginen for et parti på 4 % med marginen for et parti på 50 %, begge med 1000 spurte. Hvilket måles mest presist i prosentpoeng — og hvilket i forhold til sin egen størrelse?
Avisene omtaler ofte bevegelser på ett prosentpoeng fra måling til måling som «framgang» eller «tilbakegang». Drøft dette med tallene fra a).
Dette kapitlet er skrevet av Anthropics toppmodeller (Claude Opus og Claude Fable) og er foreløpig ikke manuelt gjennomgått — kvalitetskontrollen gjøres av uavhengige KI-agenter, og innmeldte feil rettes fortløpende. Funnet en feil? Meld fra, så retter vi den. Les mer om hvordan innholdet lages.