
Å regne ut og tolke et konfidensintervall for μ, og hva konfidensnivået betyr.
Konfidensintervall for gjennomsnitt
I kapittel 7.1 kom vi fram til to tall: estimatet og standardfeilen . Å oppgi dem hver for seg er upraktisk. Det vi vil ha, er ett svar som sier både hvor parameteren ligger og hvor sikre vi er:
«Gjennomsnittlig reisetid er mellom 25,7 og 31,1 minutter, med 95 % konfidens.»
Et slikt intervall kalles et konfidensintervall. Det er ikke noe nytt regnestykke — det er estimatet med usikkerheten bygd inn.
Hele oppskriften kommer fra sentralgrensesetningen i kapittel 6: gjennomsnittet er tilnærmet normalfordelt rundt , med standardavvik . Vet vi hvordan oppfører seg rundt , kan vi snu det og si hvordan ligger i forhold til .
Hvor 1,96 kommer fra
Vi starter med noe vi allerede kan. For en standard normalfordelt vet vi fra kapittel 6 at
Altså: 95 % av all sannsynlighet ligger mellom og . De to halene på 2,5 % hver er det vi gir slipp på.
Så standardiserer vi gjennomsnittet, akkurat slik vi standardiserte enkeltmålinger i kapittel 6 — men nå med i nevneren, siden det er standardavviket til :
Det betyr at
Nå løser vi ulikheten inni for — én operasjon på begge sider om gangen.
Tallet leses av i normalfordelingstabellen:
| konfidensnivå | ||
|---|---|---|
| 90 % | 0,10 | 1,645 |
| 95 % | 0,05 | 1,960 |
| 99 % | 0,01 | 2,576 |
Størrelsen kalles feilmarginen. Er ukjent, bruker vi i stedet (se merknaden under eksempel 2).
En maskin fyller sekker med sand. Av lang erfaring vet bedriften at standardavviket er gram, og at det ikke endrer seg når maskinen justeres. De veier 36 tilfeldige sekker og finner gram.
a) Finn et 95 % konfidensintervall for .
b) Sekkene skal inneholde 500 gram. Gir målingen grunn til å si at maskinen fyller for lite?
Hva vet vi? g, , g. Hva skal vi finne? Intervallet for .
a) Først standardfeilen:
Så feilmarginen. Konfidensnivået er 95 %, så :
Og da er intervallet
b) Tallet 500 ligger inne i intervallet. Det betyr at 500 gram er en fullt mulig verdi for — målingen på 497,4 er ikke langt nok unna 500 til å utelukke den.
Vi kan altså ikke si at maskinen fyller for lite. Det betyr ikke at den fyller riktig; det betyr at 36 sekker ikke er nok til å avgjøre spørsmålet.
Svar: a) gram. b) Nei — 500 gram ligger inne i intervallet, så målingen gir ikke grunnlag for å si at maskinen fyller for lite.
NB: Legg merke til hvor intervallet ligger: midt på , ikke midt på 500. Intervallet bygges rundt det vi målte, og så sjekker vi etterpå om verdien vi lurte på, havnet innenfor.
Gjør den samme utregningen som i eksempel 1. En maskin fyller poser med frø. Standardavviket er kjent: kg. Et utvalg på 64 poser gir kg. Posene skal veie 25,0 kg.
Finn .
Finn feilmarginen ved 95 % konfidens.
Sett opp konfidensintervallet.
Ligger 25,0 kg inne i intervallet?
Hvor bredt er intervallet, og hvor bredt ville det vært med 256 poser?
Det er fristende å si:
«Det er 95 % sannsynlighet for at ligger mellom 493,5 og 501,3.» (upresist)
Problemet er at ikke er tilfeldig. Maskinen har den fyllmengden den har — enten ligger 500 gram inne i vårt intervall, eller så gjør den ikke det. Det er ikke noe å sette sannsynlighet på etter at vi har regnet.
Det som er tilfeldig, er intervallet. Et nytt utvalg gir et nytt , og dermed et nytt intervall. Derfor:
Metoden treffer i 95 % av alle utvalg. Trekker vi 100 utvalg og lager 100 intervaller, vil omtrent 95 av dem inneholde den sanne — og omtrent 5 vil bomme. Vi vet bare ikke hvilke.
Det er dette som ligger i ordet konfidens i stedet for sannsynlighet: tilliten gjelder metoden, ikke det enkelte svaret.
Til daglig bruk er formuleringen «vi er 95 % sikre på at ligger mellom … og …» grei nok, så lenge du vet hva den egentlig hviler på. På en eksamen skal tolkningen skrives på metodeformen.
En kommune vil vite hvor lang tid innbyggerne bruker på å komme seg til jobb. De spør 50 tilfeldig valgte yrkesaktive og får minutter og minutter.
a) Finn et 95 % konfidensintervall for .
b) En nabokommune har målt 30,0 minutter. Er tallene forenlige?
c) Kan kommunen si at reisetiden er under 25 minutter?
Hva vet vi? , min, min. Her er ukjent, så vi bruker i stedet.
a) Standardfeilen:
Feilmarginen ved 95 %:
Intervallet:
b) 30,0 minutter ligger inne i intervallet. Målingene er altså fullt forenlige — forskjellen mellom 28,4 og 30,0 er mindre enn usikkerheten i vår egen måling.
c) Nei. Nedre grense er 25,7 minutter, så 25 minutter ligger utenfor intervallet. Tvert imot taler tallene for at reisetiden er over 25 minutter.
Svar: a) minutter. b) Ja, 30,0 ligger inne i intervallet. c) Nei — hele intervallet ligger over 25 minutter.
regneark:   =GJENNOMSNITT(A1:A50)               gir 28,4
            =STDAV.S(A1:A50)                    gir 9,6
            =KONFIDENS.NORM(0,05; 9,6; 50)      gir 2,661   (feilmarginen)
GeoGebra: InversNormalfordeling(0, 1, 0.975) gir 1.96 (z-verdien)Å bytte ut med er ikke gratis. Vi gjetter da på to størrelser i stedet for én, og intervallet blir i virkeligheten litt for smalt.
Når er stor, er et godt estimat, og feilen er ubetydelig. Tommelfingerregelen er — da kan vi trygt bruke -verdiene fra tabellen selv om er ukjent.
Er liten og ukjent, trengs en litt bredere fordeling (den kalles -fordelingen). Den ligger utenfor dette faget, og oppgavene her vil derfor enten oppgi , eller ha .
Praktisk regel for oppgaver:
| oppgaven oppgir | bruk |
|---|---|
| (kjent) | — uansett |
| bare , og | |
| bare , og | si fra at metoden er usikker her |
En idrettsklubb måler hoppelengden i lengde hos 40 tilfeldig valgte deltakere på et stevne og finner cm og cm. Rund av til én desimal.
Er det riktig å bruke -verdiene her, når er ukjent?
Finn standardfeilen.
Finn et 95 % konfidensintervall for .
Finn et 99 % konfidensintervall.
En trener påstår at gjennomsnittet i klubben er 165 cm. Hva sier de to intervallene om påstanden?
Vi bruker de samme reisetidsdataene som i eksempel 2: , min, min.
a) Finn konfidensintervaller på nivåene 90 %, 95 % og 99 %.
b) Sammenlign bredden på de tre.
c) Hvorfor bruker man ikke bare 99,99 % alltid?
a) Standardfeilen er den samme hele veien:
Det eneste som endrer seg, er :
| nivå | feilmargin | intervall | |
|---|---|---|---|
| 90 % | 1,645 | ||
| 95 % | 1,960 | ||
| 99 % | 2,576 |
b) Bredden er dobbelt så stor som feilmarginen: 4,47 min, 5,32 min og 6,99 min. Fra 90 % til 99 % blir intervallet
ganger så bredt — altså over halvannen gang.
c) Fordi høy konfidens kjøpes med bredde, og et bredt intervall sier lite. Et 99,99 %-intervall her ville krevd og blitt omtrent — nesten sikkert riktig, men nesten uten informasjon. Ytterpunktet er tydelig: intervallet «reisetiden er mellom 0 og 24 timer» er 100 % sikkert og fullstendig ubrukelig.
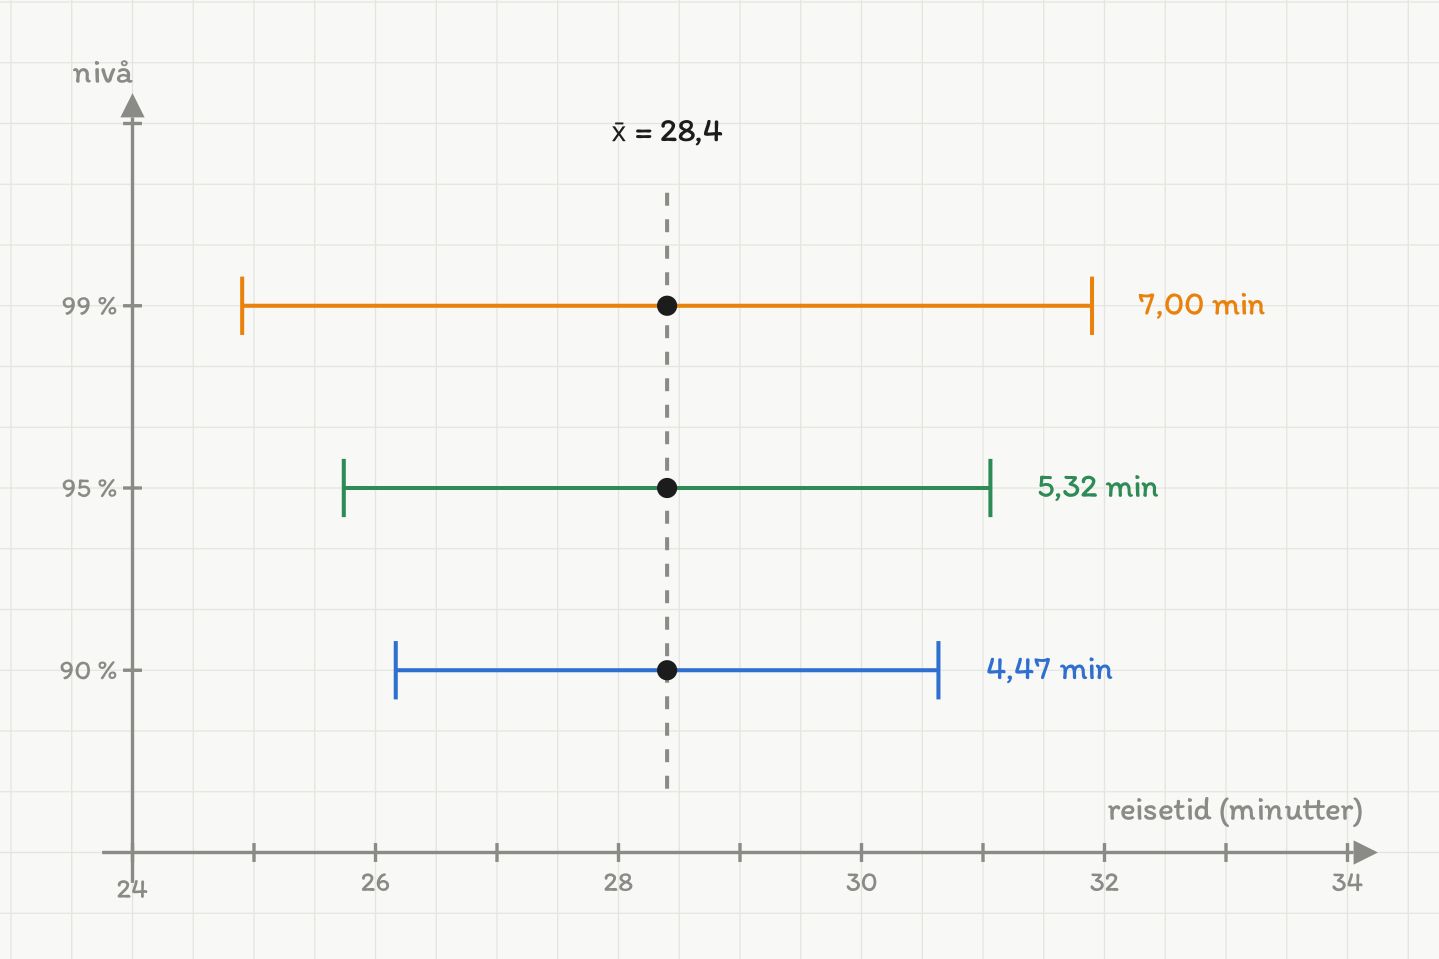
Høyere konfidens koster bredde. Alle tre intervallene er sentrert i det samme gjennomsnittet; det eneste som endrer seg, er . Fra 90 % til 99 % blir intervallet 1,57 ganger så bredt — og et bredt intervall sier mindre.
Svar: a) Se tabellen. b) 4,47, 5,32 og 6,99 minutter — 99 %-intervallet er 1,57 ganger så bredt som 90 %-intervallet. c) Fordi sikkerhet og presisjon trekker mot hver sin kant; 95 % er kompromisset som har festet seg.
NB: Det finnes bare én måte å få både høyere konfidens og smalere intervall: flere målinger. Alt annet er en byttehandel.
En strømleverandør har registrert prisen (i øre per kWh) i 100 tilfeldig valgte timer gjennom et år, og finner øre og øre. Rund av til én desimal.
Finn standardfeilen.
Finn et 90 % konfidensintervall.
Finn et 95 % konfidensintervall.
Finn et 99 % konfidensintervall.
Hvor mange timer måtte registreres for at 95 %-marginen skulle bli under 2 øre?
Kommunen fra eksempel 2 vil gjenta undersøkelsen, og denne gangen skal 95 %-marginen være høyst 1,5 minutter. De regner med at fortsatt blir omtrent 9,6 minutter.
a) Hvor mange må de spørre?
b) Kontroller svaret.
c) Hvor mange hadde holdt med 90 % konfidens i stedet?
a) Vi setter opp kravet med som ukjent:
Ganger med på begge sider:
Deler på 1,5 på begge sider:
Kvadrerer begge sider:
Antall personer må være et helt tall, og kravet er «minst», så vi runder opp:
b) Kontroll med :
Med blir marginen 1,502 — så vidt for stor. 158 er altså det minste antallet som holder.
c) Samme regning med :
Altså 111 personer.
Svar: a) Minst 158 personer. b) gir margin 1,497 min, gir 1,502 min. c) 111 personer.
NB — rund alltid OPP. Krav av typen «marginen skal være høyst …» blir strengere jo mindre er. Runder du 157,35 ned til 157, bryter du kravet. Dette er en av de vanligste bomtreffene på eksamen.
En undersøkelse gir 95 %-intervallet for gjennomsnittsalderen blant medlemmene i en forening. Avgjør om hvert utsagn er riktig eller galt, og begrunn.
«95 % av medlemmene er mellom 42,1 og 47,9 år.»
«Gjennomsnittsalderen i utvalget var 45,0 år.»
«Feilmarginen var 2,9 år.»
«Det er 95 % sannsynlighet for at ligger mellom 42,1 og 47,9.»
«Et 99 %-intervall fra de samme dataene ville vært smalere.»
En bedrift planlegger en måleserie. Standardavviket er kjent fra før: enheter. De vil ha et 95 % konfidensintervall for , og lurer på hvor mange målinger som trengs.
Hvor mange målinger for margin høyst 5?
Hvor mange for margin høyst 3?
Hvor mange for margin høyst 1?
Hvor mange for margin høyst 3 hvis de nøyer seg med 90 % konfidens?
Sammenlign a) og c). Marginen ble fem ganger mindre — hvor mange ganger flere målinger kostet det?
Oppsummering
- Et konfidensintervall for er estimatet med usikkerheten bygd inn:
- kommer fra normalfordelingen: 1,645 ved 90 %, 1,96 ved 95 %, 2,576 ved 99 %.
- Feilmarginen er , og intervallets bredde er det dobbelte.
- Er ukjent, brukes — forsvarlig når .
- Tolkning: metoden treffer i 95 % av alle utvalg. Sannsynligheten gjelder intervallet, ikke .
- Ligger en påstått verdi utenfor intervallet, taler dataene mot påstanden. Ligger den innenfor, kan vi ikke utelukke den — det er ikke det samme som at den er riktig.
- Høyere konfidens gir bredere intervall. Smalere og sikrere fås bare ved flere målinger, og antallet vokser med kvadratet av forbedringen.
- Krav om «margin høyst » løses som , og svaret rundes alltid opp.
I kapittel 7.3 gjør vi det samme for en andel — samme oppskrift, ny standardfeil.
| 498,2 | 501,5 | 496,8 | 503,1 | 499,4 | 500,7 |
| 497,3 | 502,6 | 498,9 | 501,1 | 495,6 | 504,2 |
| 499,8 | 500,3 | 497,9 | 502,0 | 496,4 | 503,7 |
| 500,1 | 498,5 | 501,8 | 499,0 | 502,9 | 497,1 |
| 500,9 | 498,7 | 503,3 | 496,2 | 501,3 | 499,6 |
Legg tallene i regneark. Rund av til to desimaler.
Finn og , og oppgi funksjonene du brukte.
Finn standardfeilen og 95 %-feilmarginen.
Sett opp 95 %-intervallet, og avgjør om 500 gram ligger innenfor.
Sett opp 99 %-intervallet. Endrer konklusjonen seg?
Produsenten vil ha 95 %-marginen under 0,5 gram. Hvor mange pakker må veies, og hva ville du rådet dem til?
En klasse regner hver sitt 95 % konfidensintervall fra hvert sitt utvalg — 20 intervaller i alt. Hvor mange bør bomme, og hva er sannsynligheten for at alle 20 treffer?
«Siden 500 lå inne i intervallet, er maskinen riktig innstilt.» Hva er feilen?
«Vi kunne fått et smalere intervall ved å velge 99 % i stedet for 95 %.» Drøft.
Finnes det et 100 % konfidensintervall?
To kommuner måler reisetid. Kommune A får og kommune B får . En avis skriver at «reisetiden i B er lengre enn i A». Er det forsvarlig?
Dette kapitlet er skrevet av Anthropics toppmodeller (Claude Opus og Claude Fable) og er foreløpig ikke manuelt gjennomgått — kvalitetskontrollen gjøres av uavhengige KI-agenter, og innmeldte feil rettes fortløpende. Funnet en feil? Meld fra, så retter vi den. Les mer om hvordan innholdet lages.