
Hvorfor gjennomsnitt av mange målinger blir normalfordelt, og fordelingen til X̄.
Sentralgrensesetningen
I kapittel 6.1 sa vi at det finnes en grunn til at klokkekurven dukker opp overalt. Nå skal vi se hva den grunnen er.
Fra kapittel 5.7 vet vi allerede to ting om gjennomsnittet av uavhengige målinger:
Midtpunktet flytter seg ikke, og spredningen krymper med .
Men det mangler noe. Vi vet hvor fordelingen til ligger og hvor bred den er — vi vet ikke hvilken form den har. Og uten formen kan vi ikke regne ut en eneste sannsynlighet.
Svaret er det mest overraskende resultatet i hele statistikken: formen blir en klokke. Nesten uansett hva vi startet med.
Terningeksperimentet
Vi begynner med noe som slett ikke er klokkeformet: én terning.
Kaster vi én terning, er alle seks utfallene like sannsynlige. Fordelingen er flat — seks like høye søyler, hver med sannsynlighet . Så langt fra en klokke som det går an å komme.
Kast nå to terninger og regn gjennomsnittet av dem:
| Gjennomsnitt | Sannsynlighet | Desimaltall |
|---|---|---|
| 1 | 0,0278 | |
| 1,5 | 0,0556 | |
| 2 | 0,0833 | |
| 2,5 | 0,1111 | |
| 3 | 0,1389 | |
| 3,5 | 0,1667 | |
| 4 | 0,1389 | |
| 4,5 | 0,1111 | |
| 5 | 0,0833 | |
| 5,5 | 0,0556 | |
| 6 | 0,0278 |
Fordelingen er ikke flat lenger. Den er en trekant med topp i 3,5. Grunnen er lett å se: gjennomsnittet 1 krever at begge terningene viser 1 — det er én kombinasjon av 36. Gjennomsnittet 3,5 kan derimot skje på seks måter (1 og 6, 2 og 5, 3 og 4, og de samme tre omvendt).
Det er hele mekanismen bak klokkeformen, i sin enkleste form: midten kan nås på mange måter, ytterpunktene bare på én.
Kast fire terninger, og trekanten begynner å bli en klokke. Kast tretti, og du får ikke øye på forskjellen fra en normalkurve i det hele tatt.
Når er stor, er gjennomsnittet
tilnærmet normalfordelt, med
Det samme gjelder summen , som er tilnærmet normalfordelt med
Det som gjør setningen så kraftig: den sier ingenting om hvilken fordeling målingene kommer fra. Den kan være flat, skjev, toppet eller hakkete. Gjennomsnittet blir klokkeformet uansett.
Tommelfingerregelen er . Er den opprinnelige fordelingen selv rimelig symmetrisk, holder det med langt færre — og er allerede normalfordelt, er eksakt normalfordelt for enhver , også .
Bremselengden i meter for en bilmodell er normalfordelt med m og m.
Et testsenter måler bremselengden 15 ganger og regner gjennomsnittet .
a) Finn og .
b) Finn sannsynligheten for at gjennomsnittet av de 15 målingene blir mindre enn 84 meter.
c) Sammenlign med sannsynligheten for at én måling blir mindre enn 84 meter.
a) Hva vet vi? , og .
Midtpunktet flytter seg ikke:
Spredningen krymper med :
b) Målingene kommer fra en normalfordeling, så er normalfordelt — eksakt, ikke bare tilnærmet.
Nå regner vi som i kapittel 6.2 og 6.3, men med og i stedet for 3:
Regneark:   =NORM.FORDELING.N(84; 83; 3/ROT(15); SANN)
GeoGebra:   FordelingNormal(83, 3/sqrt(15), 84)
gir 0,9016.
c) For én enkelt måling er :
Svar: a) m og m. b) . c) .
Tolkning: Én tilfeldig måling havner under 84 meter i omtrent 6 av 10 tilfeller. Gjennomsnittet av 15 målinger gjør det i 9 av 10. Grunnen er ikke at bilen bremser bedre — er den samme — men at gjennomsnittet svinger mindre. Det ligger tettere inntil 83, og da skal det mer til å komme over 84.
NB: Legg merke til hva som er den eneste forskjellen på denne regningen og regningen i kapittel 6.3: vi byttet med . Alt annet er likt. Den vanligste feilen i dette kapittelet er å glemme å dele på — og den gir alltid et svar som er for nær 0,5.
Finn og .
Finn .
Finn .
Finn sannsynligheten for at én tilfeldig pakke veier mer enn 251 g, og sammenlign med b).
Hva blir dersom det tas ut 64 pakker i stedet, og hva blir da ?
Vekten til voksne passasjerer kan modelleres med kg og kg.
En heis er merket «maks 4200 kg» og tar 50 personer.
a) Finn forventningsverdien og standardavviket til den samlede vekten av 50 tilfeldige passasjerer.
b) Finn sannsynligheten for at 50 passasjerer til sammen veier mer enn 4200 kg.
c) Hvilken grense måtte stått på skiltet for at sannsynligheten skulle vært 1 promille?
a) Hva vet vi? , og . Her spør oppgaven om summen, ikke gjennomsnittet, så vi bruker den andre halvdelen av setningen:
(Merk forskjellen: gjennomsnittet får delt på , summen får ganget med . Summen av mange svinger mer i kilo, gjennomsnittet svinger mindre.)
b) Vekten til én person er neppe normalfordelt — den er litt høyreskjev. Men er godt over tommelfingerregelen på 30, så sentralgrensesetningen gir oss at er tilnærmet normalfordelt:
Regneark: =1 - NORM.FORDELING.N(4200; 4000; 15*ROT(50); SANN)gir 0,0297.
c) Nå er sannsynligheten kjent og grensen ukjent — altså en kvantil. Vi skriver om først: betyr .
Regneark: =NORM.INVERS.N(0,999; 4000; 15*ROT(50))Svar: a) kg og kg. b) . c) Omtrent 4330 kg.
Tolkning: Med 50 tilfeldige voksne om bord overskrides 4200 kg i omtrent 3 % av turene. Det høres lite ut, men en heis som går 200 ganger i døgnet, vil da være overlastet flere ganger daglig. Derfor dimensjoneres heiser ikke etter gjennomsnittet, men etter en grense langt ute i halen — som i c).
Finn og .
Finn .
Finn .
Finn .
Finn grensen som bare 1 % av pallene kommer over.
Sentralgrensesetningen sier at blir «tilnærmet» normalfordelt. Hvor god er den tilnærmingen egentlig?
Vi kan måle det. Ta leveringstiden for en pakke, som er sterkt høyreskjev — de fleste kommer fort, noen få bruker svært lang tid (samme type fordeling som ventetiden i kapittel 5.6). La dager og dager.
Vi regner på to måter: med normaltilnærmingen, og eksakt.
| Normaltilnærmingen | Eksakt | Avvik | |
|---|---|---|---|
| 5 | 0,6726 | 0,7149 | 0,042 |
| 40 | 0,8970 | 0,8927 | 0,004 |
Med bare 5 målinger bommer tilnærmingen med over 4 prosentpoeng — for lite til å stole på. Med 40 målinger er avviket nede i 0,4 prosentpoeng.
Det er dette tommelfingerregelen handler om. Den er ikke en grense der noe plutselig skjer; tilnærmingen blir jevnt og trutt bedre. Og jo skjevere fordelingen er, jo større trengs. For en symmetrisk startfordeling — som terningen — er den god allerede ved .
Leveringstiden for pakker fra en nettbutikk er sterkt høyreskjev, med dager og dager.
Forbrukerrådet måler leveringstiden for 40 tilfeldige pakker og regner gjennomsnittet.
a) Kan vi regne med normalfordelingen her, når selv slett ikke er normalfordelt?
b) Finn sannsynligheten for at gjennomsnittet blir mindre enn 3,0 dager.
c) Butikken lover «gjennomsnittlig leveringstid under 3,2 dager». Finn sannsynligheten for at målingen viser mer enn 3,2 dager, selv om butikken har rett.
a) Spørsmålet er hvilken variabel vi spør om. Om én pakke kan vi ikke bruke normalfordelingen — fordelingen er skjev, og en normalmodell ville gitt positiv sannsynlighet for negativ leveringstid.
Men vi spør ikke om én pakke. Vi spør om gjennomsnittet av 40. Da gjelder sentralgrensesetningen, og :
b) Vi regner som før, med 0,395 som standardavvik:
Regneark: =NORM.FORDELING.N(3; 2,5; 2,5/ROT(40); SANN)gir 0,8970.
c) «Mer enn 3,2 dager» er høyre hale:
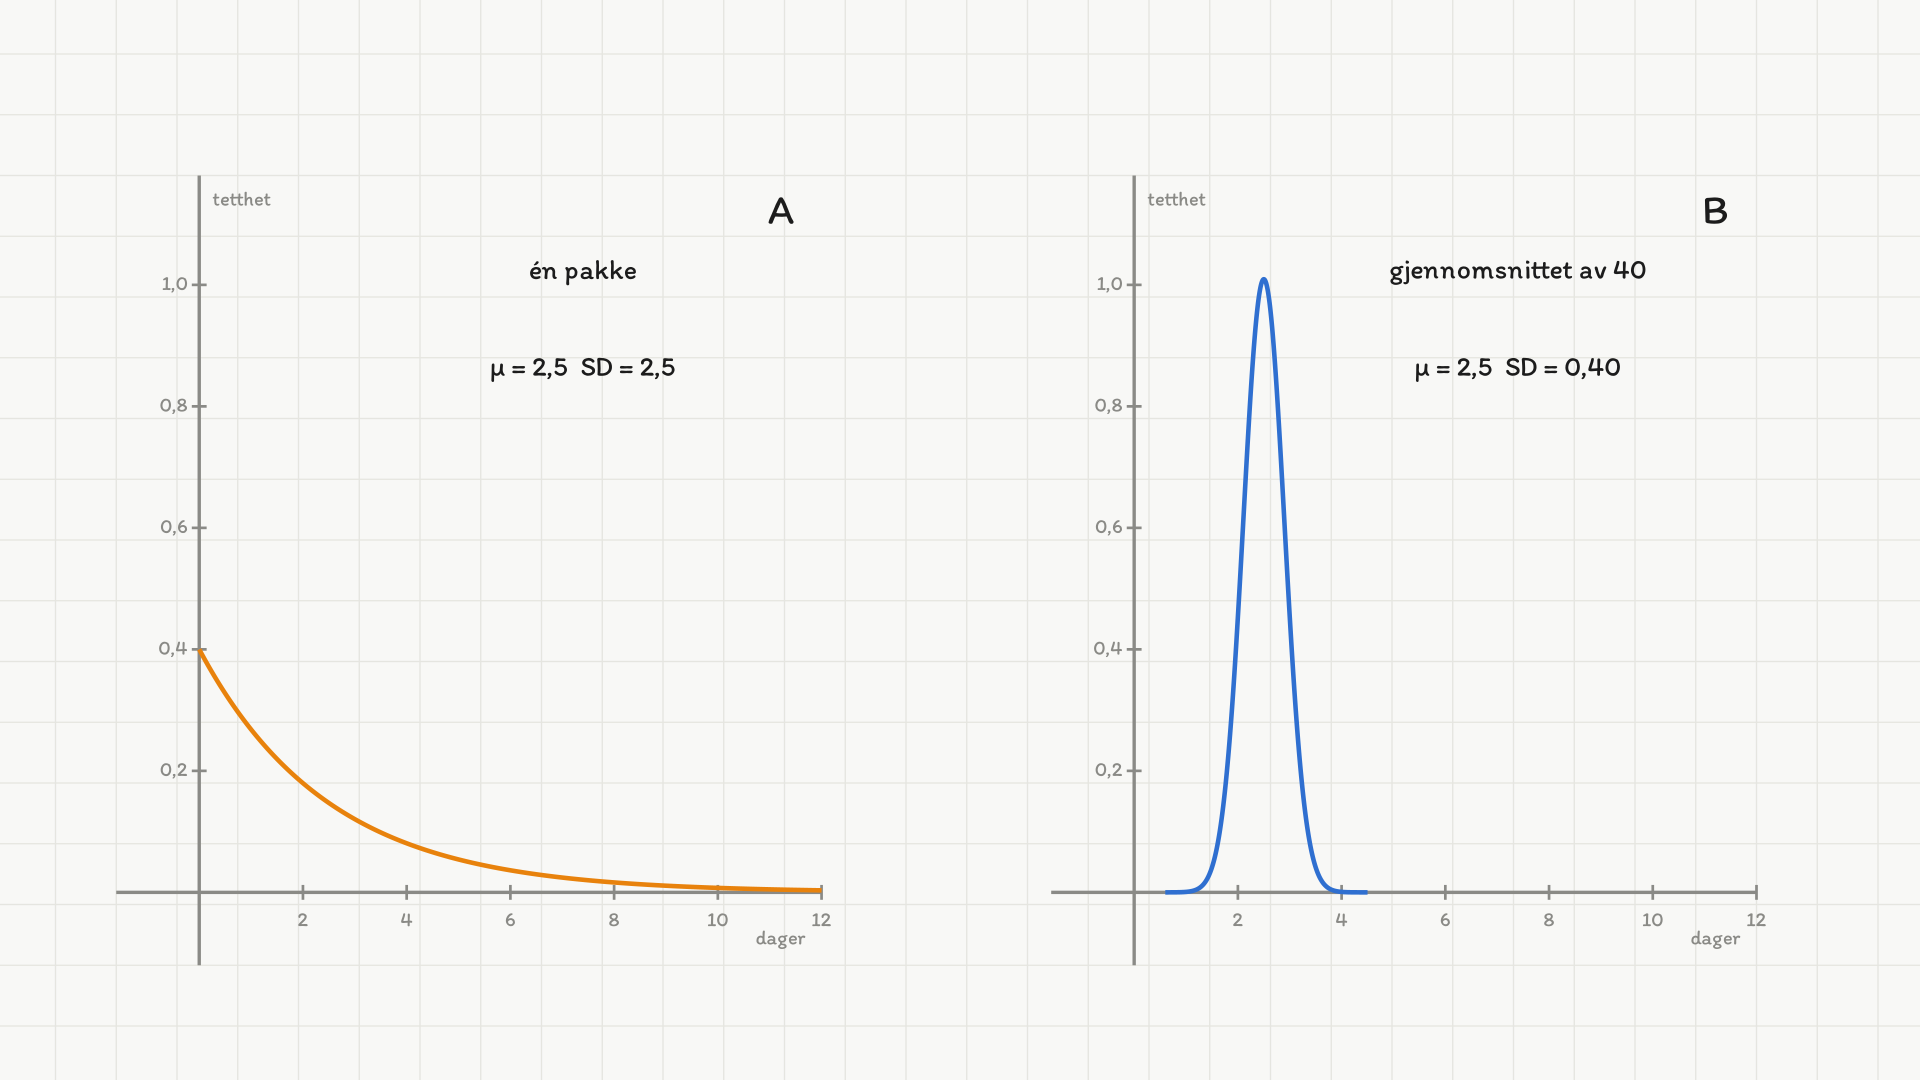
Sentralgrensesetningen gjelder gjennomsnittet, ikke enkeltpakken. Leveringstiden for én pakke (A) er sterkt høyreskjev og blir aldri normalfordelt uansett hvor mange pakker du sender. Gjennomsnittet av 40 (B) er tilnærmet normalfordelt med samme og . Panelene har samme vannrette og loddrette skala.
Svar: a) Ja — for gjennomsnittet, ikke for enkeltpakker. b) . c) .
Tolkning av c): Selv om butikken faktisk har en sann gjennomsnittlig leveringstid på 2,5 dager, vil en måling av 40 pakker vise over 3,2 dager i omtrent 4 % av tilfellene — rent på grunn av tilfeldig variasjon. Det er akkurat denne tankegangen hele kapittel 7 bygger på: et måleresultat som ser dårlig ut, kan skyldes tilfeldighet, og vi trenger et regnestykke for å avgjøre om det gjør det.
Begrunn at gjennomsnittet kan regnes som tilnærmet normalfordelt, og finn .
Finn .
Finn .
Finn .
Finn forventet samlet taletid for de 50 samtalene, og sannsynligheten for at den overstiger 225 minutter.
Et laboratorium måler konsentrasjonen i en prøve. Én måling har enheter.
Laboratoriet vil at gjennomsnittet av målingene skal ha et standardavvik på høyst 1,5 enheter.
Hvor mange målinger må de gjøre?
Hva vet vi? , og kravet er .
Hva må vi finne? Antallet .
Vi setter opp kravet med formelen:
Vi ganger med på begge sider:
Vi deler på 1,5 på begge sider:
Og kvadrerer begge sider — begge er positive, så ulikhetstegnet står:
Kontroll: . Stemmer.
Svar: Minst 64 målinger.
NB: Legg merke til hvor dyrt det er å bli nøyaktig. Her er de fire kravene regnet ut:
| Krav til | Antall målinger |
|---|---|
| 3 | 16 |
| 2 | 36 |
| 1,5 | 64 |
| 1 | 144 |
For å halvere usikkerheten fra 3 til 1,5 må antallet firedobles fra 16 til 64. Det er i nevneren som gjør det, og det er grunnen til at store undersøkelser koster så mye mer enn små uten å bli så mye bedre.
Hvor mange målinger trengs for at gjennomsnittet skal ha standardavvik høyst 0,4 kg?
Hvor mange trengs for høyst 0,2 kg?
Hvor mange trengs for høyst 0,1 kg?
Hva skjer med antallet hver gang kravet halveres?
Hver måling koster 250 kr. Hva koster det å gå fra en usikkerhet på 0,2 kg til 0,05 kg?
Sannsynligheten for at en tilfeldig sekk veier over 26 kg.
Sannsynligheten for at 36 sekker til sammen veier over 910 kg.
Sannsynligheten for at gjennomsnittsvekten av 36 sekker er over 25,3 kg.
Sannsynligheten for at en lastebil med 100 sekker overskrider 2520 kg last.
En kvalitetskontrollør veier 9 sekker og vil vite om gjennomsnittet avviker mye fra 25 kg.
Oppsummering
- Sentralgrensesetningen: gjennomsnittet av mange uavhengige målinger er tilnærmet normalfordelt — uansett hvilken fordeling målingene selv kommer fra.
- og . Midtpunktet står stille, spredningen krymper.
- Summen er også tilnærmet normalfordelt, med og . Gjennomsnittet deler på , summen ganger med .
- Regningen er den samme som i kapittel 6.2 og 6.3 — den eneste forskjellen er at byttes med eller . Glemmer du byttet, får du et svar som er for nær 0,5.
- Tommelfingerregelen er . Er startfordelingen symmetrisk, holder det med færre; er den svært skjev, trengs flere. Er selv normalfordelt, er eksakt normalfordelt for enhver .
- Setningen gjelder gjennomsnitt og summer — aldri enkeltmålinger. At gjennomsnittsinntekten i et utvalg er normalfordelt, gjør ikke inntektsfordelingen normalfordelt.
- Å halvere usikkerheten i et gjennomsnitt krever fire ganger så mange målinger.
Dette er grunnlaget for resten av faget. I kapittel 7 bruker vi det til å si hvor nøyaktig et utvalg forteller om helheten — og til å avgjøre om et måleresultat er et virkelig funn eller bare tilfeldig variasjon.
Finn for stikkprøver på 9 og på 25 poser.
Finn for hver av de to stikkprøvestørrelsene, og for én enkelt pose.
Forklar hvorfor de tre svarene i b) er så forskjellige, når er den samme i alle tre.
Hvor stor må stikkprøven være for at skal bli høyst 0,25 g?
Kontrolløren bestemmer at maskinen skal stoppes dersom gjennomsnittet av 25 poser er under 250,5 g. Finn sannsynligheten for at maskinen stoppes selv om den er riktig innstilt, og vurder om grensen er godt valgt.
«Sentralgrensesetningen sier at alt blir normalfordelt bare vi har nok data.» Drøft.
En elev regner for én måling med i stedet for . Blir svaret for høyt eller for lavt?
Setningen krever at målingene er uavhengige. Gi et eksempel der kravet er brutt, og forklar hva som går galt.
«Med er tilnærmingen god.» Når er det ikke sant?
Hvorfor er det nettopp og ikke som står i nevneren? Hva ville konsekvensen vært om det var ?
Dette kapitlet er skrevet av Anthropics toppmodeller (Claude Opus og Claude Fable) og er foreløpig ikke manuelt gjennomgått — kvalitetskontrollen gjøres av uavhengige KI-agenter, og innmeldte feil rettes fortløpende. Funnet en feil? Meld fra, så retter vi den. Les mer om hvordan innholdet lages.