
z-verdier, standardnormalfordelingen og å lese tabellen.
Standardisering og normalfordelingstabellen
68–95–99,7-regelen er nyttig, men den har en åpenbar begrensning: den svarer bare når grensen ligger nøyaktig ett, to eller tre standardavvik fra .
Hva om vi spør om en mann er høyere enn 185 cm? Eller om en pakke veier mindre enn 247,5 gram? Da hjelper ikke regelen.
Løsningen er et grep som gjør alle normalfordelinger om til én eneste: vi måler avstanden fra i antall standardavvik. Det kalles å standardisere.
Én kurve i stedet for uendelig mange
Det finnes uendelig mange normalfordelinger — én for hver kombinasjon av og . Ingen kan trykke opp en tabell for hver av dem.
Men det trengs heller ikke. Se på hva vi gjorde i kapittel 6.1: vi oversatte alltid grensen til antall standardavvik fra midten, og deretter var alle oppgavene like. Høyder i centimeter, levetider i timer og vekter i gram ga nøyaktig samme regning.
Det er hele ideen. Når vi måler i standardavvik, blir alle normalfordelinger til den samme fordelingen — den med og . Den kaller vi standardnormalfordelingen, og variabelen kaller vi .
Og for den ene fordelingen finnes det en tabell.
Regnestykket har to skritt, og begge betyr noe:
- Telleren er avstanden fra midten, i samme enhet som (centimeter, gram, kroner).
- Nevneren gjør avstanden om til antall standardavvik, og enheten forsvinner.
En -verdi er derfor alltid et rent tall, uten benevning. Den leses slik:
- betyr «halvannet standardavvik over middelverdien».
- betyr «0,8 standardavvik under middelverdien».
- betyr «akkurat på middelverdien».
Den standardiserte variabelen
er normalfordelt med og . Det er denne fordelingen tabellen gjelder for.
Standardiseringskjeden
Overgangen fra til er ikke en regel du skal huske — det er den samme operasjonen på begge sider av ulikhetstegnet, akkurat som når du løser en likning.
Se på når og :
Vi trakk fra på begge sider av ulikhetstegnet. Det endrer ikke sannsynligheten — hendelsen er nøyaktig den samme.
Vi delte på på begge sider. Siden er et positivt tall, snus ikke ulikhetstegnet.
Og nå står på venstre side:
Det som skjedde: spørsmålet «hvor sannsynlig er det at flaska inneholder høyst 1,48 liter?» ble til «hvor sannsynlig er det at er høyst ?» — og det siste spørsmålet står det svar på i tabellen.
Skriv hele kjeden når du fører. Det er den som viser at du vet hvorfor du deler på , ikke bare at du gjør det.
Tabellen
Tabellen under gir — arealet fra venstre og fram til . Nøyaktig som de kumulative binomiske tabellene i kapittel 5.5 gir den alltid «mindre enn eller lik», og alt annet må skrives om til det.
| 0,0 | 0,5000 | 1,6 | 0,9452 |
| 0,1 | 0,5398 | 1,7 | 0,9554 |
| 0,2 | 0,5793 | 1,8 | 0,9641 |
| 0,3 | 0,6179 | 1,9 | 0,9713 |
| 0,4 | 0,6554 | 2,0 | 0,9772 |
| 0,5 | 0,6915 | 2,1 | 0,9821 |
| 0,6 | 0,7257 | 2,2 | 0,9861 |
| 0,7 | 0,7580 | 2,3 | 0,9893 |
| 0,8 | 0,7881 | 2,4 | 0,9918 |
| 0,9 | 0,8159 | 2,5 | 0,9938 |
| 1,0 | 0,8413 | 2,6 | 0,9953 |
| 1,1 | 0,8643 | 2,7 | 0,9965 |
| 1,2 | 0,8849 | 2,8 | 0,9974 |
| 1,3 | 0,9032 | 2,9 | 0,9981 |
| 1,4 | 0,9192 | 3,0 | 0,9987 |
| 1,5 | 0,9332 |
Slik leser du den: finn -verdien i en -kolonne, og les av tallet ved siden av.
Kontroll du alltid kan gjøre: . Halvparten av arealet ligger til venstre for midten. Får du et tabelloppslag som bryter med dette, har du lest feil rad.
Negative -verdier står ikke i tabellen — men de trengs ikke, for symmetrien gir dem:
Arealet til venstre for er speilbildet av arealet til høyre for . Med :
De tre oversettelsene du trenger, er de samme som i kapittel 5.6:
| Spørsmålet | Regnes som |
|---|---|
| — rett oppslag | |
En maskin fyller vannflasker. Vannmengden i liter er normalfordelt med liter og liter.
Finn sannsynligheten for at en tilfeldig flaske inneholder høyst 1,48 liter.
Hva vet vi? og .
Hva må vi finne? — sannsynligheten for at vannmengden er mindre enn eller lik 1,48 liter.
Skritt 1 — standardiser. Vi regner ut hvor mange standardavvik 1,48 ligger fra midten:
Flaska med 1,48 liter ligger altså to standardavvik under middelverdien.
Skritt 2 — skriv om sannsynligheten. Hele kjeden, med samme operasjon på begge sider:
Skritt 3 — slå opp. Tabellen har ikke negative , så vi bruker symmetrien:
Vi finner i tabellen og leser av :
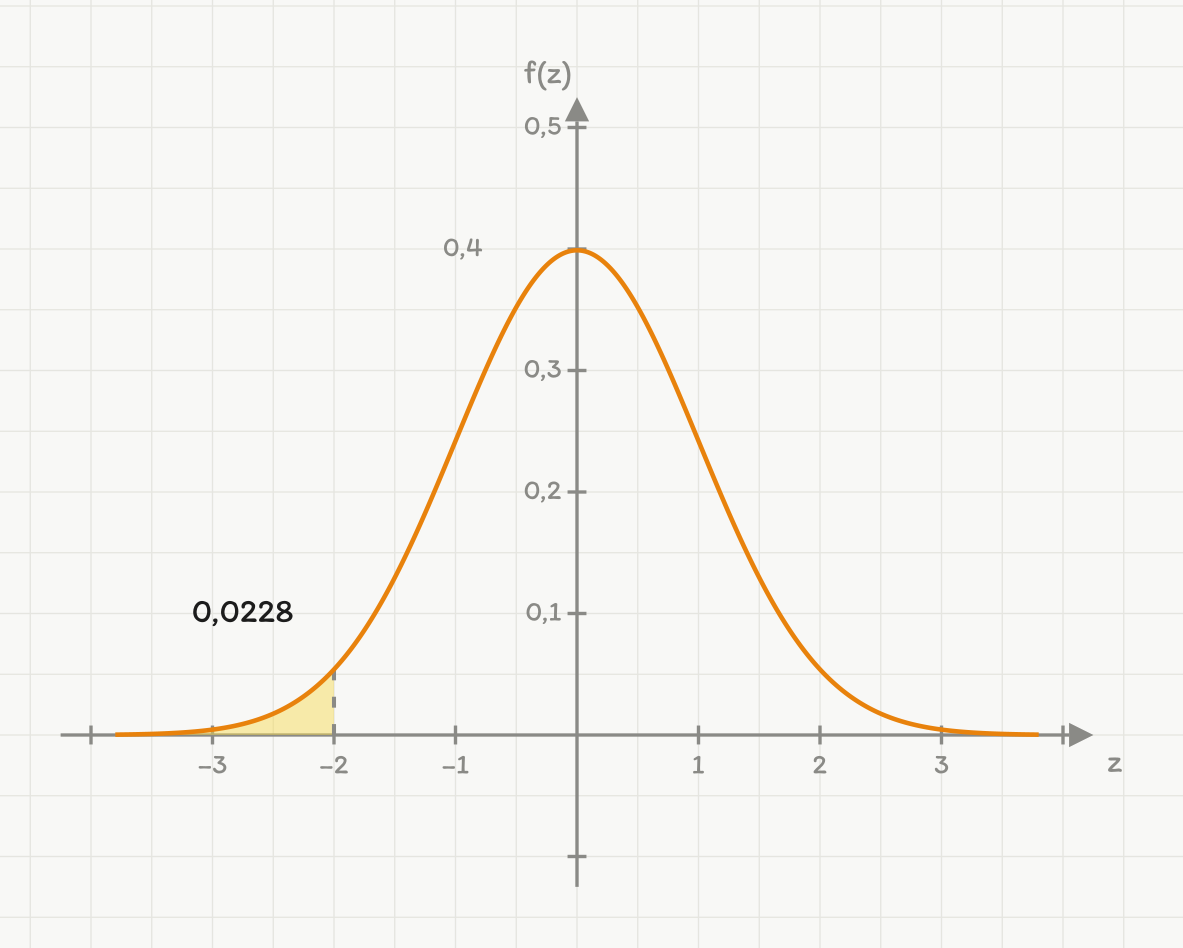
Standardnormalfordelingen, altså fordelingen til med og . Det gule feltet er — svaret i eksempel 1. Tabellen gir alltid arealet fra venstre og fram til , slik som her.
Svar:
Tolkning: Omtrent 2,3 % av flaskene inneholder 1,48 liter eller mindre. Av 1000 flasker er det rundt 23 stykker.
Rimelighetssjekk: 1,48 ligger under , og 68–95–99,7-regelen ga oss 0,025 for nettopp den grensen i kapittel 6.1. Tabellen gir 0,0228 — den samme størrelsen, bare nøyaktigere. Regelen var en avrunding av dette tallet.
Finn -verdien til , og forklar hva tallet betyr.
Finn .
Finn .
Finn .
Hvorfor er svarene i c) og d) like? Svar uten å regne.
Bremselengden i meter for en bilmodell ved 80 km/h er normalfordelt med m og m.
Finn sannsynligheten for at bremselengden er lengre enn 86 meter.
Hva må vi finne? — sannsynligheten for at bremselengden er større enn 86 meter.
Skritt 1 — standardiser:
Skritt 2 — skriv om. Tabellen gir bare «mindre enn eller lik», så vi må bruke komplementet:
Skritt 3 — slå opp. I tabellen står :
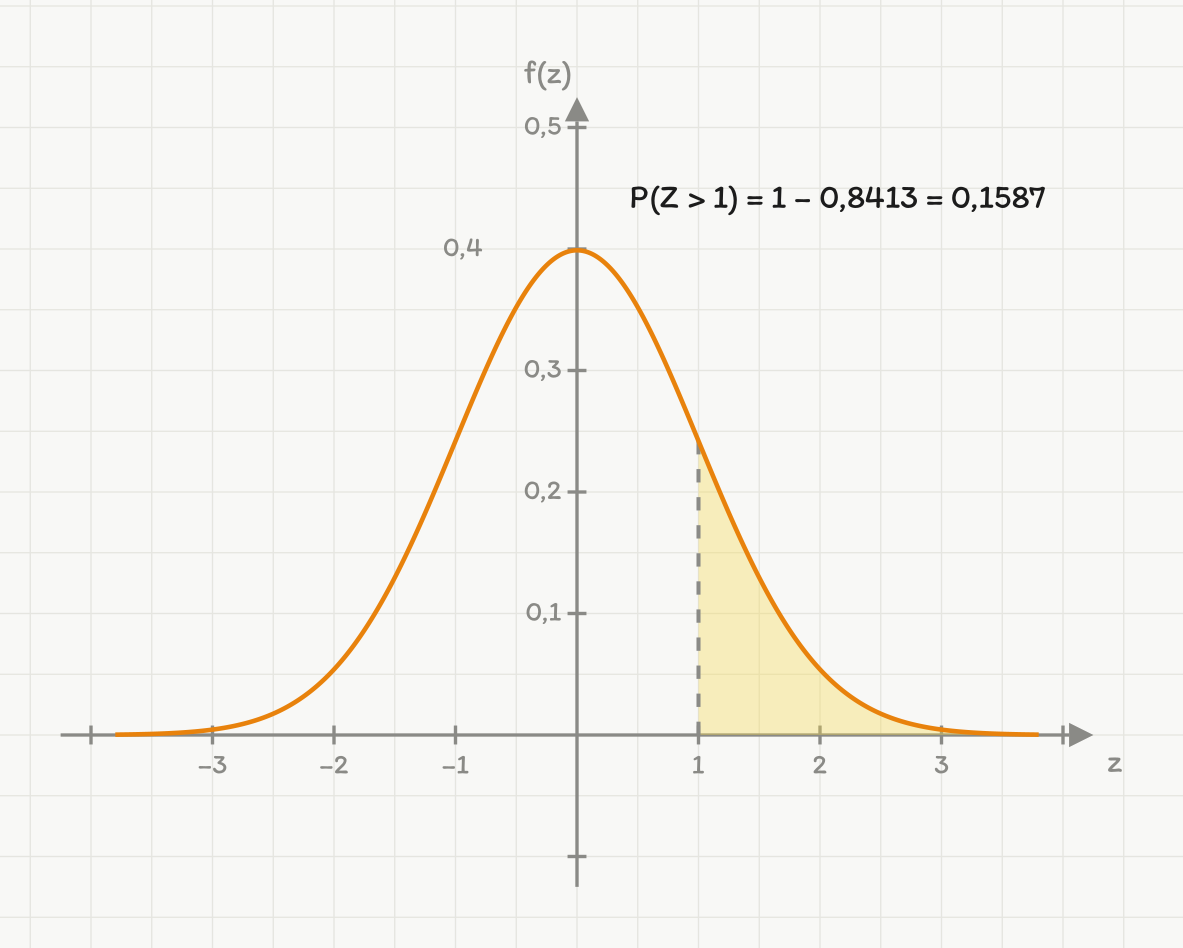
Høyrehalen. Tabellen gir alltid arealet fra venstre, altså — det hvite området. Det som spørres om, er resten: . Tegner du skissen først, blir det umulig å ta feil vei på ulikheten.
Svar:
Tolkning: I omtrent 16 % av bremsingene — altså i rundt én av seks — blir bremselengden lengre enn 86 meter. Det er verdt å merke seg for den som regner på sikkerhetsavstand: «gjennomsnittlig bremselengde 83 meter» betyr ikke at 83 meter er nok.
NB: Her er et sted det er lett å miste et skritt. Har du regnet og slått opp 0,8413, er du ikke ferdig — 0,8413 er svaret på det motsatte spørsmålet. Skriv alltid ned hvilken vei ulikheten går før du åpner tabellen.
Finn sannsynligheten for at et batteri varer lenger enn 560 timer.
Finn sannsynligheten for at et batteri varer kortere enn 440 timer.
Finn .
Finn .
En kunde kjøper 200 batterier. Hvor mange venter han varer lenger enn 560 timer?
Fødselsvekten i gram for fullbårne barn kan modelleres som normalfordelt med g og g.
Finn sannsynligheten for at et tilfeldig barn veier mellom 3000 g og 4100 g ved fødselen.
Hva må vi finne? .
Skritt 1 — standardiser begge grensene. Hver grense får sin egen -verdi:
Skritt 2 — skriv om. Arealet mellom to grenser er differansen mellom to arealer fra venstre:
Skritt 3 — slå opp. Den første står rett i tabellen:
Den andre er negativ, så vi speiler:
Skritt 4 — trekk fra:
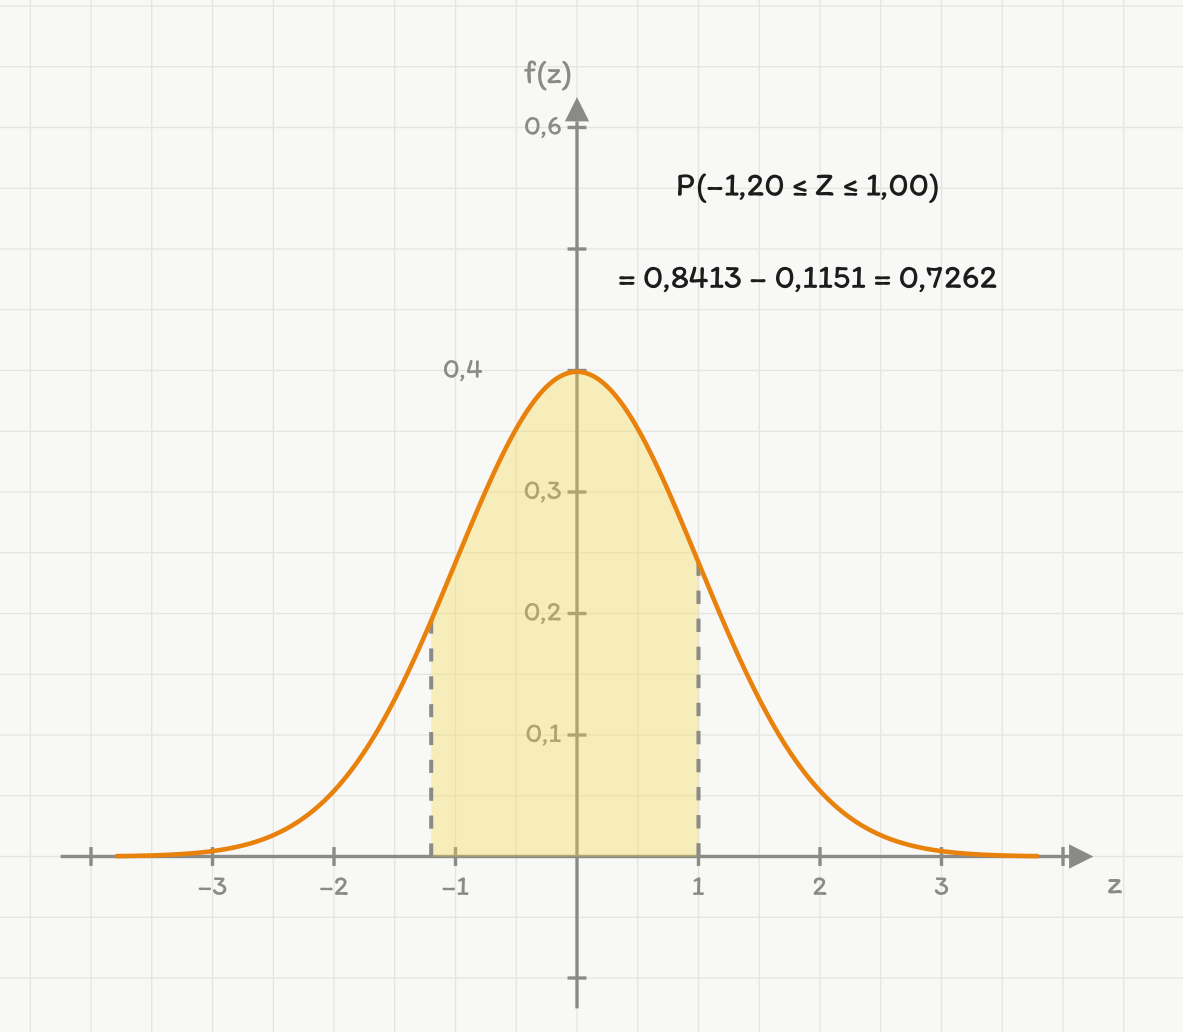
Et intervall krever to oppslag. Arealet fram til er 0,8413, og arealet fram til er 0,1151. Trekker vi det minste fra det største, står midtområdet igjen: . Subtraksjonen er ren geometri.
Svar:
Tolkning: Omtrent 73 % av fullbårne barn veier mellom 3,0 og 4,1 kilo. Utenfor ligger de resterende 27 % — omtrent 12 % under 3,0 kg og omtrent 16 % over 4,1 kg.
NB: Rekkefølgen er alltid øvre minus nedre. Snur du dem, får du et negativt tall, og en negativ sannsynlighet finnes ikke. Det er den beste kontrollen du har på dette regnestykket.
Finn .
Finn .
Finn .
Finn sannsynligheten for at en tilfeldig valgt jente er høyere enn 176 cm.
I en klasse med 30 jenter — hvor mange venter vi er lavere enn 155 cm?
Den andre veien: fra sannsynlighet til grense
Hittil har vi fått en grense og funnet en sannsynlighet. Svært mange oppgaver går motsatt vei:
«Bestem slik at .»
Da leter vi i tabellen etter innmaten i stedet for kanten: vi finner den -verdien som gir 0,90, og regner oss tilbake til .
Løser vi for — ganger med på begge sider og legger til — får vi tilbakeveien:
I ord: gå til midten, og flytt deg standardavvik derfra.
Her er en tabell med to desimaler for , slik den ser ut i formelsamlingen. Legg merke til at 0,90 ikke står der presis:
| 1,20 | 0,8849 |
| 1,21 | 0,8869 |
| 1,22 | 0,8888 |
| 1,23 | 0,8907 |
| 1,24 | 0,8925 |
| 1,25 | 0,8944 |
| 1,26 | 0,8962 |
| 1,27 | 0,8980 |
| 1,28 | 0,8997 |
| 1,29 | 0,9015 |
Sannsynligheten 0,9000 ligger mellom (som gir 0,8997) og (som gir 0,9015). Vi velger den nærmeste, — og har dermed regnet med en liten avrunding, som alltid når vi bruker tabell.
Disse fem -verdiene er verdt å kjenne igjen. De kommer tilbake i hvert eneste kapittel om konfidensintervall og hypotesetesting:
| 0,900 | 1,282 |
| 0,950 | 1,645 |
| 0,975 | 1,960 |
| 0,990 | 2,326 |
| 0,995 | 2,576 |
(Verdien 1,960 er grunnen til at «to standardavvik» og «95 %» henger så tett sammen: det eksakte tallet er 1,96, ikke 2. Avrundingen til 2 er nettopp det som gjør 68–95–99,7-regelen til en tommelfingerregel.)
Bremselengden i meter er normalfordelt med m og m, som i eksempel 2.
Bestem slik at , og gi en praktisk tolkning av svaret.
Hva vet vi? , , og at arealet fra venstre skal være 0,90.
Hva må vi finne? Grensen .
Skritt 1 — finn i tabellen. Vi leter etter tallet 0,9000 blant tabellverdiene, og finner at
Vi velger den nærmeste: .
Skritt 2 — regn tilbake til . Vi bruker :
Kontroll: vi standardiserer svaret og ser om vi kommer tilbake:
Svar: meter
Tolkning: 90 % av bremsingene er kortere enn 86,8 meter — og 10 % er lengre. Skal en veistrekning dimensjoneres slik at ni av ti bremsinger går bra, er 86,8 meter tallet å bruke. Skal ni av ti ikke være godt nok, må vi opp i et høyere krav, for eksempel 99 %, som med gir meter.
NB: Legg merke til at her er positiv, fordi vi leter etter en grense over middelverdien. Er sannsynligheten mindre enn 0,5, ligger grensen under , og blir negativ. Sjekk alltid fortegnet mot en skisse før du regner videre.
Bestem slik at .
Bestem slik at .
Bestem slik at .
Bestem slik at .
Finn intervallet som inneholder de midterste 95 % av vektene.
Oppsummering
- Å standardisere er å måle avstanden fra i antall standardavvik: . Resultatet er et rent tall uten benevning.
- Den standardiserte variabelen er normalfordelt med og . Alle normalfordelinger blir til denne ene.
- Kjeden er den samme operasjonen på begge sider: trekk fra , del på , og står igjen. Skriv den ut når du fører.
- Tabellen gir — arealet fra venstre. Alt annet skrives om: og .
- Negative finnes ikke i tabellen, men speiles: .
- Den andre veien — fra sannsynlighet til grense — bruker . Finn i tabellen først, og sjekk fortegnet mot en skisse.
- Verdt å kunne: , , og .
- Tegn alltid en skisse av klokka med det aktuelle området skravert, før du slår opp. Nesten alle feil i dette kapittelet er feil vei på ulikheten, og de blir synlige i en skisse.
I kapittel 6.3 gjør vi det samme med digitale verktøy — og da forsvinner både standardiseringen og tabellen. Men de er verdt å kunne likevel: på Del 1 har du ingen verktøy, og -verdien er dessuten et selvstendig nyttig tall, som vi skal se i oppgave 7.
Finn sannsynligheten for at en tilfeldig pose veier mindre enn det som står på merkingen.
Finn .
Bestem grensen slik at bare 1 % av posene veier mindre enn .
Bedriften vil at høyst 1 % av posene skal veie under 250 g. Hvilken må maskinen stilles inn på, dersom er uendret?
Et alternativ er å kjøpe en mer nøyaktig maskin med samme g. Hvor liten må da være for at høyst 1 % skal veie under 250 g? Hvilken av de to løsningene ville du valgt?
Finn -verdien til hver av dem.
Hvem gjorde det best i forhold til de andre som tok samme prøve?
Hvor stor andel av elevene gjorde det dårligere enn hver av dem?
«Poengsummen sier hvor flink du er, -verdien sier hvor flink du er i forhold til de andre.» Drøft påstanden.
Kan -verdier brukes til å sammenligne to helt ulike ting, for eksempel høyde og eksamensresultat?
Dette kapitlet er skrevet av Anthropics toppmodeller (Claude Opus og Claude Fable) og er foreløpig ikke manuelt gjennomgått — kvalitetskontrollen gjøres av uavhengige KI-agenter, og innmeldte feil rettes fortløpende. Funnet en feil? Meld fra, så retter vi den. Les mer om hvordan innholdet lages.