
Klokkekurven, parametrene μ og σ, og 68–95–99,7-regelen.
Normalfordelingen
I kapittel 5.6 lærte vi at sannsynlighet for en kontinuerlig variabel er areal under tetthetskurven. I kapittel 5.7 lærte vi at et gjennomsnitt sikter riktig og blir stadig mer treffsikkert når vi måler flere ganger.
Nå setter vi de to sammen, og møter den ene kurven som går igjen overalt:
- høyden til voksne mennesker
- vekten på pakker fra en pakkemaskin
- blodtrykk, fødselsvekt, skostørrelse
- måleusikkerheten i et laboratorium
- poengsummen på en stor prøve
Måler du noe av dette på mange nok, og tegner et histogram, får du hver gang omtrent den samme formen: en klokke. Høyest på midten, symmetrisk, og med haler som tynnes ut mot begge sider.
Det finnes en grunn til at akkurat denne formen dukker opp så ofte — den heter sentralgrensesetningen, og vi tar den i kapittel 6.4. Her skal vi først bli kjent med selve kurven.
Hvorfor klokkeform?
Tenk på høyden til en voksen person. Den bestemmes ikke av én ting, men av mange små bidrag som virker sammen: arvestoff fra begge foreldre, kosthold i oppveksten, søvn, sykdom, tilfeldigheter.
Hvert bidrag trekker litt opp eller litt ned. For at noen skal bli svært høy, må mange av bidragene trekke oppover samtidig — og det er sjelden. De fleste får en blanding, og havner nær midten.
Det er dette som lager klokkeformen:
- Mange verdier nær midten, fordi de fleste får en blanding av bidrag som delvis opphever hverandre.
- Få verdier langt ute, fordi det krever at nesten alle bidragene drar samme vei.
- Symmetri, fordi det er like sjeldent at alle drar opp som at alle drar ned.
Kurven har et navn, og den er fullstendig bestemt av bare to tall.
Du skal aldri regne med denne formelen for hånd. Den står her for at du skal se at kurven er bestemt — den er ikke tegnet på frihånd, og den inneholder ingen andre tall enn og .
Det er de to tallene som betyr noe:
- sier hvor kurven ligger. Toppunktet er i , og kurven er symmetrisk om den loddrette linja der.
- sier hvor bred kurven er. Stor gir en lav og flat klokke, liten en høy og smal.
Som for alle tetthetsfunksjoner er det samlede arealet under kurven 1, og sannsynlighet er areal:
NB: Vi skriver og som egne opplysninger, slik:
Vekten er normalfordelt med gram og gram.
Det er denne skrivemåten du skal bruke — både i egne besvarelser og når du leser oppgaveteksten.
Fire egenskaper som følger av symmetrien
Symmetrien om gir oss flere svar gratis, uten noen som helst regning:
1. Halvparten ligger på hver side: .
2. Like langt ut gir like mye: for ethvert tall . Halene er speilbilder.
3. Middelverdi, median og typetall er det samme tallet, nemlig . For en skjev fordeling — som ventetiden i kapittel 5.6 — er de tre forskjellige.
4. Kurven når aldri ned til -aksen. Uansett hvor langt ut du går, er det et lite areal igjen. Men det blir fort forsvinnende lite.
Punkt 4 betyr strengt tatt at en normalfordelt høyde kunne vært negativ. Sannsynligheten for det er så liten at den ikke har noen praktisk betydning — men det minner oss om at normalfordelingen er en modell, ikke virkeligheten selv.
I ord: omtrent 68 % ligger innenfor ett standardavvik fra midten, 95 % innenfor to, og 99,7 % innenfor tre.
Legg merke til at regelen ikke nevner noen konkrete tall — den gjelder for alle normalfordelinger, enten vi måler i centimeter, kroner eller timer. Det er derfor er en så nyttig måleenhet: den forteller hvor uvanlig en verdi er.
(De nøyaktige verdiene er 0,6827, 0,9545 og 0,9973. Vi runder av til 0,68, 0,95 og 0,997 når vi bruker regelen i hodet, og regner nøyaktig med verktøy i kapittel 6.3.)
Høyden i centimeter til voksne menn i Norge kan modelleres som normalfordelt med cm og cm.
a) Finn .
b) Finn sannsynligheten for at en tilfeldig valgt mann er mellom 174 cm og 186 cm.
c) Finn sannsynligheten for at han er høyere enn 192 cm.
d) I en forsamling på 500 menn — hvor mange venter vi er høyere enn 198 cm?
Hva vet vi? og . Hva må vi finne? Fire sannsynligheter, alle sammen arealer under den samme klokkekurven.
Før vi regner, oversetter vi grensene til antall standardavvik fra midten. Det er nøkkelgrepet i hele kapittelet:
a) Tallet 180 er selv, og kurven er symmetrisk om :
Halvparten av mennene er lavere enn 180 cm. (Føres ikke mer enn dette — symmetrien er hele begrunnelsen.)
b) Vi kjenner igjen 174 og 186 fra lista over: det er og . Da er det første linje i 68–95–99,7-regelen:
c) Tallet 192 er . Regelen sier at 95 % ligger mellom og . Da ligger
utenfor — men det er fordelt på to haler, én på hver side. Symmetrien sier at halene er like store, så vi deler på 2:
d) Tallet 198 er . Samme resonnement, med 99,7 %:
Forventet antall av 500 menn er sannsynligheten ganger antallet:
Svar: a) . b) . c) . d) — altså mindre enn én person.
Tolkning: I d) fant vi ikke «null menn». Vi fant at hvis du samler 500 menn mange ganger, vil du i gjennomsnitt finne trekvart person over 198 cm i hver forsamling. I praksis: som regel ingen, av og til én.
NB: Legg merke til at vi aldri brukte tetthetsformelen. Vi oversatte grensene til antall fra , og leste av regelen. Det er slik hele kapittel 6.1 fungerer.
Skriv opp de seks grensene , og .
Finn .
Finn sannsynligheten for at en tilfeldig valgt kvinne er høyere enn 179 cm.
Finn sannsynligheten for at hun er lavere enn 149 cm.
Hvor mange av 2000 tilfeldig valgte kvinner venter vi er høyere enn 179 cm?
Å dele klokka i biter
Regelen gir oss tre intervaller. Kombinerer vi dem med symmetrien, kommer vi mye lenger enn som så.
Symmetrien sier at hvert av de tre intervallene er delt i to like halvdeler av :
Nå kan vi sette sammen biter fra hver side. Her er hele oppstillingen, med arealene mellom nabogrensene:
| Område | Areal |
|---|---|
| under | 0,0015 |
| fra til | 0,0235 |
| fra til | 0,135 |
| fra til | 0,34 |
| fra til | 0,34 |
| fra til | 0,135 |
| fra til | 0,0235 |
| over | 0,0015 |
(Kontroll: summen er . Stemmer.)
Med denne tabellen kan du svare på alle spørsmål der grensene er hele antall fra — bare legg sammen bitene du trenger. Er grensene noe annet, må vi vente til kapittel 6.2, der vi lærer å regne med vilkårlige grenser.
Levetiden i timer for en type LED-pære er normalfordelt med timer og timer.
a) Finn et intervall som inneholder levetiden til omtrent 68 % av pærene.
b) Finn et intervall som inneholder levetiden til omtrent 95 % av pærene.
c) Finn sannsynligheten for at en pære varer lenger enn 1400 timer.
d) Finn .
Hva vet vi? og .
a) 68 %-intervallet er :
Intervallet er .
b) 95 %-intervallet er :
Intervallet er .
c) Fra b) vet vi at 1400 er . Utenfor 95 %-intervallet ligger 5 %, fordelt på to haler:
d) Her er de to grensene ikke like langt fra midten: 1100 er , mens 1400 er . Da kan vi ikke bruke én linje i regelen — vi må sette sammen to halvdeler:
Svar: a) timer. b) timer. c) . d) .
NB: Det er svært vanlig å svare i d) uten å tenke — det gir tilfeldigvis det samme her, men bare fordi begge leddene skulle halveres. Poenget er at hver side halveres for seg, og at du deretter legger sammen. Tegn gjerne kurven og skraver de to bitene før du summerer.
Finn et intervall som inneholder batteritiden til omtrent 68 % av hodetelefonene.
Finn et intervall som inneholder batteritiden til omtrent 95 %.
Finn sannsynligheten for at et par varer kortere enn 15 timer.
Finn .
Produsenten lover minst 13,5 timer. Hvor stor andel av parene holder ikke løftet?
En pakkemaskin fyller sekker med hundefôr. Vekten er normalfordelt, og produsenten opplyser at 95 % av sekkene veier mellom 4,2 kg og 5,8 kg.
a) Finn og .
b) Finn sannsynligheten for at en tilfeldig sekk veier mindre enn 4,6 kg.
a) Her er oppgaven snudd: sannsynligheten er gitt, og parametrene er ukjente. Nøkkelen er å kjenne igjen hvilke grenser 4,2 og 5,8 er.
95 % hører til . Altså er
Hva vet vi nå? At ligger midt mellom de to grensene, siden kurven er symmetrisk:
Og at avstanden fra 4,2 til 5,8 er hele — to standardavvik ned og to opp:
Vi deler på 4 på begge sider:
(Kontroll: og . Stemmer.)
b) Med og ser vi at
Under ligger halve resten av 68 %-intervallet:
Svar: a) kg og kg. b) .
Tolkning: Omtrent en sjettedel av sekkene veier under 4,6 kg. Skulle sekkene merkes «5 kg», er det verdt å merke seg at halvparten uansett veier mindre enn 5,0 kg — merkingen bør i så fall ligge lavere enn .
Huskeregelen: bredden på et symmetrisk intervall er alltid et helt antall — for 68 %, for 95 % og for 99,7 %. Del bredden på det tallet, så har du .
Finn .
Finn .
Finn .
Finn sannsynligheten for at en flaske inneholder mindre enn 486 ml.
Flaskene merkes «500 ml». Hva synes du om det?
Hva gjør med formen
To normalfordelinger med samme , men ulik , har toppunktet på samme sted — men de ser helt forskjellige ut:
- Liten : høy og smal klokke. Verdiene klumper seg tett om .
- Stor : lav og bred klokke. Verdiene er spredt.
Grunnen til at den smale også må være høyere er at arealet under begge kurvene er 1. Blir bunnen smalere, må toppen opp for at arealet skal holde seg.
Dette gjør til det avgjørende tallet i kvalitetskontroll. To maskiner kan treffe like godt i gjennomsnitt, og likevel være helt ulikt brukbare — det er som avgjør hvor mange enheter som havner utenfor toleransegrensene.
Et nyttig mål: hvor mange standardavvik det er fra ut til toleransegrensen. Er det 2, ryker omtrent 5 % av produksjonen. Er det 3, ryker 0,3 %. Er det 5, ryker praktisk talt ingenting.
Et meieri veier opp smør i pakker som skal veie 500 gram. Kravet er at pakkene skal veie mellom 480 g og 520 g.
To maskiner gir begge normalfordelt vekt med g, men
- maskin A har g
- maskin B har g
a) Finn for hver maskin andelen pakker som havner innenfor kravet.
b) Meieriet pakker 10 000 pakker i døgnet. Hvor mange pakker må kasseres med hver av maskinene?
c) Hva ville det kostet å skifte fra B til A, målt i kasserte pakker?
Grepet: regn ut hvor mange standardavvik det er fra ut til grensene 480 og 520. Det er 20 gram hver vei.
a) Maskin A, der :
Maskin B, der :
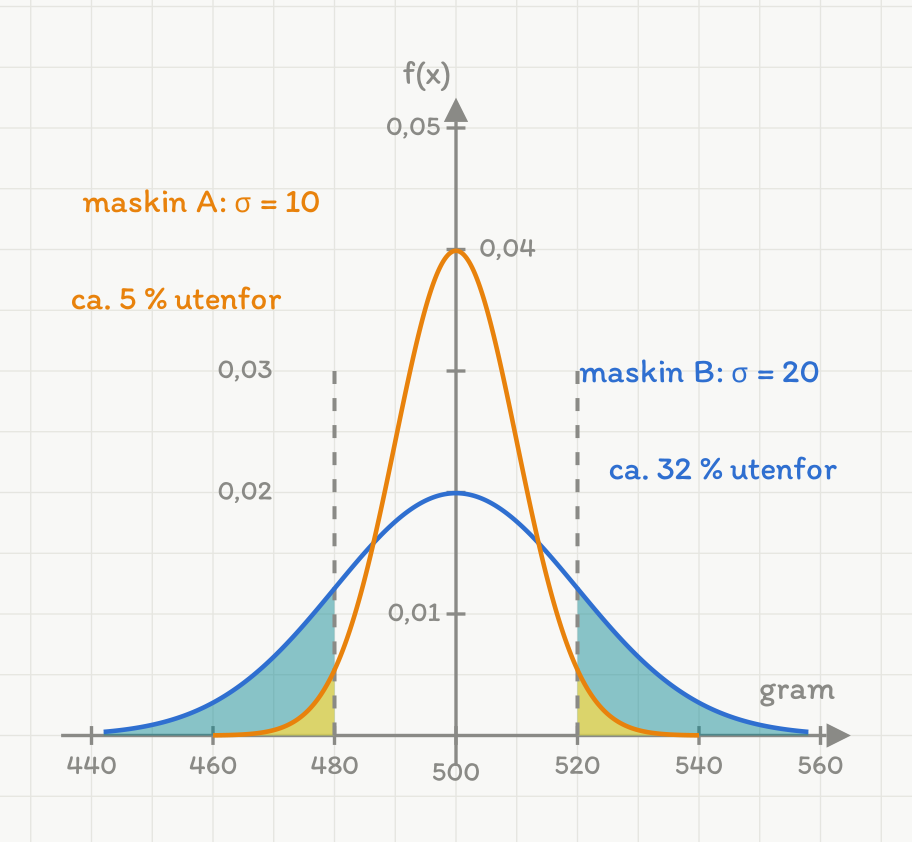
Samme forventningsverdi, ulik . Den smale kurven må være høyere, for arealet under begge er 1. Toleransegrensene 480 og 520 gram ligger fra midten for maskin A, men bare for maskin B — og det er hele forskjellen i kassasjon.
b) Andelen som kasseres er det som ligger utenfor:
c) Forskjellen er
Svar: a) A: %, B: %. b) A: 500 pakker, B: 3200 pakker. c) 2700 færre kasserte pakker per døgn med maskin A.
Tolkning: Begge maskinene «treffer riktig» — gjennomsnittsvekten er 500 gram for begge. Likevel kaster den ene bort seks ganger så mye som den andre. Det er ikke som avgjør kvaliteten, det er .
Dette er kjernen i industriell kvalitetskontroll: å presse nedover, slik at toleransegrensene havner stadig flere standardavvik fra midten.
- Nord: mm
- Sør: mm
Hvor mange standardavvik fra ligger toleransegrensene hos hver leverandør?
Finn andelen godkjente bolter fra hver leverandør.
Fabrikken bruker 20 000 bolter i uka. Hvor mange kasseres fra hver leverandør?
Sør er 3 øre billigere per bolt, og en bolt fra Nord koster 1,20 kr. Hvilken leverandør er billigst når kassasjonen regnes med?
Hvor stor må være for at toleransegrensene skal ligge fra , og hvor mange bolter kasseres da?
Normalfordelingen er en modell, og den passer ikke på alt. Sjekk disse tre tingene før du bruker den:
1. Er fordelingen symmetrisk? Inntekter, ventetider, husholdningsformue og skadeutbetalinger er skjeve: de har en lang hale mot høyre og ingen hale mot venstre. Der er normalfordelingen feil modell, og gjennomsnittet et dårlig midtpunkt (se kapittel 1.3).
2. Kan variabelen ta alle verdier i et intervall? Antall barn i en familie, antall riktige på en prøve og antall som svarer ja i en spørreundersøkelse er diskrete. De kan noen ganger tilnærmes med en normalfordeling — det gjør vi i kapittel 6.5 — men de er ikke normalfordelte.
3. Er det én gruppe, eller flere blandet sammen? Måler du høyden til alle voksne i Norge under ett, får du ikke én klokke, men to overlappende klokker lagt oppå hverandre — én for kvinner og én for menn. Toppen blir da bredere og flatere enn en ekte normalkurve.
Hvordan sjekke i praksis: tegn et histogram av dataene, og se etter klokkeformen. Er den tydelig skjev, eller har den to topper, må du velge en annen modell.
Vekten til nyfødte barn i Norge.
Årsinntekten til alle voksne i en kommune.
Antall elever som er borte fra skolen en tilfeldig dag.
Tiden til neste kunde ringer inn til en kundeservice.
Høyden til alle elevene på en ungdomsskole.
Oppsummering
- En normalfordelt variabel har en symmetrisk klokkeformet tetthetskurve som er fullstendig bestemt av to tall: (hvor kurven ligger) og (hvor bred den er).
- Vi skriver opplysningene som egne linjer: « er normalfordelt med og ».
- Symmetrien gir , og at halene er speilbilder: .
- 68–95–99,7-regelen: omtrent 68 % ligger innenfor , 95 % innenfor og 99,7 % innenfor .
- Framgangsmåten er alltid den samme: regn ut hvor mange standardavvik grensen ligger fra , og les av regelen. «Utenfor» deles på to like haler.
- Er grensene ulikt langt fra , deler du i to biter ved og legger sammen halvdelene.
- Går oppgaven motsatt vei, bruker du at ligger midt i intervallet, og at bredden er (68 %), (95 %) eller (99,7 %).
- avgjør kvaliteten: hvor mange standardavvik det er ut til toleransegrensen, bestemmer hvor mye som kasseres.
- Normalfordelingen passer ikke på skjeve fordelinger, og heller ikke uten videre på blandinger av flere grupper.
I kapittel 6.2 tar vi neste skritt: å regne med vilkårlige grenser, ikke bare hele antall .
Finn , og forklar hva tallet betyr i denne sammenhengen.
Finn sannsynligheten for at en tilfeldig valgt elev fikk mer enn 58 poeng.
Hvor mange av de 1200 elevene venter vi fikk mer enn 58 poeng?
Finn .
Skolen vil gi ekstra oppfølging til de 2,5 % svakeste. Hvilken poenggrense gir det, og hvor mange elever gjelder det?
Skriv formlene som gir og for dataene, og forklar hvorfor du velger STDAV.S og ikke STDAV.P.
La regnearket vise ml og ml. Hvilket intervall venter du at omtrent 95 % av målingene ligger i, dersom fyllmengden er normalfordelt?
Skriv en regnearkformel som teller hvor mange av de 200 målingene som faktisk ligger i intervallet fra b).
Tellingen i c) gir 189. Stemmer det med modellen?
Hvilken figur ville du laget i regnearket for å vurdere om fordelingen faktisk er klokkeformet, og hva ville fått deg til å forkaste normalmodellen?
«Siden 99,7 % av verdiene ligger innenfor , er det umulig å måle en verdi lenger ute enn det.» Drøft.
To fordelinger har samme . Kan den ene likevel gi flest verdier over et gitt tall ?
«Standardavviket til en normalfordeling kan leses av kurven.» Hvordan?
En elev regner . Hva er feilen, og hvor stor er den?
Hvorfor er et mer nyttig spredningsmål for en normalfordeling enn variasjonsbredden (største minus minste måling)?
Dette kapitlet er skrevet av Anthropics toppmodeller (Claude Opus og Claude Fable) og er foreløpig ikke manuelt gjennomgått — kvalitetskontrollen gjøres av uavhengige KI-agenter, og innmeldte feil rettes fortløpende. Funnet en feil? Meld fra, så retter vi den. Les mer om hvordan innholdet lages.