
Sammenhengen mellom det vi regner fra data og det modellen sier — og hvorfor vi deler på n − 1.
Gjennomsnitt og forventningsverdi, utvalgsstandardavvik og standardavvik
Gjennom hele kapittel 5 har vi regnet på modeller: en fordeling er gitt, og vi finner og ut av den. I kapittel 1 gjorde vi noe som ser nesten likt ut, men som er noe helt annet: vi regnet gjennomsnitt og standardavvik ut av målte data.
Disse to verdenene må holdes fra hverandre — og samtidig forstås som to sider av samme sak. Her er hele oppstillingen:
| fra DATA (et utvalg) | fra MODELLEN (fordelingen) | |
|---|---|---|
| midtpunkt | gjennomsnitt | forventningsverdi |
| spredning | utvalgsstandardavvik | standardavvik |
| hvor kommer tallet fra? | vi har målt det | vi har antatt eller utledet det |
| endrer det seg? | ja — nytt utvalg gir nytt | nei — er en fast egenskap ved modellen |
og er altså tilfeldige — de hopper litt hver gang vi trekker et nytt utvalg. og står stille.
Sammenhengen mellom dem er hele poenget med statistikk: vi bruker det vi har målt til å si noe om det vi ikke kan måle.
Fra modellen. Har vi en stokastisk variabel :
Legg merke til at de to spredningsformlene er bygget likt: summer de kvadrerte avvikene, del, og ta roten. Den eneste forskjellen er hva vi deler på — og det er nettopp forskjellen dette kapittelet handler om.
NB: Regner vi med hele populasjonen i hånden — ikke et utvalg — deler vi på i stedet for . Da kalles tallet populasjonsstandardavviket og skrives også . Oppgaven må alltid si hvilken av de to det er snakk om.
Hvorfor deler vi på ?
Dette er et av de spørsmålene som virker som en tilfeldig regel, men som har en helt konkret grunn.
Når vi skal måle hvor spredt dataene er, må vi måle avvikene fra et sted. I modellen måler vi fra — et tall som ikke kommer fra dataene. Men når vi bare har et utvalg, kjenner vi ikke . Vi må bruke i stedet — og er regnet ut av de samme dataene.
Da skjer det noe: ligger alltid så gunstig plassert som overhodet mulig i forhold til akkurat disse tallene. Summen blir den minste den kan bli for noe som helst tall vi kunne målt fra. Hadde vi målt fra den sanne i stedet, ville summen blitt større.
Deler vi på , får vi derfor systematisk et for lite tall. Å dele på i stedet er akkurat den oppjusteringen som retter opp skjevheten — og det den retter opp eksakt, er skjevheten i variansen: .
Viktig presisering: Legg merke til at det er , ikke , som blir treffsikker på denne måten. Kvadratroten er ikke en rett linje, så ligger fortsatt litt under i gjennomsnitt (ved og normalfordelte data omtrent 6 % under, ved under 1 %). Den lille skjevheten korrigerer vi ikke — er korreksjonen vi gjør, og den gjelder variansen.
Et annet bilde på det samme: avvikene fra gjennomsnittet summerer alltid til null:
Kjenner du derfor av avvikene, er det siste bestemt — du kan regne det ut. Bare av avvikene bærer ny informasjon. Vi sier at vi har frihetsgrader, og det er dem vi deler på.
NB: Forskjellen betyr mest når er liten. Ved er det forskjell på å dele på 4 og på 5: blir ganger -versjonen, altså omtrent 12 % større. Ved er faktoren — uten praktisk betydning.
a) Finn gjennomsnittet .
b) Finn utvalgsstandardavviket .
c) Finn populasjonsstandardavviket (der vi deler på ), og sammenlign.
a) Vi skriver formelen tom først, og setter så inn:
b) Vi regner avvikene og kvadratene i en tabell:
| 4 | 7 | 8 | 10 | 11 | Sum | |
|---|---|---|---|---|---|---|
| 0 | 2 | 3 | 0 | |||
| 16 | 1 | 0 | 4 | 9 | 30 |
(Legg merke til Sum-cella i rad 2: avvikene summerer til 0, slik de alltid gjør. Det er en gratis kontroll på at er riktig regnet.)
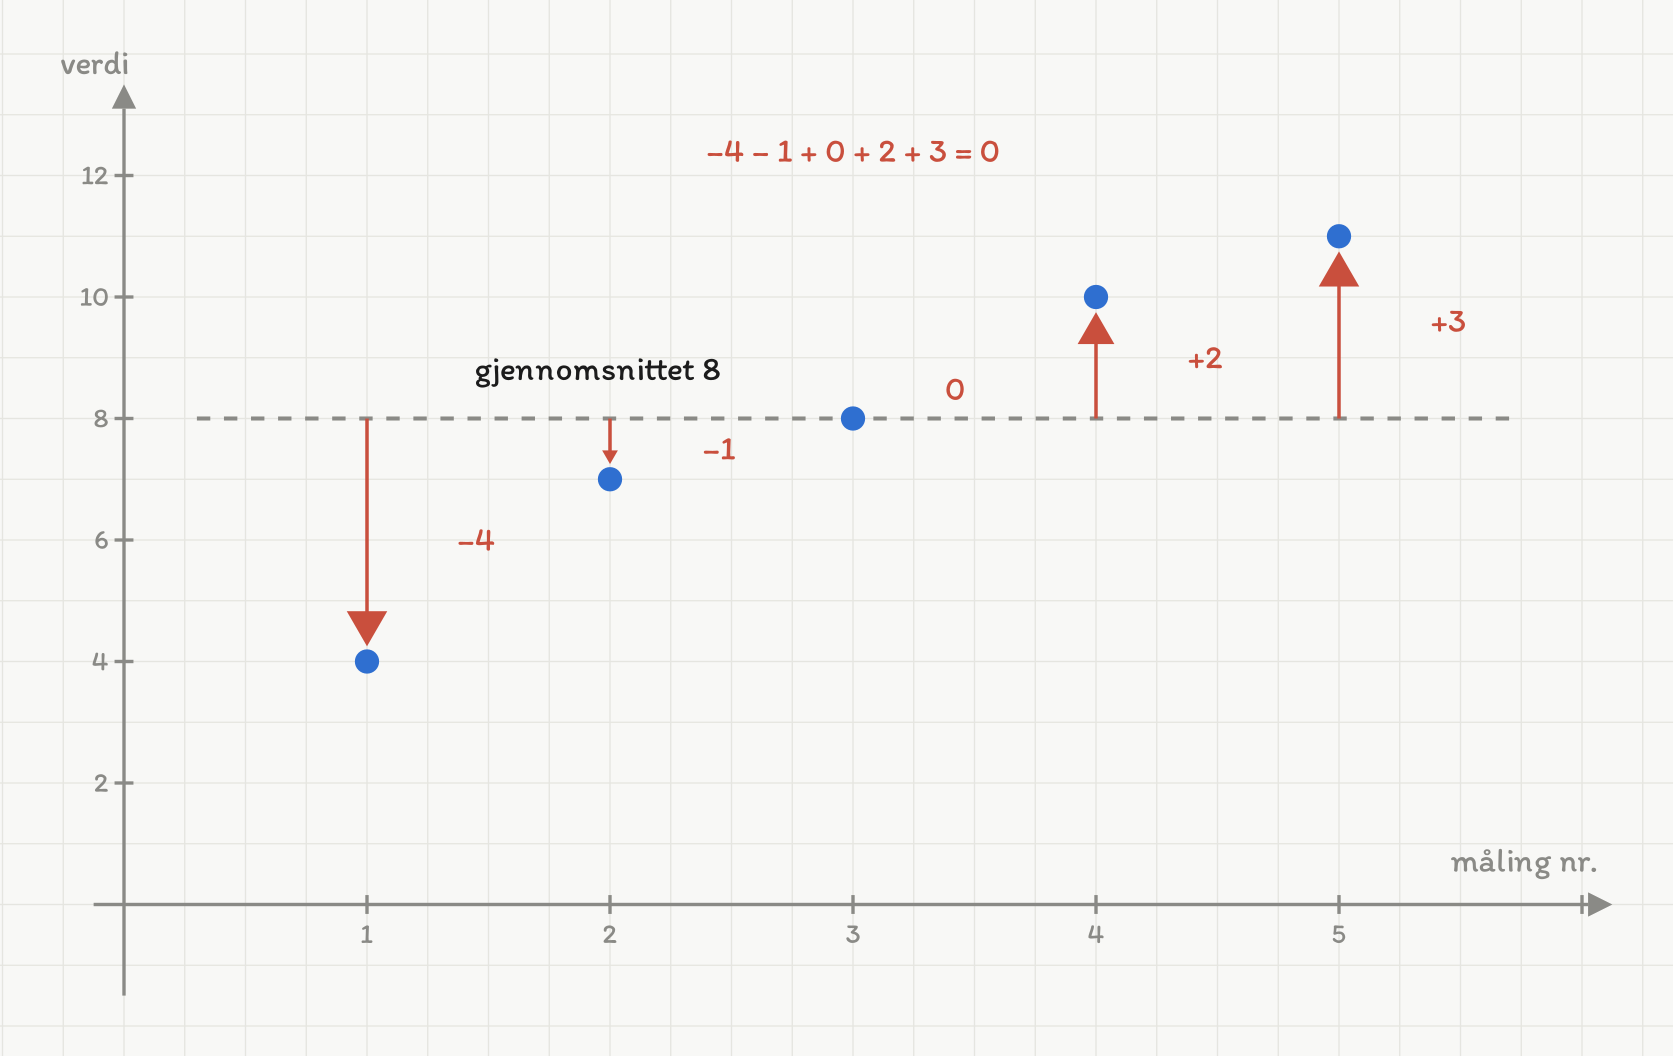
De fem avvikene fra gjennomsnittet summerer alltid til null. Kjenner du fire av dem, er det femte bestemt — det er bare frie avvik i et utvalg på . Derfor deler vi på og ikke på .
Så setter vi inn i formelen. Her er , så vi deler på :
c) Deler vi i stedet på :
Forskjellen er minutter. Utvalgsstandardavviket er altså omtrent 12 % større enn -versjonen — forholdet mellom dem er . Med bare fem målinger er det en merkbar forskjell.
Svar: a) minutter. b) minutter. c) minutter — er omtrent 12 % større enn dette.
Hvilken skal brukes? Er de fem elevene et utvalg, og vi vil si noe om alle elever, bruker vi . Er de fem elevene hele gruppen vi er interessert i, og vi bare beskriver dem, bruker vi . I praksis er den første situasjonen den vanligste, og det er derfor med er standardvalget.
Gjør den samme utregningen som i eksempel 1. Rund av til to desimaler.
Finn .
Sett opp tabellen med avvik og kvadrerte avvik, og kontroller at avvikene summerer til 0.
Finn summen av de kvadrerte avvikene.
Finn utvalgsstandardavviket .
Finn populasjonsstandardavviket (del på ), og oppgi hvor mange prosent STØRRE er enn dette.
Loven om store tall
Vi har nå to størrelser som svarer til hverandre: fra data, fra modellen. Hvordan henger de sammen?
Tenk deg at du kaster en terning ganger og regner gjennomsnittet av øynene. Med kan gjennomsnittet lett bli 2,4 eller 4,8. Med ligger det som regel mellom 3,2 og 3,8. Med er det nesten alltid 3,49 eller 3,51.
Dette er loven om store tall: gjennomsnittet av mange uavhengige målinger nærmer seg forventningsverdien.
Det er dette som gjør statistikk mulig i det hele tatt. Vi kan ikke måle direkte — men vi kan måle , og vi vet at den nærmer seg .
Men hvor raskt nærmer den seg? Det svaret er kanskje det mest nyttige resultatet i hele kapittelet.
Da gjelder
Feilen er at settes lik i stedet for . Summen av målinger har jo ganger så stor forventningsverdi som én måling — kaster du terningen 10 ganger, venter du en sum på omkring 35, ikke 3,5.
Rimelighetssjekken avslører den på ett sekund: kast en terning 100 ganger og regn gjennomsnittet. Blir det omtrent 3,5, eller omtrent ? Et gjennomsnitt av terningkast kan umulig være 0,035 — det minste mulige gjennomsnittet er 1.
Husk derfor:
- Midtpunktet flytter seg ikke. , uansett hvor mange målinger vi tar.
- Spredningen krymper. , og den går mot 0 når vokser.
Det er nettopp derfor gjennomsnittet nærmer seg : det sikter riktig hele veien, og blir bare mer og mer treffsikkert.
Innholdet i en type saftflaske har forventningsverdi ml og standardavvik ml.
a) Finn og når vi måler 36 flasker.
b) Finn de samme størrelsene for 144 flasker.
c) Hvor mange flasker må vi måle for at skal bli 1 ml?
a) Forventningsverdien flytter seg ikke:
Standardavviket krymper med :
b) Med :
Vi firedoblet antall flasker, og halverte spredningen. Det er det gjør.
c) Vi setter opp likningen med som ukjent:
Ganger med på begge sider:
og kvadrerer begge sider:
Som vi allerede så i b).
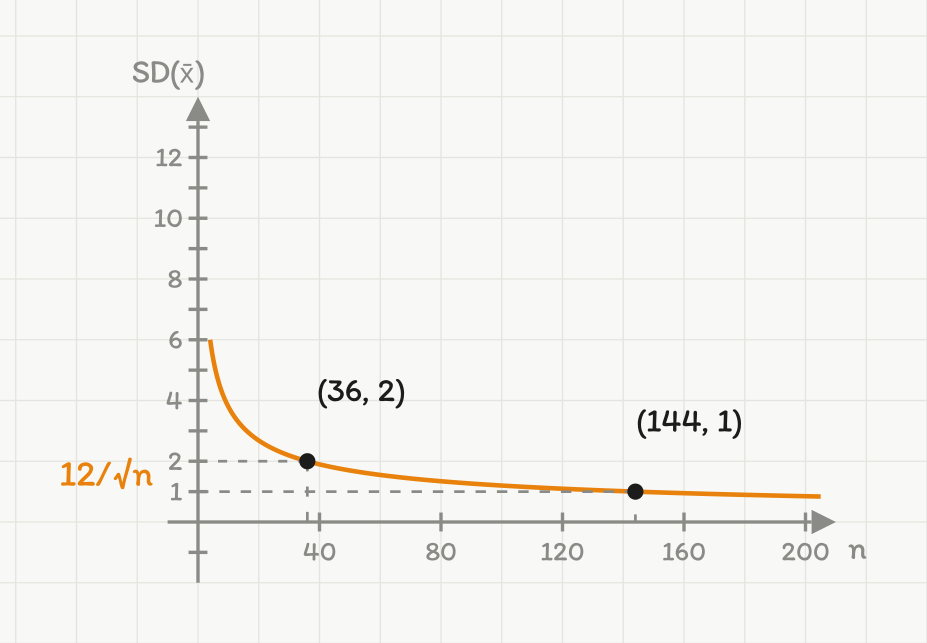
Standardavviket til GJENNOMSNITTET, , tegnet for . Kurven faller bratt i starten og flater ut: å firedoble fra 36 til 144 halverer usikkerheten fra 2 til 1, mens de neste 100 målingene knapt hjelper.
Svar: a) ml og ml. b) ml og ml. c) 144 flasker.
NB — den viktigste praktiske konsekvensen: For å halvere usikkerheten må du firedoble antall målinger. Vil du ti ganger så nøyaktig svar, må du måle hundre ganger så mye. Det er derfor store undersøkelser er så dyre — og derfor det sjelden lønner seg å øke utvalget fra 1000 til 1100.
En maskin fyller sekker med sand. Vekten har kg og kg. Vi veier tilfeldige sekker og regner gjennomsnittsvekten . Rund av til tre desimaler der det trengs.
Finn når .
Finn når .
Finn når .
Hvor mange sekker må veies for at skal bli høyst 0,05 kg?
Forklar med én setning hvorfor er den samme i a) uansett hvor mange sekker vi veier.
og som estimater
Vi er nå klare til å si hva det hele er godt for.
I virkeligheten kjenner vi sjelden og . Vi har bare et utvalg. Da bruker vi de målte tallene som estimater — beste gjetning — for de ukjente:
At er nettopp det som gjør til et forventningsrett estimat: den bommer ikke systematisk i noen retning. Noen utvalg gir litt for høyt, noen litt for lavt, men i gjennomsnitt treffer den.
Og det er den samme egenskapen vi kjøpte oss da vi delte på i stedet for — men der gjelder den variansen: korreksjonen gjør at , altså at er et forventningsrett estimat for . Uten den ville systematisk undervurdert . Standardavviket er derimot ikke helt forventningsrett for — det ligger i gjennomsnitt litt under — men med treffer det mye bedre, og er tallet vi bruker i praksis.
I regneark må du derfor velge riktig funksjon:
| Funksjon | Deler på | Bruk når |
|---|---|---|
=STDAV.S(...) | dataene er et utvalg (nesten alltid) | |
=STDAV.P(...) | dataene er hele populasjonen |
=GJENNOMSNITT(...) gir , og der finnes ingen slik felle.a) Finn og .
b) Hva er estimatet for og i produksjonen?
c) Finn for et utvalg på ti flasker, og forklar hva tallet betyr.
a) Gjennomsnittet:
Avvikene fra 500,5 blir
(Kontroll: summen av avvikene er 0.)
De kvadrerte avvikene summerer til
og da er
regneark:   =GJENNOMSNITT(A1:A10)   gir 500,5
            =STDAV.S(A1:A10)        gir 3,689
b) De ti flaskene er et utvalg fra produksjonen. Vi bruker dem som estimater:
c) Med og :
Dette tallet sier hvor mye gjennomsnittet svinger fra utvalg til utvalg. Hadde kontrolløren målt ti nye flasker, ville hun fått et litt annet gjennomsnitt — typisk om lag 1,2 ml unna dette.
Legg merke til forskjellen på de to spredningstallene: enkeltflasker varierer med omtrent 3,7 ml, mens gjennomsnittet av ti varierer med bare 1,2 ml.
Svar: a) ml og ml. b) ml, ml. c) ml — hvor mye gjennomsnittet av ti flasker svinger.
Rund av til to desimaler.
Finn .
Finn summen av de kvadrerte avvikene.
Finn .
Hvilke regnearkfunksjoner gir og ?
Finn når vi bruker som estimat for .
En maskin lager bolter. Vi vet fra produsenten at diameteren har mm og mm. Tre kontrollører måler hver sine fem bolter (i mm):
| Utvalg A | 19,8 | 20,3 | 20,1 | 19,6 | 20,4 |
| Utvalg B | 20,2 | 19,9 | 20,5 | 20,0 | 19,7 |
| Utvalg C | 19,5 | 20,1 | 20,2 | 20,4 | 19,9 |
a) Finn og for hvert utvalg.
b) Hvilke av tallene i oppgaven er faste, og hvilke er tilfeldige?
c) Passer spredningen mellom de tre gjennomsnittene med teorien?
a) Vi regner utvalg A i sin helhet, og fører de to andre på samme måte.
Avvikene fra 20,04 er ; ; ; ; — og de summerer til 0, som de skal. De kvadrerte avvikene summerer til
De tre utvalgene gir:
| Utvalg A | 20,04 | 0,34 |
| Utvalg B | 20,06 | 0,30 |
| Utvalg C | 20,02 | 0,34 |
b) mm og mm er faste. De er egenskaper ved maskinen, og de er de samme uansett hvem som måler.
De seks tallene i tabellen er tilfeldige. Ingen av de tre kontrollørene fikk nøyaktig 20,0, og ingen fikk nøyaktig 0,4 — men alle traff i nærheten. Det er slik det skal være: er et estimat for , ikke selv.
c) Teorien sier at gjennomsnittene skal svinge med
De tre målte gjennomsnittene ligger ; og mm fra — altså godt innenfor 0,18 mm. Det passer fint. (Med bare tre utvalg kan vi ikke si mer enn det; ingen av dem ligger urimelig langt unna.)
Svar: a) Se tabellen. b) og er faste, og er tilfeldige. c) Ja — alle tre ligger innenfor ett standardavvik mm fra .
NB: Legg merke til de to spredningstallene igjen. Enkeltboltene varierer med omtrent 0,34 mm (), mens gjennomsnittet av fem varierer med bare 0,18 mm (). Det er den samme forskjellen som i eksempel 3 — og den er hele grunnen til at vi måler flere ganger.
Avgjør for hvert utsagn om størrelsen hører til DATA (et utvalg) eller til MODELLEN, og hvilket symbol som er riktig.
«Vi målte 40 elever og fant en snitthøyde på 172 cm.»
«Terningens forventede antall øyne er 3,5.»
«Spredningen i utvalget var 6,2 cm, regnet med regnearkets STDAV.S.»
«Maskinen er spesifisert med et standardavvik på 0,4 mm.»
«Måler vi 40 nye elever, får vi neppe nøyaktig 172 cm igjen.» Hvilken av de fire størrelsene i a)–d) har denne egenskapen, og hvilke har den ikke?
En terning har og (fra kapittel 5.3). Vi kaster den ganger og regner gjennomsnittet av øynene. Rund av til tre desimaler.
Finn og når .
Finn når .
Finn når .
Sammenlign de tre svarene med innledningen til avsnittet om loven om store tall. Stemmer tallene med beskrivelsen der?
En elev påstår at når . Vis at dette er umulig.
Oppsummering
- Hold de to verdenene fra hverandre: og kommer fra data og er tilfeldige; og hører til modellen og står stille.
- og .
- Vi deler på fordi avvikene måles fra , som selv er regnet ut av de samme dataene. Summen blir derfor systematisk for liten, og retter opp skjevheten slik at — det er variansen som blir forventningsrett, ikke selv. Bare av avvikene bærer ny informasjon — de er frihetsgradene.
- Loven om store tall: når vokser.
- Fordelingen til gjennomsnittet: og . Midtpunktet flytter seg ikke; spredningen krymper.
- Aldri — det ville betydd at gjennomsnittet av mange terningkast går mot null.
- For å halvere usikkerheten i et gjennomsnitt må antall målinger firedobles.
- I regneark: STDAV.S for utvalg (), STDAV.P for hele populasjonen ().
Dette er siste kapittel i seksjon 5. I kapittel 6 skal vi se hvorfor gjennomsnittet ikke bare sikter riktig, men også får en helt bestemt form når vokser — den normalfordelte klokkekurven.
=TILFELDIGMELLOM(1;6), og husk at terningen har og .Lag 200 rader med 5 terningkast hver (kolonne A–E). Regn gjennomsnittet av hver rad i kolonne F.
Regn gjennomsnittet av hele kolonne F. Hvilket tall bør det ligge nær, og hva sier det om ?
Regn =STDAV.P(F1:F200) for kolonne F. Hvilket tall sier teorien at dette skal ligge nær?
Lag to nye kolonner: i kolonne G regner du =VARIANS.P(A1:E1) (deler på 5) og i kolonne H =VARIANS.S(A1:E1) (deler på 4), for hver rad. Regn så gjennomsnittet av hver av de to kolonnene.
Hva viser sammenligningen i d)?
«Måler vi nok, blir til slutt nøyaktig lik .» Drøft.
« betyr at enkeltmålingene blir mindre spredt når vi måler flere.» Hva er feilen?
En avis skriver at en meningsmåling med 1000 spurte har «dobbelt så stor usikkerhet» som en med 2000. Er det riktig?
En elev har hele klassens 27 karakterer og vil beskrive spredningen i klassen. Skal hun bruke STDAV.S eller STDAV.P?
Hvorfor spiller forskjellen mellom og nesten ingen rolle i store datasett?
Dette kapitlet er skrevet av Anthropics toppmodeller (Claude Opus og Claude Fable) og er foreløpig ikke manuelt gjennomgått — kvalitetskontrollen gjøres av uavhengige KI-agenter, og innmeldte feil rettes fortløpende. Funnet en feil? Meld fra, så retter vi den. Les mer om hvordan innholdet lages.