
Sannsynlighetstabeller, regneark og GeoGebra for P(X = k), P(X ≤ k) og P(X ≥ k); forventning og varians.
Binomisk fordeling med tabeller og digitale verktøy
I kapittel 5.4 regnet vi for hånd, ett ledd om gangen. Det går fint så lenge vi bare trenger ett ledd. Men hva om spørsmålet er «minst 8 av 12 består»? Da må vi summere fem ledd. Og «minst 100 av 145»? Da er det 46 ledd, og håndregning er utelukket.
Heldigvis trenger vi ikke regne dem. Sannsynlighetstabeller og digitale verktøy gir oss summen direkte. Det eneste vi må kunne, er å oversette spørsmålet i oppgaveteksten til det oppslaget verktøyet faktisk tilbyr.
Alt er bygget på
Både tabeller og verktøy er bygget rundt én størrelse: den kumulative sannsynligheten
Alle andre spørsmål skrives om til denne. Det er verdt å lære oversettelsen godt — den er den samme uansett hvilket verktøy du bruker:
| Spørsmålet | Skrives | Slås opp som |
|---|---|---|
| høyst | ||
| færre enn | ||
| minst | ||
| mer enn | ||
| nøyaktig | ||
| mellom og |
NB — den vanligste feilen: i «minst » er det som skal inn i oppslaget, ikke . Grunnen er at selv hører til «minst », og derfor ikke skal trekkes fra. Tenk alltid: hva er det motsatte? Det motsatte av «minst 8» er «høyst 7».
Sannsynlighetstabellen
En binomisk sannsynlighetstabell gir for et fast antall forsøk. Her er tabellen for :
| 0 | 0,3487 | 0,0563 | 0,0010 | 0,0000 |
| 1 | 0,7361 | 0,2440 | 0,0107 | 0,0000 |
| 2 | 0,9298 | 0,5256 | 0,0547 | 0,0004 |
| 3 | 0,9872 | 0,7759 | 0,1719 | 0,0035 |
| 4 | 0,9984 | 0,9219 | 0,3770 | 0,0197 |
| 5 | 0,9999 | 0,9803 | 0,6230 | 0,0781 |
| 6 | 1,0000 | 0,9965 | 0,8281 | 0,2241 |
| 7 | 1,0000 | 0,9996 | 0,9453 | 0,4744 |
| 8 | 1,0000 | 1,0000 | 0,9893 | 0,7560 |
| 9 | 1,0000 | 1,0000 | 0,9990 | 0,9437 |
| 10 | 1,0000 | 1,0000 | 1,0000 | 1,0000 |
Slik leser du den: gå inn i kolonnen for riktig , gå ned til raden for riktig , og les av .
To ting å merke seg:
- Tallene i en kolonne vokser nedover og ender på 1,0000. Det må de — når når , har vi tatt med alle utfallene.
- 1,0000 i tabellen betyr «1 når vi runder av til fire desimaler», ikke at sannsynligheten er nøyaktig 1. For og er den egentlige verdien 0,99999.
Isak gjetter på 10 flervalgsspørsmål med 4 alternativer hver. La være antall riktige.
Bruk tabellen over til å finne
a)
b)
c)
d)
Hva vet vi? Fordelingen er binomisk, med
Vi skal altså bruke kolonnen hele veien.
a) «Høyst 3 riktige» er oppslaget slik det står. Vi går til raden :
b) «Minst 4 riktige». Det motsatte er «høyst 3», altså det vi nettopp fant:
(Legg merke til at det er vi slår opp, ikke 4.)
c) «Nøyaktig 3 riktige» er differansen mellom to nabooppslag:
Kontroll med formelen fra kapittel 5.4:
Samme svar — tabellen og formelen er to veier til det samme.
d) «Mellom 2 og 4, begge tatt med». Vi tar alt til og med 4, og trekker fra alt til og med 1:
Svar: a) b) c) d)
(Regner vi uten avrunding, blir d) 0,67785. Når vi trekker to tabellverdier fra hverandre, mister vi alltid litt presisjon — svar derfor med tre desimaler her.)
Tolkning av b): Gjetter du på ti flervalgsspørsmål, er sannsynligheten for å få minst 4 riktige omtrent 22 %. Gjetting er altså ikke helt håpløst — men det er heller ikke noen strategi.
Vi kaster en mynt 10 ganger. La være antall kron, så og . Bruk tabellen i kapittelet og svar med fire desimaler.
Finn .
Finn .
Hvorfor er svarene i a) og b) like?
Finn .
Finn .
Regneark og GeoGebra
En tabell dekker bare noen få verdier av og . Digitale verktøy dekker alle.
I regneark er det én funksjon, og et siste argument som avgjør hva du får:
| Du vil ha | Formel |
|---|---|
=BINOM.FORDELING.N(k; n; p; USANN) | |
=BINOM.FORDELING.N(k; n; p; SANN) |
Det siste argumentet er hele forskjellen:
USANN gir det enkelte leddet, SANN gir summen til og med . (I eldre regneark heter funksjonen BINOM.FORDELING, og i engelsk versjon BINOM.DIST.)I GeoGebra skriver du kommandoen rett i inntastingsfeltet:
FordelingBinomial(10, 0.25, 3, false)    gir P(X = 3)
FordelingBinomial(10, 0.25, 3, true)     gir P(X <= 3)
Argumentene er i rekkefølgen , , og så sann/usann for kumulativ.
På kalkulator heter funksjonene som regel binompdf(n, p, k) for og binomcdf(n, p, k) for — pdf for det enkelte leddet, cdf for summen.
NB: Uansett verktøy må du selv gjøre oversettelsen i tabellen over. Ingen av dem har en knapp for «minst 8».
Ved en trafikkstasjon består 74 % av kandidatene oppkjøringen. En trafikkskole melder opp 12 elever, og vi antar at forutsetningene for binomisk fordeling er oppfylt.
Finn sannsynligheten for at minst 8 av de 12 består.
Hva vet vi? Fordelingen er binomisk, med
Hva må vi finne? — i klartekst: sannsynligheten for at antall elever som består, er minst 8.
Steg 1 — oversett. Det motsatte av «minst 8» er «høyst 7»:
Steg 2 — slå opp. Tabellen i kapittelet dekker ikke , så vi bruker verktøy:
regneark:   =1 - BINOM.FORDELING.N(7; 12; 0,74; SANN)
GeoGebra:   1 - FordelingBinomial(12, 0.74, 7, true)
Oppslaget gir , og dermed
Svar: , altså omtrent 82 %.
NB: Hadde vi slått opp i stedet for , hadde vi fått — et helt annet og galt svar. Vi ville da ha regnet ut , altså utelatt de tilfellene der nøyaktig 8 består. Det er denne ene indeksen som avgjør oppgaven.
En quiz har 20 spørsmål med fire svaralternativer hver. Mari gjetter på alle. La være antall riktige, så og . Bruk digitale verktøy og svar med fire desimaler. Skriv opp formelen du taster inn.
Finn .
Finn .
Finn .
For å bestå må Mari ha minst 12 riktige. Finn sannsynligheten for at hun består ved ren gjetting.
Kommenter svaret i d) med én setning.
Her trenger vi altså ikke fordelingstabellen i det hele tatt — tre tall inn, svaret ut.
Hvor formlene kommer fra: er summen av uavhengige delforsøk som hvert gir 0 eller 1. Ett slikt forsøk har og — det er to linjer med definisjonene fra kapittel 5.2 og 5.3. Forventningsverdier og varianser til uavhengige ledd legges sammen, og like ledd gir derfor og .
Hvorfor ? Gjør du 100 forsøk der hvert lykkes med sannsynlighet 0,3, er det rimelig å vente omtrent 30 suksesser. Formelen sier nøyaktig det: forventet antall er antall forsøk ganger sjansen per forsøk.
Når er variansen størst? Uttrykket er størst når , og går mot 0 når nærmer seg 0 eller 1. Det er rimelig: et forsøk som nesten alltid lykkes, er forutsigbart. Et forsøk som er femti–femti, er så uforutsigbart som det går an å bli.
En souvenirbutikk i Bergen vet at 70 % av kundene er turister. En dag kommer det 145 kunder. La være antall turister blant dem.
a) Finn og .
b) Finn .
c) Er svaret i b) rimelig i forhold til svaret i a)?
Hva vet vi? Fordelingen er binomisk, med
a) Vi skriver formelen tom først, og setter så inn:
Vi venter altså omtrent 101–102 turister, med et typisk avvik på rundt 5,5.
b) «Minst 100». Det motsatte er «høyst 99»:
regneark:   =1 - BINOM.FORDELING.N(99; 145; 0,7; SANN)
GeoGebra: 1 - FordelingBinomial(145, 0.7, 99, true)c) Ja. Grensen 100 ligger like under forventningsverdien 101,5 — bare omtrent standardavvik unna. At det er litt mer enn 50 % sannsynlig å havne over en grense som ligger litt under midten, er nøyaktig som ventet. Svaret 0,645 består altså rimelighetssjekken.
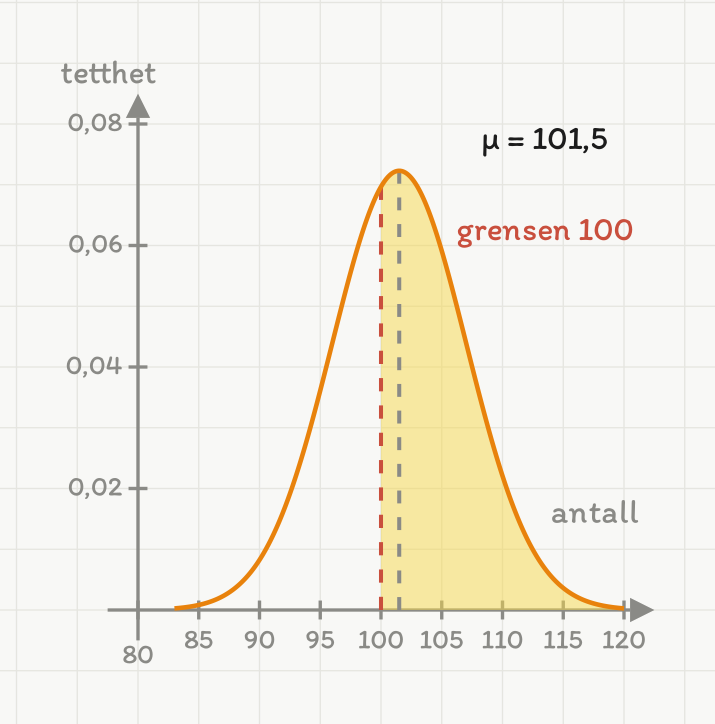
Hvorfor må ligge litt over 0,5: grensen 100 ligger under forventningsverdien , men bare med knapt et kvart standardavvik (). Det gule feltet er derfor litt større enn halve klokka — akkurat den rimelighetsvurderingen deloppgaven ber om. Kurven er normaltilnærmingen til den binomiske fordelingen, og streken er satt i 100 fordi det er grensen i deloppgaven. Skal arealet stemme med svaret, må heltallskorreksjonen fra kapittel 6.5 brukes: med grensen blir arealet , mens grensen gir .
Svar: a) og . b) . c) Ja — grensen ligger like under .
NB: Dette er en god vane. Regn alltid ut først, også når oppgaven ikke spør om den. Da vet du omtrent hvor svaret skal ligge, og du oppdager tasteflis med én gang.
En kommune vet at 12 % av innbyggerne har lånt en bok på biblioteket den siste måneden. Det trekkes ut 50 tilfeldige innbyggere. La være antall av dem som har lånt en bok.
Finn .
Finn og .
Finn .
Finn .
I det virkelige utvalget var det 13 som hadde lånt en bok. Ligger det innenfor det vi kunne vente? Bruk og i svaret.
Et teater har 200 seter. Erfaringen er at 5 % av dem som har kjøpt billett, ikke møter opp. Teatret vurderer derfor å selge 210 billetter. La være antall som møter opp.
a) Finn og når det selges 210 billetter.
b) Finn sannsynligheten for at flere enn 200 møter opp, slik at noen ikke får plass.
c) Hvor mange billetter bør teatret selge hvis denne sannsynligheten skal være under 5 %?
a) Hver billettkjøper møter opp med sannsynlighet , uavhengig av de andre. Fordelingen er binomisk, med
b) «Flere enn 200» er , som slås opp som :
regneark: =1 - BINOM.FORDELING.N(200; 210; 0,95; SANN)Nesten 40 %. Det er altfor høyt — omtrent hver tredje forestilling ville hatt gjester uten sete.
(Rimelighetssjekk: ligger bare et halvt sete under grensen på 200, og . At sannsynligheten for å komme over grensen da er i nærheten av 40 %, stemmer godt.)
c) Vi prøver oss fram med færre billetter. Med blir , og
Det er under 5 %. Teatret bør altså selge omtrent 205 billetter, ikke 210.
Svar: a) og . b) . c) Omtrent 205 billetter.
NB: Her ser vi hvorfor er uunnværlig. Forventningsverdien alene sa 199,5 — trygt under 200. Men et typisk avvik på drøye 3 seter betyr at «trygt under» ikke er trygt i det hele tatt.
Et flyselskap vet at 4 % av passasjerene ikke møter til avgang. Flyet har 180 seter, og selskapet selger 185 billetter. La være antall som møter opp. Svar med fire desimaler der ikke annet står.
Oppgi og .
Finn .
Finn med to desimaler.
Finn sannsynligheten for at flere enn 180 møter opp.
Selskapet vil at denne sannsynligheten skal være under 2 %. Prøv med 183 billetter, og så med 182. Hvor mange billetter bør selges?
Oversett hvert spørsmål til et oppslag i formen . Du skal ikke regne ut noe tall — bare skrive om.
«Høyst 6 av 20.»
«Minst 9 av 20.»
«Færre enn 4 av 20.»
«Flere enn 15 av 20.»
«Mellom 7 og 12 av 20, begge tatt med.»
Oppsummering
- Tabeller og verktøy gir kumulative sannsynligheter . Alt annet skrives om til dette.
- Oversettelsen er det du må kunne: «minst » blir , «flere enn » blir , «nøyaktig » blir .
- Regneark: =BINOM.FORDELING.N(k; n; p; SANN) for , USANN for .
- GeoGebra: FordelingBinomial(n, p, k, true) for , false for .
- Kalkulator: binomcdf(n, p, k) og binompdf(n, p, k).
- For binomisk fordeling slipper vi fordelingstabellen: , og — se teoremet i kapittelet for hvor de kommer fra.
- Regn alltid først som rimelighetssjekk, også når oppgaven ikke ber om det.
Så langt har alle variablene vært diskrete — de har telt noe. I kapittel 5.6 slipper vi tellingen og ser på variabler som måler.
Lag kolonne B med ved formelen =BINOM.FORDELING.N(A5;$B$1;$B$2;USANN), kopiert nedover. Sett og , og kontroller at kolonnen summerer til 1.
Lag kolonne C med (SANN i stedet for USANN), og sammenlign med tabellen i kapittelet.
Lag et søylediagram av kolonne B. Endre til 0,50 og så til 0,75. Hva skjer med formen på diagrammet?
Legg inn og i to celler. Sett og la vokse: 10, 40, 160. Hva skjer med i forhold til ?
Behold og . Finn og kommenter resultatet i lys av svaret i d).
En elev skriver =1 - BINOM.FORDELING.N(8; 12; 0,74; SANN) for å finne . Hva blir galt, og hvor stor blir feilen?
« betyr at alltid er et mulig antall.» Vurder påstanden.
To binomiske fordelinger har . Den ene har , den andre . Hvilken har størst standardavvik, og hvorfor er det rimelig?
Et oppslag gir og . Hva vet du umiddelbart?
Hvorfor gir tabellen 1,0000 for allerede ved , selv om kan bli så stor som 10?
Dette kapitlet er skrevet av Anthropics toppmodeller (Claude Opus og Claude Fable) og er foreløpig ikke manuelt gjennomgått — kvalitetskontrollen gjøres av uavhengige KI-agenter, og innmeldte feil rettes fortløpende. Funnet en feil? Meld fra, så retter vi den. Les mer om hvordan innholdet lages.