
Var(X) og SD(X) for stokastiske variabler, og hva de sier om uvisse og variasjon.
Varians og standardavvik
Se på disse to stokastiske variablene:
Variabelen :
| 9 | 11 | |
|---|---|---|
| 0,5 | 0,5 |
Variabelen :
| 0 | 20 | |
|---|---|---|
| 0,5 | 0,5 |
Begge har forventningsverdi 10. Likevel oppfører de seg helt forskjellig: bommer på 10 med bare 1, hver eneste gang. bommer med 10.
Forventningsverdien alene sier altså ikke nok. Vi trenger et tall til — et tall som måler hvor spredt verdiene ligger rundt . Det tallet er variansen, og kvadratroten av den er standardavviket.
Hvorfor kvadrerer vi?
Det naturlige første forsøket er å måle hvor langt ligger fra , altså avviket , og så ta gjennomsnittet av avvikene. Men det virker ikke. Prøv på over, der :
Summen ble 0 — og den blir alltid 0, for enhver fordeling. De negative avvikene spiser opp de positive.
Løsningen er å kvadrere avvikene først. Da blir alle bidrag positive, og store bom straffes hardere enn små. Gjennomsnittet av de kvadrerte avvikene kaller vi variansen.
Variansen til er det vektede gjennomsnittet av de kvadrerte avvikene fra :
Standardavviket til er kvadratroten av variansen:
NB om enheter: måles i kilo, måles variansen i kilo i andre — den er kvadrert. Standardavviket derimot har samme enhet som selv. Det er derfor standardavviket er det tallet vi tolker: det sier omtrent hvor langt fra en tilfeldig verdi pleier å ligge.
Alternativ 1: vi utvider tabellen
Variansen krever at vi kjenner først. Derfor regner vi alltid og i samme tabell, og legger bare på én rad:
| … | … | … | Sum |
|---|---|---|---|
| 1 | |||
Rad 4 kan ikke fylles før Sum-cella i rad 3 er ferdig — må stå der før avvikene kan regnes.
I hver celle i rad 4 fører vi to linjer: først innsettingen, så det utregnede kvadratet. For eksempel, når og :
Vi lar brøken stå uforkortet, akkurat som i forventningsverdien — den skal summeres.
La være antall øyne på en vanlig terning. Finn og .
Hva vet vi? Verdiene 1 til 6, hver med sannsynlighet , og fra eksempel 1 i kapittel 5.2: .
Hva må vi finne? Først variansen, så standardavviket.
Vi fyller rad 4 i tabellen. Hver celle føres på to linjer — innsetting, så kvadrat:
| 1 | 2 | 3 | 4 | 5 | 6 | Sum | |
|---|---|---|---|---|---|---|---|
| 1 | |||||||
Slik ble den første cella til:
og den andre:
De tre siste cellene er speilbilder av de tre første, fordi fordelingen er symmetrisk om 3,5. (At føres ikke — vi ser det.)
Formelen først, så tallrekka:
Standardavviket er kvadratroten:
Svar: og .
Tolkning: Et terningkast bommer typisk på 3,5 med omtrent 1,7 øyne.
Gjør den samme utregningen som i eksempel 1 for en åttesidet terning med sidene 1 til 8, alle like sannsynlige. Rund av til to desimaler der det trengs.
Finn .
Regn ut cellen for i rad 4, med begge linjene.
Finn .
Finn .
Sammenlign med den vanlige terningen (). Hvilken av dem har mest spredning, og hvorfor er det rimelig?
Vi fortsetter med sekkene fra kapittel 5.2: en fjerdedel veier 4 kg, halvparten veier 5 kg og en fjerdedel veier 10 kg. Vi vet at kg.
Finn og .
Hva vet vi? Verdiene 4, 5 og 10 med sannsynligheter , og , og kg.
Vi regner hver celle i rad 4 på to linjer:
Formelen først, så tallene:
Svar: og kg.
Tolkning: En tilfeldig sekk veier 6 kg i gjennomsnitt, og bommer typisk på det med omtrent 2,4 kg. Legg merke til hvem som bidrar mest til variansen: 10 kg-sekken er sjelden (), men ligger så langt unna at den alene står for 4 av de 5,5. Det er kvadreringen som gjør det — store avvik veier tungt.
Vi fortsetter med pakkene fra kapittel 5.2: , og , med kg. Rund av til to desimaler.
Regn ut cellen for .
Regn ut cellen for .
Regn ut cellen for .
Finn .
Finn , og forklar hva tallet betyr i denne sammenhengen.
Her er — vi kvadrerer verdiene, ikke avvikene.
På sekkene fra eksempel 2:
Samme svar, som seg hør og bør.
Vurdering: Snarveien er raskere når er et stygt desimaltall, for da slipper vi å trekke det fra i hver eneste celle. Men den skjuler hva variansen er — at den måler avvik fra . Bruk definisjonen når du skal forstå eller forklare, og snarveien når du bare skal komme fram til et tall. Og husk: det er som trekkes fra, ikke .
En stokastisk variabel har fordelingen
| 0 | 1 | 4 | 6 | |
|---|---|---|---|---|
| 0,30 | 0,40 | 0,10 | 0,20 |
Regn ut variansen på begge måter, og sjekk at du får samme svar. Måte 2 er snarveien fra merknaden «Alternativ 2» — en alternativ vei, ikke hovedmetoden.
Finn .
Finn med definisjonen .
Finn . (alternativ vei, se merknaden)
Kontroller svaret i b) med snarveien . (alternativ vei, se merknaden)
Finn .
Iselin kan velge mellom buss og sykkel til skolen. Hun har målt reisetidene i minutter:
Buss (): 20 min med sannsynlighet 0,7 · 25 min med 0,2 · 40 min med 0,1
Sykkel (): 22 min med sannsynlighet 0,5 · 24 min med 0,5
a) Finn og .
b) Finn og .
c) Hvilket alternativ bør hun velge hvis hun absolutt ikke kan komme for sent?
a) Buss:
Sykkel:
Begge bruker altså 23 minutter i gjennomsnitt. Forventningsverdien skiller dem ikke.
b) Buss, celle for celle:
Sykkel:
c) Her ser vi hva standardavviket er godt for. Begge alternativene har min, men bussen har min mot sykkelens min. Bussen er som regel litt raskere enn sykkelen (20 min i 70 % av tilfellene), men i 10 % av tilfellene tar den 40 minutter — og det er den halen som gjør den upålitelig.
Kan hun ikke risikere å komme for sent, bør hun sykle: reisetiden er så å si alltid 22–24 minutter.
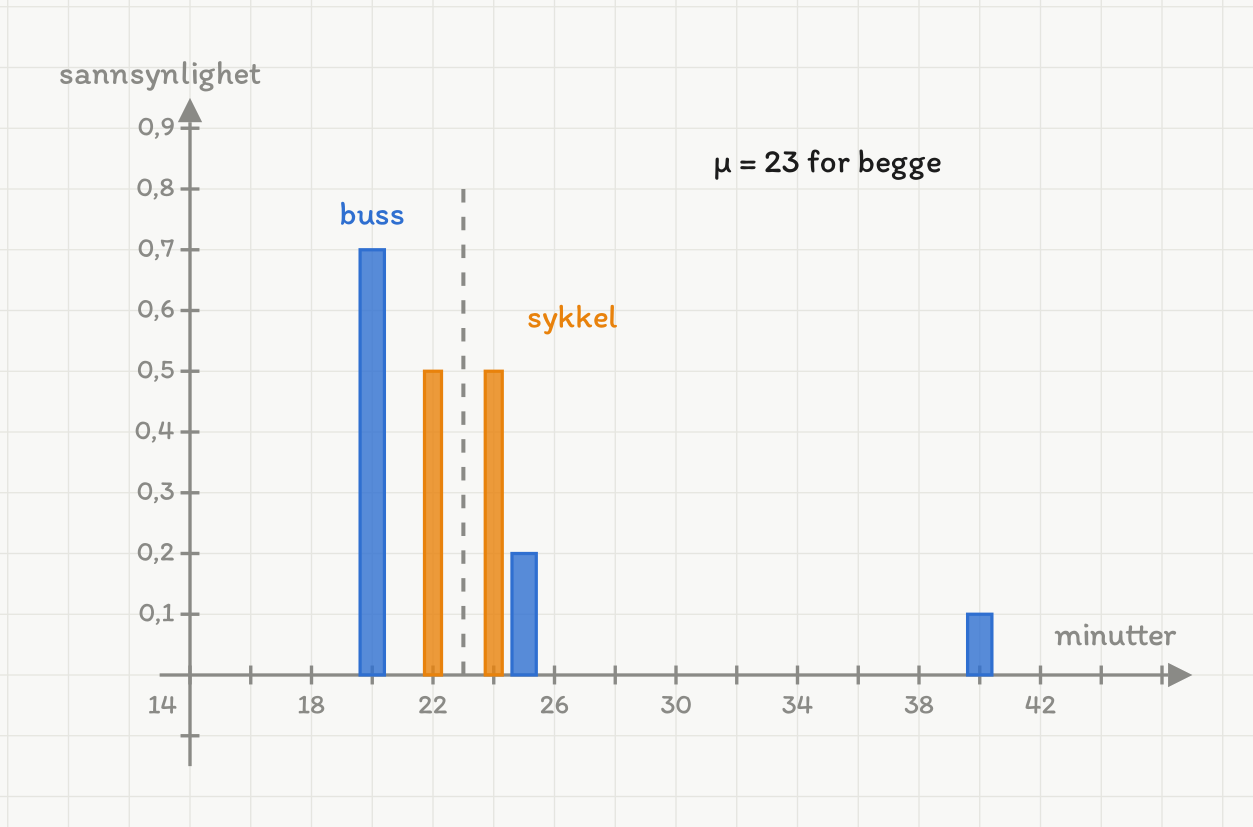
Begge har minutter, men bussen har en hale ut til 40. Det er den ene søyla langt til høyre som gjør variansen stor — og den er hele svaret på hvorfor sykkelen er den tryggere av de to, selv om de bruker like lang tid i gjennomsnitt.
Svar: a) Begge har min. b) min, min. c) Sykkelen — samme forventede tid, langt mindre uvisse.
To spill har samme innsats. I spill A vinner du 0 kr eller 100 kr, med sannsynlighet 0,5 på hver. I spill B vinner du 40 kr eller 60 kr, med sannsynlighet 0,5 på hver.
Finn forventet gevinst i spill A.
Finn forventet gevinst i spill B.
Finn for spill A.
Finn for spill B.
Du får spille bare én gang og trenger minst 40 kr. Hvilket spill velger du? Begrunn med tallene.
Legg merke til at forsvinner. Legger vi det samme tallet til alle utfallene, flyttes hele fordelingen sidelengs — men avstandene mellom verdiene, og dermed spredningen, er uendret.
Faktoren derimot strekker fordelingen. Standardavviket ganges med , og variansen med fordi variansen er en kvadrert størrelse.
En kafé har bestillinger i timen, med og . Hver bestilling gir 85 kr, og kaféen har faste kostnader på 450 kr i timen. Overskuddet er .
Finn , og .
Hva vet vi? , , og , altså og .
Forventningsverdien følger regelen fra kapittel 5.2:
Variansen følger regelen over. De faste kostnadene faller ut:
Standardavviket:
(Vi kunne like godt tatt — samme tall, som seg hør og bør.)
Svar: kr, og kr.
Tolkning: Kaféen tjener 570 kr i en gjennomsnittstime, men enkelttimer svinger med omtrent kr rundt dette. Legg merke til at de faste kostnadene på 450 kr senker forventet overskudd, men ikke gjør det mer uforutsigbart — de er de samme hver time.
La være antall øyne på en vanlig terning, med og . Rund av til to desimaler der det trengs.
La . Finn og .
Forklar hvorfor variansen i a) ikke endret seg.
La . Finn , og .
I et spill får du kroner utbetalt og betaler 40 kr i innsats. Finn forventet nettogevinst og standardavviket til nettogevinsten.
Hvilken innsats ville gjort spillet rettferdig? Endrer det standardavviket?
Oppsummering
- Variansen er det vektede gjennomsnittet av de kvadrerte avvikene fra . Vi kvadrerer fordi de ukvadrerte avvikene alltid summerer til 0.
- Standardavviket har samme enhet som , og er derfor det tallet vi tolker: omtrent hvor langt fra en tilfeldig verdi pleier å ligge.
- Vi regner og i samme tabell. Rad 4 kan ikke fylles før står i Sum-cella i rad 3. Hver celle føres på to linjer: innsetting, så kvadrat.
- Snarveien gir samme svar og sparer regning — men skjuler hva variansen måler.
- og . Konstantleddet faller ut.
- To fordelinger kan ha samme og helt ulik . Da er det som avgjør valget.
I kapittel 5.4 møter vi den viktigste diskrete fordelingen av alle — den binomiske — og der finnes det ferdige formler for både og .
| 1 | 2 | 3 | 4 | 5 | 6 | |
|---|---|---|---|---|---|---|
| 0,40 | 0,28 | 0,13 | 0,12 | 0,05 | 0,02 |
Sett opp hele utregningen i et regneark, med én kolonne per rad i tabellen vår. Rund av til to desimaler.
Kontroller at sannsynlighetene summerer til 1, og finn med =SUMMERPRODUKT(A2:A7;B2:B7).
Lag en kolonne med — bruk absolutt referanse til -cella, for eksempel =(A2-$E$1)^2*B2. Finn .
Finn .
Kontroller svaret i b) med snarveien i en egen kolonne. (alternativ vei, se merknaden)
En kommune har 12 000 husholdninger. Omtrent hvor mange innbyggere bor i dem? Hvorfor er dette anslaget mye sikrere enn anslaget for én enkelt husholdning?
«Variansen kan bli negativ hvis mange verdier ligger under .»
Når er ?
En elev regner ut og får et negativt tall. Hva er feilen? (alternativ vei, se merknaden)
«To fordelinger med samme standardavvik er like risikable.» Drøft, og bruk gjerne et eksempel der den ene har og den andre .
Hvorfor oppgir vi som regel standardavviket og ikke variansen når vi skal fortelle noen hvor spredt en variabel er?
Dette kapitlet er skrevet av Anthropics toppmodeller (Claude Opus og Claude Fable) og er foreløpig ikke manuelt gjennomgått — kvalitetskontrollen gjøres av uavhengige KI-agenter, og innmeldte feil rettes fortløpende. Funnet en feil? Meld fra, så retter vi den. Les mer om hvordan innholdet lages.