
Hvordan statistikk brukes til å belyse og til å villede — med eksempler fra medier og politikk.
Tall som argument
Statistikk er ikke bare et fag. Det er infrastrukturen i en opplyst offentlig
samtale: uten felles tall kan to parter være uenige om hva som faktisk er
tilfelle, og da kommer de aldri til det de egentlig er uenige om.
Derfor finnes offentlig statistikk. Statistisk sentralbyrå (SSB) er ved lov
faglig uavhengig, og tallene publiseres åpent slik at hvem som helst kan regne
etter. Det samme gjelder Udirs skolestatistikk, Folkehelseinstituttets
helsetall og kommunenes KOSTRA-rapportering.
Dette kapittelet handler om hva som skjer med slike tall når de går inn i en
debatt — og hvordan du leser dem uten å måtte velge side for å vite hva de
betyr.
I kapittel 1.6 så vi på hvordan framstillingen kan villede. Nå ser vi på
argumentet: fem grep som gjør at et sant tall likevel gir et galt inntrykk.
Det kan bety at én av ble til én av . Relative tall gjør små
endringer store, og absolutte tall gjør store endringer små. Ærlig framstilling
oppgir begge.
2. Én måling eller en trend? Enkeltmålinger svinger. En endring som er
mindre enn feilmarginen, er ikke en nyhet.
3. Hvilken nevner? Antall delt på hva — innbyggere, kjørte kilometer,
behandlede pasienter, kroner brukt? Nevneren avgjør ofte svaret helt.
4. Sammenlignet med hva? Ethvert tall trenger et sammenligningsgrunnlag:
samme periode i fjor, et område uten tiltaket, en gruppe som ellers er lik.
Uten det kan vi ikke vite om noe har skjedd.
5. Hvilken definisjon? «Ventetid», «arbeidsledig», «mobbet» og «fattig» er
alle målt etter en definisjon som noen har valgt. Endres definisjonen, endres
tallet — uten at virkeligheten har rørt seg.
Dette er ikke argumenter mot å bruke statistikk i debatt. Det er kravene som
gjør at statistikk kan brukes i debatt.
Et forebyggende tiltak «reduserer risikoen med ». Uten tiltaket får
av befolkningen tilstanden i løpet av et år. Tiltaket koster
kroner per person.
a) Hva blir risikoen med tiltaket?
b) Hvor stor er den absolutte reduksjonen?
c) Hvor mange må få tiltaket for å unngå ett tilfelle?
d) Hva koster det per unngåtte tilfelle?
Svar a): , altså tilfeller per i stedet for
.
b)
Svar b): prosentpoeng, altså færre tilfeller per
personer.
c) Hver person som får tiltaket, får risikoen sin redusert med .
For å få ett helt tilfelle unna må vi da ha
Svar c): Omtrent personer må få tiltaket for at ett tilfelle skal
unngås.
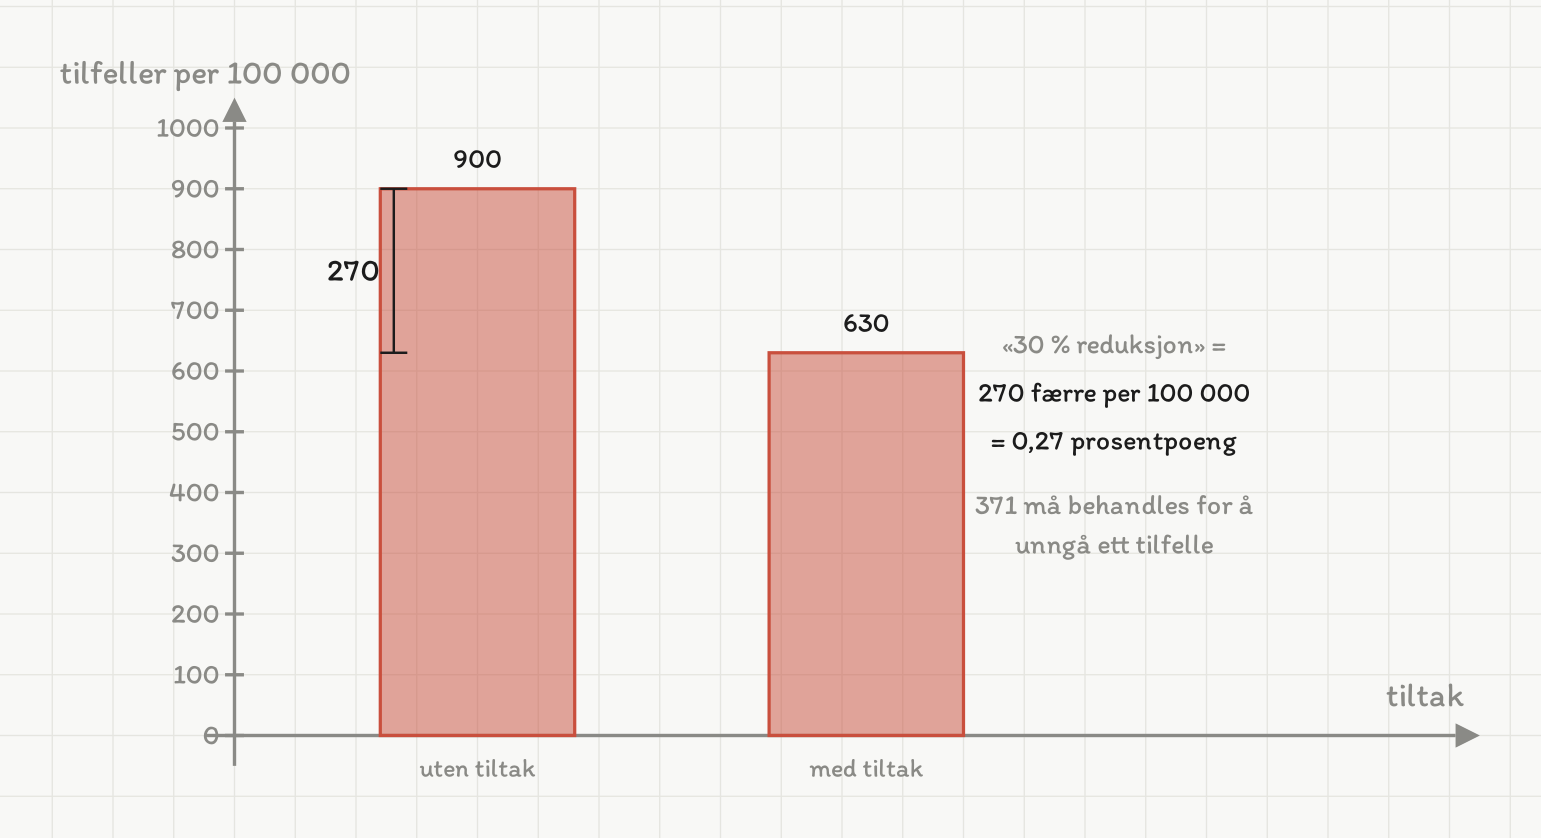
«30 % reduksjon» ser stort ut. I absolutte tall er det 270 færre tilfeller per 100 000 — 0,27 prosentpoeng — og 371 personer må behandles for å unngå ett tilfelle.
d)
Svar d): Omtrent kroner per unngåtte tilfelle.
Her ser vi at alle fire tallene beskriver det samme tiltaket:
| Framstilling | Tallet |
|---|---|
| Relativ reduksjon | |
| Absolutt reduksjon | prosentpoeng |
| Per | færre tilfeller |
| Antall som må behandles | |
| Kostnad per unngåtte tilfelle | kr |
Den som vil at tiltaket skal virke stort, oppgir det første tallet. Den som vil
at det skal virke lite, oppgir det tredje eller fjerde. Ingen av dem lyver.
Slik leser du kritisk: Møter du en prosentvis endring i en risiko, spør
alltid etter utgangspunktet. Uten det er tallet ikke tolkbart.
. Tilstand A rammer av befolkningen i utgangspunktet,
tilstand B rammer .
Hva blir de nye risikoene?
Hvor stor er den absolutte økningen i hvert tilfelle?
Gjør om de absolutte økningene til antall per .
Begge kan omtales med overskriften « prosent økt risiko». Hvorfor er det problematisk?
Hvilken av de to bør et helsevesen prioritere, alt annet likt?
Figuren over viser tolv månedsmålinger av et parti. Målingene har
hver, og i virkeligheten har oppslutningen ligget på nøyaktig hele
året — ingenting har endret seg.
a) Hva er variasjonsbredden mellom de tolv målingene?
b) Fra februar til mars falt tallet fra til . Kan den
endringen brukes som nyhet?
c) Skriv tre ulike, sanne overskrifter ut fra disse tallene.
(mars):
Svar a): prosentpoeng — og ikke én eneste velger har skiftet mening.
b) Feilmarginen for én måling er
og for en endring mellom to målinger
Fallet er prosentpoeng, altså godt innenfor .
Svar b): Nei. Endringen er omtrent halvparten av feilmarginen for en
endring (), og kan ikke skilles fra tilfeldig variasjon.
c) Alle disse er sanne om de samme tallene:
1. «Partiet falt to prosentpoeng i mars.» (Sant — og ren tilfeldighet.)
2. «Partiet har styrket seg gjennom høsten: fire målinger på rad over
.» (Sant — og ren tilfeldighet.)
3. «Partiet har ligget stabilt rundt hele året; alle tolv målingene
er innenfor feilmarginen.» (Sant — og dekkende.)
Svar c): Se de tre over. Bare den siste beskriver det som faktisk skjedde.
Her ser vi at en tilfeldig tallrekke inneholder «fall», «oppganger» og
«trender» hele tiden. Den som leter etter en historie i støyen, finner alltid
en.
Slik leser du kritisk: Sammenlign endringen med feilmarginen for endringen
— ikke med feilmarginen for én måling. Og se på hele rekken, ikke på de to
punktene som gir den ønskede retningen (kapittel 1.6).
Andre muligheter: Et snitt av flere byråers målinger demper både
utvalgsvariasjonen og byråenes egne systematiske forskjeller. Det er derfor
slike snitt er blitt vanlige.
, ga , , og
. Feilmarginen for én måling er prosentpoeng.
Finn gjennomsnittet av de fire målingene.
Hvor stor er variasjonsbredden mellom de fire?
Ligger alle fire innenfor feilmarginen fra gjennomsnittet?
Snittet av fire målinger på tilsvarer én måling på . Hva blir feilmarginen da?
En kommentator sier: «Målingen på viser at partiet er på vei opp.» Vurder.
En kommune innførte et tiltak 1. januar 2026. I første halvår 2026 ble det
registrert hendelser. I andre halvår 2025 var tallet .
| Periode | Hendelser |
|---|---|
| jan–jun 2024 | 398 |
| jan–jun 2025 | 405 |
| jul–des 2025 | 468 |
| jan–jun 2026 | 412 |
I nabokommunen, som ikke innførte tiltaket, gikk tallet fra i første
halvår 2025 til i første halvår 2026.
a) Regn ut endringen kommunen viser til.
b) Regn ut endringen mot samme halvår i fjor.
c) Hva sier sammenligningen med nabokommunen?
Svar a): Et fall på — akkurat som kommunen sier.
b) Vi sammenligner første halvår med første halvår:
Svar b): En økning på .
Her ser vi at tallet ser ut til å svinge med årstiden: andrehalvåret
() ligger høyere enn begge førstehalvårene ( og ). Å
sammenligne januar–juni med juli–desember måler derfor mest av alt sesongen.
NB: tabellen har bare ett andrehalvår, så dette er én observasjon.
Den holder til å si at sammenligningen er tvilsom, men ikke til å slå fast
hvor stor sesongeffekten er — til det trengs flere år.
c) Nabokommunen, uten tiltaket:
Mens tiltakskommunen gikk opp , gikk nabokommunen ned
i den samme perioden. Forskjellen er
i disfavør av tiltakskommunen.
NB: differansen regnes av de uavrundede prosentene. Bruker vi de
avrundede tallene og , får vi — en tidel unna.
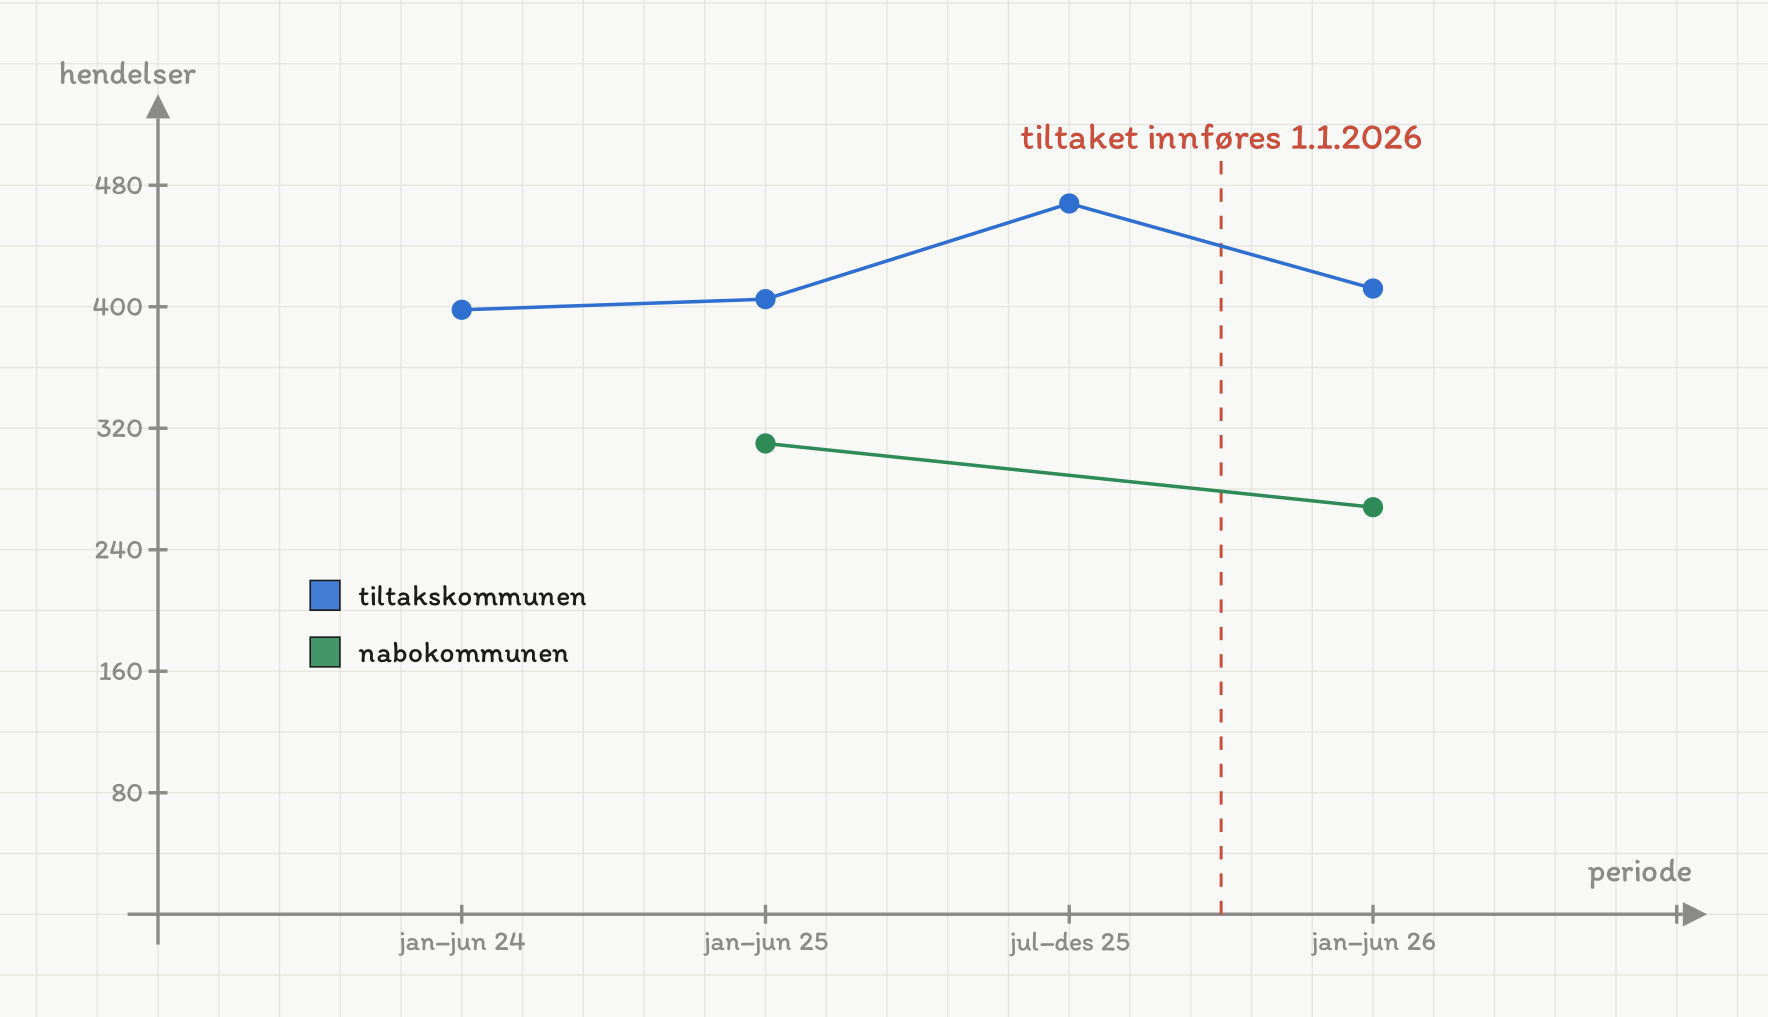
Samme tall, tre sammenligninger. Fallet fra 468 til 412 går over sesongskillet; måler vi i stedet samme halvår mot samme halvår (405 til 412), er det en økning på 1,7 %. Nabokommunen falt 13,5 % i den samme perioden.
Svar c): Sammenligningen gir ingen støtte til at tiltaket virket. Et eller
annet fikk tallene til å falle i nabokommunen, og den nedgangen kom ikke i
tiltakskommunen.
Slik leser du kritisk: Et «etter–før»-tall er nesten aldri nok. Tre
spørsmål må stilles:
1. Sesong: er periodene sammenlignbare?
2. Trend: hva var utviklingen før tiltaket?
3. Kontroll: hva skjedde samtidig der tiltaket ikke ble innført?
Sammenligningen i punkt 3 kalles differanse i differanse, og den er det
nærmeste vi kommer et forsøk når et ekte forsøk ikke kan gjennomføres.
En kommune innførte et tiltak i 2026. Antall registrerte hendelser var
i 2025 og i 2026. I en nabokommune uten tiltaket var tallene
og .
Hvor mange prosent falt tallet i tiltakskommunen?
Hvor mange prosent falt tallet i nabokommunen?
Regn ut differansen mellom de to endringene.
Hvilken konklusjon om tiltaket kan trekkes?
Hvilke forutsetninger må være oppfylt for at nabokommunen skal være en brukbar kontroll?
a) Finn gjennomsnittet og medianen.
b) Finn andelen som ventet over dager, og andelen under .
c) Skriv én overskrift til hver av de tre målene, og vurder hvilken som er
mest dekkende.
Medianen: er et partall, så medianen er gjennomsnittet av de to
midterste — plass og , altså og :
Svar a): Gjennomsnitt dager, median dager.
b) Over dager: og — fem pasienter.
Under dager: de tolv første i rekken.
Svar b): ventet over dager, og ventet
under .
c)
| Overskrift | Tallet den bygger på | Sann? |
|---|---|---|
| «Pasientene venter i snitt nesten to måneder» | gjennomsnitt | ja |
| «Halvparten kommer til innen en måned» | median | ja |
| «Hver femte pasient venter over tre måneder» | andel | ja |
Alle tre er riktige regnestykker på de samme tallene.
Gjennomsnittet er trukket kraftig opp av de fem lengste ventetidene — det er en
høyreskjev fordeling, akkurat som lønnsfordelingen i kapittel 1.2. Derfor
er dager ikke det en typisk pasient opplever; er nærmere.
Men medianen alene skjuler nettopp det som er problemet: at noen venter
dager.
Svar c): Ingen av de tre er dekkende alene. Det dekkende svaret oppgir
medianen og halen: «Medianventetiden er dager, men hver femte pasient
venter over tre måneder, og den lengste ventetiden var dager.»
Andre muligheter: Et boksplott (kapittel 1.5) viser alt dette i én figur —
median, kvartiler ( og ) og den lange halen.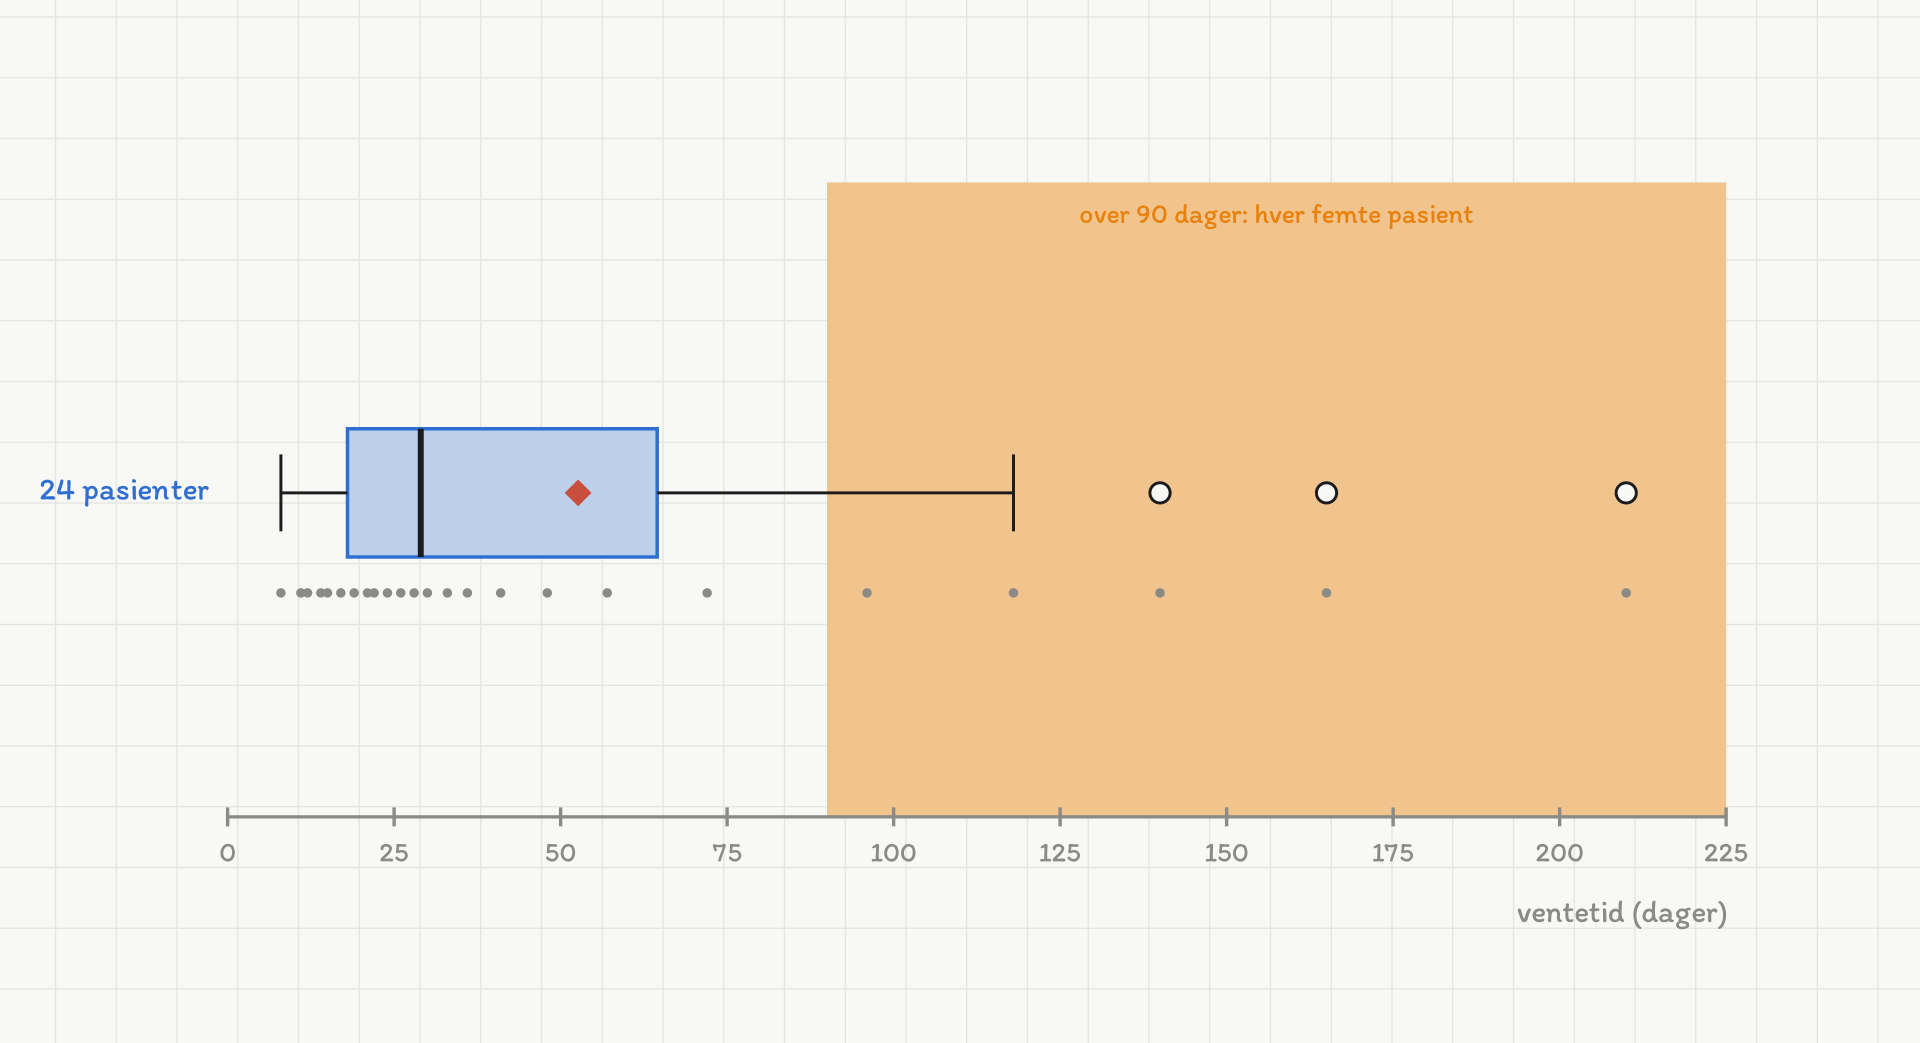
Alt i én figur: halvparten av pasientene ventet under 29 dager, men gjennomsnittet er 52,6 dager fordi noen få ventet svært lenge. Kvartilene er regnet med skolemetoden fra kapittel 1.3, der halvdelene deles ved medianen.
bedrift er
| 321 | 344 | 352 | 361 | 378 | 385 | 392 | 401 | 415 | 428 |
|---|---|---|---|---|---|---|---|---|---|
| 441 | 455 | 470 | 488 | 512 | 545 | 590 | 660 | 780 | 1240 |
Finn gjennomsnitt, median og standardavviket med regneark.
Hvor stor andel tjener over gjennomsnittet?
Ta bort den høyeste lønnen og regn ut på nytt. Hva skjer med de to sentralmålene?
Bedriften skriver i årsrapporten: «Gjennomsnittslønnen er nesten kroner.» En ansatt sier: «Halvparten av oss tjener under .» Hvem har rett?
Hvilke tall ville du oppgitt for at framstillingen skal være dekkende?
Åtte spørsmål, i denne rekkefølgen:
1. Hvem har målt? Et statistikkbyrå, et forskningsmiljø, en organisasjon
med en sak?
2. Hvem har betalt? Oppdragsgiveren skal alltid oppgis.
3. Hva er definisjonen? Hvordan er «ventetid», «ledig» eller «mobbet»
avgrenset i akkurat denne målingen?
4. Hvor mange, og hvem? , utvalgsmetode og svarprosent.
5. Når? Måletidspunktet, og hva som skjedde rundt det.
6. Relativt eller absolutt? Er utgangspunktet oppgitt?
7. Sammenlignet med hva? Sesong, trend, kontrollgruppe.
8. Er endringen større enn feilmarginen for endringen?
Og til slutt, det viktigste: Klarer du ikke å svare på 3, 4 og 7, kan tallet
ikke brukes som argument — uansett hvor mye du liker konklusjonen.
Det siste forbeholdet gjelder begge veier. Å kreve kildekritikk bare av tall du
er uenig i, er ikke kildekritikk.
Byrå 1 har og får . Byrå 2 har og får
.
Regn ut feilmarginen for hver måling med =1,96*ROT(p*(1-p)/n).
Oppgi et intervall for hver måling. Overlapper de?
Forskjellen er prosentpoeng. Feilmarginen for forskjellen er . Regn den ut.
En kommentator skriver: «Byråene spriker — ett av dem må ta feil.» Vurder.
Hva er det beste anslaget på partiets oppslutning, og hvordan ville du oppgitt det?
sider — for eksempel om et samferdselsprosjekt, en skolereform eller et
miljøtiltak.
Skriv opp det sentrale tallet hver side bruker, med kilde og definisjon.
Bruker sidene samme nevner, samme periode og samme definisjon?
Hvilke av de fem grepene fra dette kapittelet gjenkjenner du hos hver side?
Finnes det et felles tallgrunnlag begge kunne godtatt? Hvordan ville det sett ut?
Hvorfor er uavhengig offentlig statistikk viktig for en demokratisk debatt?
Oppsummering
I dette kapittelet har du lært:
| Grep | Spørsmålet du stiller |
|---|---|
| Relativ eller absolutt | Hva var utgangspunktet? |
| Enkeltmåling eller trend | Er endringen større enn feilmarginen for endringen? |
| Nevneren | Antall delt på hva — innbyggere, kilometer, pasienter? |
| Sammenligningsgrunnlag | Mot hva? Sesong, trend, kontrollområde |
| Definisjonen | Hvordan er begrepet avgrenset i akkurat denne målingen? |
Husk
- Den samme sanne tallrekken kan gi motsatte overskrifter. Regn selv.
- Feilmarginen for en endring er større enn for én måling.
- Et «etter–før»-tall uten kontrollgruppe eller sesongjustering sier lite.
- Gjennomsnitt, median og andel over en grense måler forskjellige ting. Oppgi
mer enn ett.
- Kildekritikk som bare brukes på tall du er uenig i, er ikke kildekritikk.
- Uavhengig offentlig statistikk er en forutsetning for at en debatt skal
handle om hva man bør gjøre, og ikke om hva som er tilfelle.
Dette kapitlet er skrevet av Anthropics toppmodeller (Claude Opus og Claude Fable) og er foreløpig ikke manuelt gjennomgått — kvalitetskontrollen gjøres av uavhengige KI-agenter, og innmeldte feil rettes fortløpende. Funnet en feil? Meld fra, så retter vi den. Les mer om hvordan innholdet lages.