
Tilfeldig, systematisk, stratifisert og klyngeutvalg — og bekvemmelighetsutvalg.
Hvordan utvalget trekkes, avgjør alt
I kapittel 3.1 så vi at et utvalg kan si noe om en hel populasjon. Det hviler
på én forutsetning: at utvalget er trukket slik at det ikke systematisk
favoriserer noen.
Skillet som betyr noe, går ikke mellom store og små utvalg. Det går mellom
- sannsynlighetsutvalg, der hver enhet i populasjonen har en kjent og
positiv sannsynlighet for å bli trukket, og
- ikke-sannsynlighetsutvalg, der noen enheter aldri kan bli trukket, eller
der vi ikke vet med hvilken sannsynlighet de trekkes.
Bare den første typen lar oss regne ut hvor usikre vi er. Den andre kan gi
nyttig informasjon, men ikke et anslag med feilmargin.
Et enkelt tilfeldig utvalg (ETU) er et utvalg der alle grupper på
enheter har like stor sannsynlighet for å bli trukket. Det svarer til å trekke
navn fra en hatt etter at lappene er godt blandet.
Konsekvensen er at hver enkelt enhet trekkes med sannsynligheten
.
Slik gjør vi det i praksis:
1. Nummerer alle enhetene i utvalgsrammen fra til .
2. Trekk tilfeldige numre — uten tilbakelegging, altså uten gjentakelser.
3. Enhetene med disse numrene utgjør utvalget.
I regneark er den sikreste metoden å bruke SLUMP():
A1: elevnummer 1, 2, 3, …, 450
B1: =SLUMP()
Kopier SLUMP() nedover, sorter hele tabellen etter kolonne B, og ta de
øverste radene. Da slipper du å håndtere gjentakelser.
NB: =TILFELDIGMELLOM(1;450) gir ett tall om gangen, men samme tall kan
komme flere ganger. Bruker du den, må gjentakelser fjernes og nye trekkes —
ellers blir mindre enn du tror.
En skole med elever skal trekke til en undersøkelse.
a) Hvor stor er sannsynligheten for at en bestemt elev blir med?
b) Beskriv trekningen i et regneark.
c) Hvorfor kan vi ikke bare la lærerne velge elever de mener er
representative?
Svar a): Omtrent — og like stor for alle .
b) Steg 1. Legg elevnumrene til i kolonne A, rad til
.
Steg 2. Skriv =SLUMP() i celle og kopier ned til . Hver celle
får nå et tilfeldig desimaltall mellom og .
Steg 3. Marker og sorter stigende på kolonne B.
Steg 4. De øverste radene er utvalget.
En slik trekning ga elevnumrene
(Kjører du det samme hos deg, får du andre numre. SLUMP() regner dessuten om
hver gang arket endres, så kopier resultatet og lim det inn som verdier før du
går videre.)
Svar b): Nummer alle, gi hver et tilfeldig tall, sorter, og ta de
øverste.
c) Fordi «representativ etter skjønn» ikke er en kjent sannsynlighet.
Lærerne ville — helt uten å ville det — valgt elever de kjenner, elever som
pleier å svare, elever som er til stede den dagen. Utvalget ville sett rimelig
ut og likevel vært systematisk skjevt, og vi ville ikke hatt noen måte å regne
ut hvor skjevt.
Med tilfeldig trekning vet vi at anslaget i gjennomsnitt treffer riktig, og vi
kan regne ut hvor mye det typisk bommer.
Svar c): Fordi bare tilfeldig trekning gir kjente trekksannsynligheter — og
uten dem kan verken skjevheten unngås eller usikkerheten regnes ut.
En idrettsklubb har medlemmer og vil trekke til en undersøkelse.
Hvor stor er sannsynligheten for at et bestemt medlem blir trukket?
Beskriv hvordan trekningen kan gjøres i et regneark.
Klubben vurderer i stedet å spørre de første som møter på trening en tirsdag. Hva er problemet?
Klubben sier: «Men vi spør jo — like mange som i den tilfeldige trekningen.» Svar på innvendingen.
Nevn én situasjon der det likevel kan være riktig å spørre dem som møter på trening.
Startpunktet trekkes tilfeldig blant de første. Deretter tas
enhet nummer start, start , start , og så videre.
Metoden er enkel å gjennomføre i praksis — hver tiende kunde ut av butikken,
hver tjuende pakke på samlebåndet — og gir som regel like god presisjon som et
enkelt tilfeldig utvalg.
NB — periodisitetsfella. Er listen ordnet med en periode som passer med
, blir utvalget systematisk skjevt. Tar vi hver sjuende dag, treffer vi
samme ukedag hver gang. Er en klasseliste ordnet parvis med én jente og én gutt
om gangen, og er et partall, får vi bare det ene kjønnet.
Sjekk alltid hvordan listen er sortert før du bruker metoden.
Vi skal igjen trekke av elever, nå systematisk.
a) Finn trekkeintervallet .
b) Trekningen gir startpunkt . Hvilke elevnumre er med?
c) Elevlisten er sortert klassevis, og hver klasse har elever. Hva går
galt?
Svar a): Hver . elev.
b) Startpunktet trekkes blant tallene til . Her ble det , og vi
legger til om gangen:
Det siste nummeret er , som er innenfor . Vi har numre.
Svar b): Elev .
c) Her er , og hver klasse har nøyaktig elever. Da treffer vi
samme plass i hver klasse hver eneste gang — elev nummer på hver eneste
klasseliste.
Er listene alfabetiske, betyr det at vi alltid velger den sjuende eleven
alfabetisk. Er de sortert etter karakter, plukker vi samme karakternivå fra
alle klassene. Utvalget er ikke lenger tilfeldig med hensyn på det listen er
sortert etter.
Svar c): Perioden i listen () er lik , så utvalget treffer samme
posisjon i hver gruppe.
Slik løser vi det: Stokk om listen først, eller velg et som ikke passer
med perioden. Her kunne vi trukket elever med og rundet av
hver gang — eller enklere: sortert listen tilfeldig med SLUMP() før vi
begynte, og da er vi i praksis tilbake til et enkelt tilfeldig utvalg.
En kinokjede vil spørre av de som var på en forestilling.
Finn trekkeintervallet for et systematisk utvalg.
Startpunktet trekkes til . Skriv opp de seks første numrene og det siste.
Hvorfor må startpunktet trekkes tilfeldig?
Billettlisten er sortert etter setenummer, og hver rad i salen har seter. Hva blir galt?
Foreslå en løsning.
er ensartede innad og ulike seg imellom: trinn, bydeler, aldersgrupper,
bedriftsstørrelser.
Deretter trekkes et tilfeldig utvalg innenfor hvert stratum.
Ved proporsjonal allokering får hvert stratum like stor andel av utvalget
som det har av populasjonen:
der er antall enheter i stratum og er hvor mange vi trekker
derfra.
Hvorfor gjøre det? To grunner:
1. Sikkerhet. Utvalget får garantert riktig sammensetning. Et enkelt
tilfeldig utvalg kan ved uflaks få for få fra én gruppe.
2. Presisjon. Når gruppene er ensartede innad, blir anslaget mer presist
enn ved enkelt tilfeldig utvalg med samme .
NB: Trekker vi like mange fra hvert stratum uansett størrelse, får
enhetene i de små stratene høyere trekksannsynlighet enn de i de store. Det
kan være ønskelig — for eksempel når hver bydel skal ha egne tall — men da må
resultatene veies før de slås sammen til et tall for hele populasjonen.
En skole har elever på 8. trinn, på 9. trinn og på 10. trinn.
Det skal trekkes elever.
a) Hvor mange skal trekkes fra hvert trinn?
b) Hva blir trekksannsynligheten i hvert trinn?
c) Hva er galt med å ta fra hvert trinn?
Så regner vi ett trinn om gangen, med formelen tom og deretter med tall.
8. trinn:
9. trinn:
10. trinn:
Kontroll: . Det stemmer.
Svar a): fra 8. trinn, fra 9. trinn og fra 10. trinn.
(Avrundingen må sjekkes hver gang. Blir summen eller , justerer vi
det stratumet der avrundingen var nærmest en halv.)
b) Vi regner andelen som trekkes i hvert trinn:
Svar b): Omtrent i alle tre — praktisk talt lik
trekksannsynlighet, slik proporsjonal allokering skal gi. (De små forskjellene
kommer bare av avrundingen.)
c) Med fra hvert trinn blir andelene
En elev på 10. trinn har altså nesten høyere sjanse for å bli med enn
en på 8. trinn.
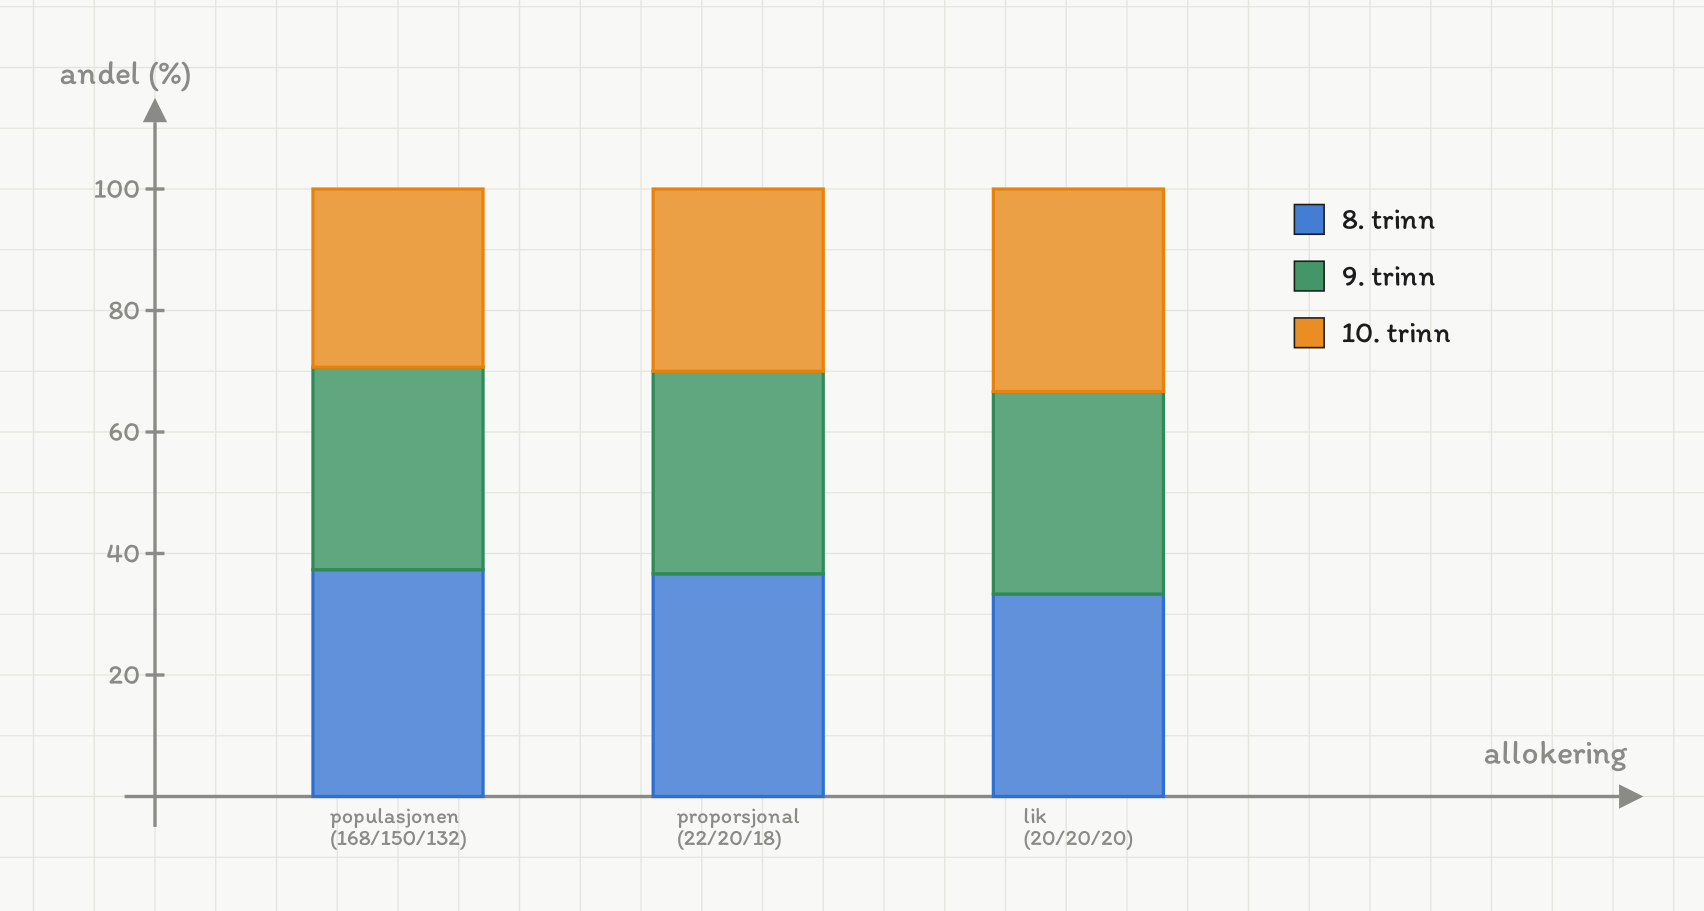
Proporsjonal allokering speiler populasjonen; lik allokering gjør det ikke. Trekksannsynligheten blir da ulik — 11,9 % på 8. trinn mot 15,2 % på 10. trinn — og utvalget må veies før det kan si noe om hele skolen.
Svar c): 10. trinn blir overrepresentert i utvalget. Skal tallene likevel
brukes samlet, må hvert trinn veies med sin riktige andel av populasjonen — og
gjør man ikke det, trekker 10. trinns svar for mye.
Andre muligheter: Lik allokering er riktig valg når hvert trinn skal ha
sitt eget resultat med omtrent lik presisjon. Da er poenget ikke ett
samlet tall, men tre sammenlignbare.
| Bydel | Sentrum | Nord | Vest | Øst |
|---|---|---|---|---|
| Innbyggere | 9400 | 6200 | 4900 | 3500 |
Det skal trekkes personer.
Finn totalt innbyggertall og andelen hver bydel utgjør.
Regn ut proporsjonal allokering for de fire bydelene.
Kontroller at summen blir .
Kommunen vurderer i stedet fra hver bydel. Hvilke bydeler blir over- og underrepresentert?
Når kan fra hver bydel likevel være det riktige valget?
Et klyngeutvalg deler populasjonen i klynger — skoleklasser,
bygårder, valgkretser — og trekker så hele klynger tilfeldig. Alle enhetene
i de trukne klyngene er med.
Forskjellen fra stratifisering er viktig:
| Strata | Klynger | |
|---|---|---|
| Hva gruppene skal være | ulike seg imellom, ensartede innad | hver klynge som et lite speil av hele populasjonen |
| Hva vi trekker | et utvalg fra hvert stratum | hele klynger, og bare noen av dem |
| Virkning på presisjonen | bedre enn ETU | dårligere enn ETU |
| Hvorfor brukes den | presisjon og sikkerhet | pris og praktisk gjennomførbarhet |
Klyngeutvalg er billig fordi vi bare må oppsøke noen få steder. Prisen er at
enheter i samme klynge ligner hverandre, og at enheter fra få klynger
derfor inneholder mindre informasjon enn enheter trukket fritt.
En skole har klasser med elever i hver.
a) Hvor mange elever får vi ved å trekke tre hele klasser?
b) Hvorfor er dette billigere enn å trekke elever tilfeldig?
c) En simulering med gjentakelser ga et standardavvik på
mellom anslagene ved enkelt tilfeldig utvalg, og ved klyngeutvalg.
Hva betyr det?
Svar a): elever — like mange som i et enkelt tilfeldig utvalg på .
b) Fordi vi bare må oppsøke tre steder i stedet for .
Ved et enkelt tilfeldig utvalg ville de elevene vært spredt på alle
klassene. Undersøkelsen måtte da avtales med lærere, gjennomføres i
timer, og elevene måtte hentes ut av undervisningen én og én.
Med klyngeutvalg tar vi tre klasser i tre skoletimer.
Svar b): Antall steder å oppsøke er det som koster, ikke antall
enheter.
c) Tallene sier hvor mye anslaget spriker fra gang til gang.
Ved enkelt tilfeldig utvalg spriker anslagene med ; ved klyngeutvalg
med — altså mer enn dobbelt så mye, med nøyaktig samme .
Forholdet mellom kvadratene er
Det betyr at klyngeutvalget på elever gir omtrent like mye informasjon som
et enkelt tilfeldig utvalg på
Svar c): Klyngeutvalget er mye mindre presist. De elevene teller i
praksis som rundt .
Her ser vi at «» ikke betyr det samme i to ulike design.
Klyngeutvalg må derfor være større enn et enkelt tilfeldig utvalg for å gi
samme presisjon — og valget står mellom pris og presisjon, ikke mellom rett og
galt.
Andre muligheter: I praksis brukes ofte en mellomting: trekk mange klynger,
men bare noen få enheter fra hver. Det gir mye av besparelsen og lite av
presisjonstapet.
Disse tre møter du hele tiden. Ingen av dem gir grunnlag for å oppgi en
feilmargin:
Bekvemmelighetsutvalg — de som var lettest å få tak i: folk i gågata en
tirsdag formiddag, klassen til den som lager undersøkelsen, kundene som stod i
kø. Skjevheten avhenger av hvem som tilfeldigvis er der, og den kan ikke
anslås.
Selvrekruttert utvalg — de som selv valgte å svare: en avstemning på en
nettside, en åpen høring, en QR-kode på kvitteringen. De som svarer, er de som
bryr seg mest, og de har som regel sterkere meninger enn resten. Dette er den
vanligste feilen i undersøkelser som deles i sosiale medier.
Kvoteutvalg — intervjueren skal ha et gitt antall i hver aldersgruppe, men
velger selv hvem. Sammensetningen blir riktig på de egenskapene man kvoterer
på, og kan være skjev på alt annet.
Et stort ikke-sannsynlighetsutvalg er ikke bedre enn et lite. Det er bare
sikrere på et svar som kan være feil.
på et spørsmål, på 8. trinn, på 9. trinn og på
10. trinn. Trinnene har henholdsvis , og elever.
Hva er den sanne andelen for hele skolen?
En elev spør bare sin egen klasse på 10. trinn. Hvilket anslag får hun?
Hvor stor blir den systematiske feilen?
Blir feilen mindre om hun spør alle på 10. trinn i stedet for sine klassekamerater?
Med proporsjonal stratifisering (, og elever) blir anslaget . Regn det ut og sammenlign.
elever, der klasse nummer har andelen
som svarer ja. Klassene er altså svært ulike.
Hva er den sanne andelen for hele skolen?
Trekk elever tilfeldig fra hele skolen, mange ganger. Hvor mye spriker anslagene?
Trekk i stedet tre hele klasser, mange ganger. Hvor mye spriker anslagene nå?
Regn ut forholdet mellom kvadratene av de to standardavvikene, og tolk tallet.
Hva ville skjedd med designeffekten hvis alle klassene hadde hatt omtrent samme andel?
elevene i din kommune bruker på skoleveien.
Avgrens populasjonen, og beskriv enheten og utvalgsrammen.
Velg utvalgsmetode og begrunn valget mot minst én annen metode.
Sett opp en proporsjonal allokering for et utvalg på , gitt elevtall du velger selv for fire skoler.
Hvilke enheter har sannsynlighet null for å bli med, og hva gjør det med konklusjonen?
Foreslå en billigere metode, og si hva den koster i presisjon.
Oppsummering
I dette kapittelet har du lært:
| Metode | Slik gjøres den | Styrke | Svakhet |
|---|---|---|---|
| Enkelt tilfeldig | Nummerer alle, trekk tilfeldig | Enkel å regne på | Kan være dyr å gjennomføre |
| Systematisk | Hver -te, , tilfeldig start | Lett i praksis | Periodisitet i lista |
| Stratifisert | Del i strata, trekk innenfor hvert | Riktig sammensetning, bedre presisjon | Krever kjennskap til strataene |
| Klynge | Trekk hele klynger | Billig | Lavere presisjon (designeffekt) |
| Bekvemmelighet | De som var lettest å få tak i | Rask | Ukjent skjevhet |
| Selvrekruttert | De som velger å svare | Billig | Ukjent skjevhet |
Husk
- Et sannsynlighetsutvalg krever at hver enhet har kjent og positiv
sannsynlighet for å bli trukket.
- Proporsjonal allokering: . Kontroller alltid at
avrundingen summerer til .
- Systematisk utvalg krever tilfeldig startpunkt — og at du vet hvordan lista er
sortert.
- Klyngeutvalg med enheter er mindre verdt enn et enkelt tilfeldig utvalg med
enheter.
- Et skjevt utvalg blir ikke riktig av å bli stort.
Dette kapitlet er skrevet av Anthropics toppmodeller (Claude Opus og Claude Fable) og er foreløpig ikke manuelt gjennomgått — kvalitetskontrollen gjøres av uavhengige KI-agenter, og innmeldte feil rettes fortløpende. Funnet en feil? Meld fra, så retter vi den. Les mer om hvordan innholdet lages.