
Hvorfor samvariasjon ikke er årsak: skjulte variabler, tilfeldigheter og omvendt årsak.
Den setningen som må sitte
Vi har nå to tall som beskriver en sammenheng: korrelasjonen og
stigningstallet . Begge sier noe om hvordan to variabler beveger seg
sammen. Ingen av dem sier ett ord om hvorfor.
Det finnes alltid flere forklaringer på en korrelasjon enn den ene du kom på
først. Dette kapittelet handler om å finne dem — før noen andre gjør det.
Måler vi en korrelasjon mellom og , finnes det minst fire mulige
forklaringer, og de er like gyldige helt til vi har grunn til å velge:
1. påvirker . Den forklaringen folk flest hopper til.
2. påvirker . Årsaken går motsatt vei av det vi antok.
3. En tredje variabel påvirker begge. kalles en bakenforliggende
eller skjult variabel. Da samvarierer og uten at noen av dem
virker på den andre.
4. Tilfeldighet eller utvalgsskjevhet. Korrelasjonen er ikke reell, eller
den gjelder bare i det utvalget vi tilfeldigvis har sett på.
I praksis er 3 og 4 minst like vanlige som 1. Den vanligste skjulte variabelen
av alle er størrelse: store kommuner har flere av alt, store skoler har
flere av alt, og folkerike land har flere av alt.
Skal du slutte om årsak, må du kunne begrunne hvorfor 2, 3 og 4 er
utelukket. Det er en høy terskel, og den er der med god grunn.
Tolv kommuner har rapportert antall bibliotekbesøk og antall legebesøk i løpet
av et år. Tallene er i tusen.
| Bibliotekbesøk | 10,1 | 13,3 | 27,0 | 28,7 | 42,8 | 44,8 | 77,0 | 85,1 | 98,8 | 167,6 | 189,4 | 271,3 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Legebesøk | 4,6 | 8,2 | 12,0 | 21,0 | 28,8 | 31,5 | 49,3 | 57,4 | 72,8 | 92,3 | 112,8 | 199,0 |
Korrelasjonen mellom de to er .
a) En kommentator skriver: «Lesing gjør folk syke.» Hvorfor holder ikke det?
b) Hvilken opplysning mangler, og hvordan finner vi ut om den forklarer alt?
c) Hva blir konklusjonen?
svært ulike: den minste har innbyggere, den største .
Store kommuner har flere av alt — flere bibliotekbesøk, flere legebesøk,
flere parkeringsplasser og flere fotballkamper. At to slike tall følger
hverandre, er en opplysning om kommunestørrelse, ikke om lesing eller helse.
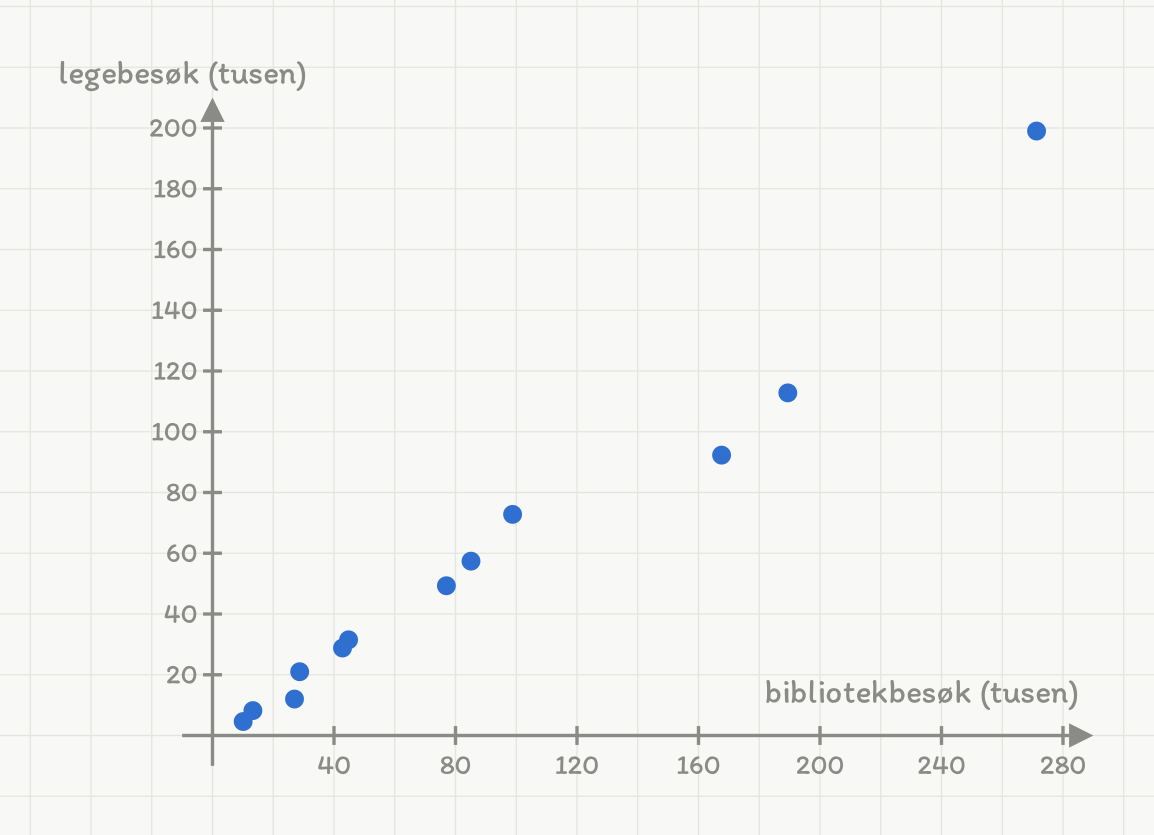
Tolv kommuner. Punktene stiger tydelig () — men hele mønsteret kommer av at kommunene er ulikt store. Regnet per innbygger blir .
Svar a): Forklaringen bygger på antall, ikke på andel. Folketallet er en
skjult variabel som påvirker begge tallene.
b) Vi mangler folketallet. Med det kan vi gjøre begge tallene om til
besøk per innbygger — altså fjerne størrelsen fra regnestykket.
| Folketall (tusen) | 2,1 | 3,4 | 5,2 | 7,0 | 9,3 | 12,1 | 15,4 | 19,8 | 26,0 | 34,2 | 45,1 | 60,3 |
|---|
For den minste kommunen blir bibliotekbesøkene per innbygger
og legebesøkene
Vi gjør det samme for alle tolv. Da får vi to nye rekker, og regner
korrelasjonen mellom dem:
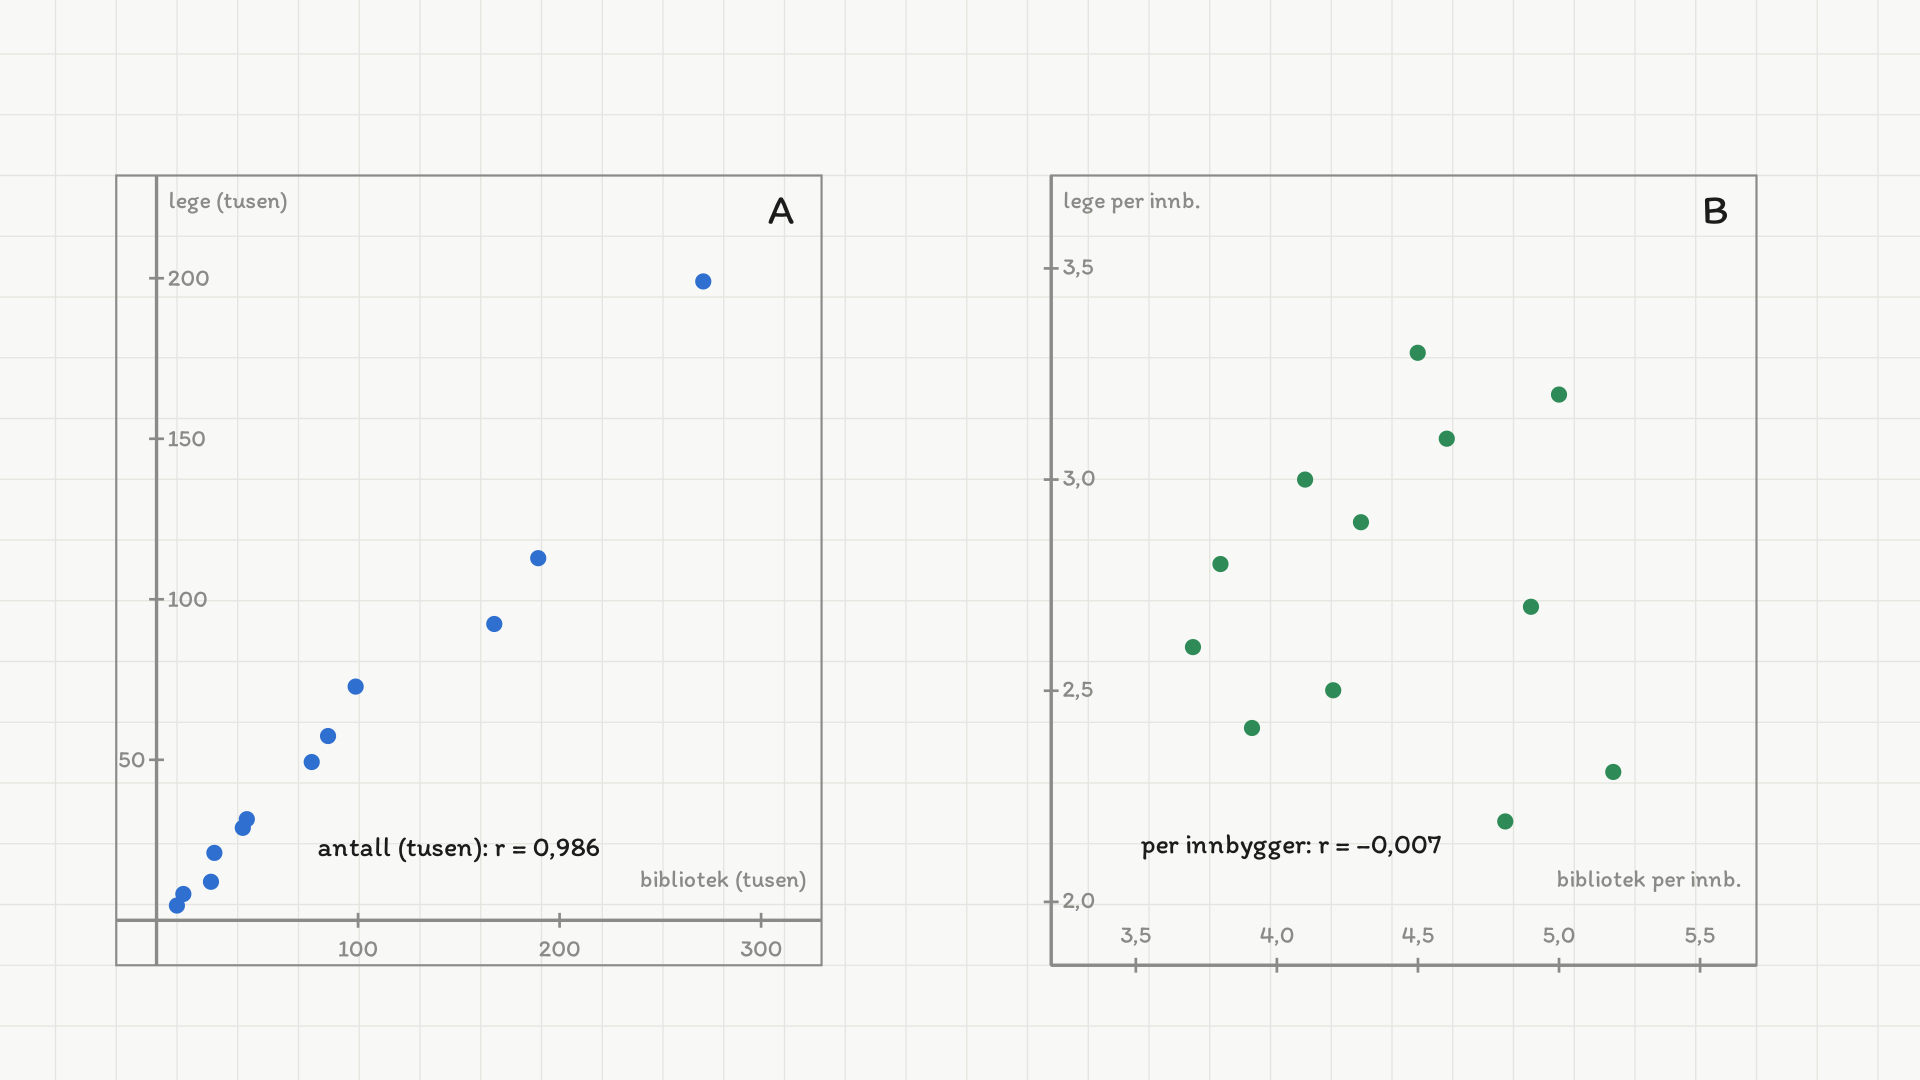
Samme tolv kommuner, to regnemåter. Når folketallet deles bort, forsvinner sammenhengen helt: r går fra 0,986 til omtrent null. Det som fulgte hverandre, var kommunestørrelsen.
Svar b): Vi trenger folketallet. Regnet per innbygger forsvinner
sammenhengen fullstendig.
c) Korrelasjonen på var ekte nok som tall, men den beskrev bare
at kommuner er ulikt store. Når størrelsen er tatt bort, er det ingenting
igjen: en kommune der folk går mye på biblioteket, går verken mer eller mindre
til legen enn andre.
Svar c): Sammenhengen skyldes den skjulte variabelen folketall. Det finnes
ingen sammenheng mellom lesing og legebesøk i dette materialet.
Slik leser du kritisk: Møter du en korrelasjon mellom to antall, spør
alltid først om enhetene er like store. Er de ikke det, skal tallene gjøres om
til andeler eller rater — per innbygger, per elev, per kjørte kilometer. Dette
er samme regel som i kapittel 1.6, nå brukt på to variabler samtidig.
Ti skoler har oppgitt antall elever og antall elever med vedtak om
spesialundervisning.
| Antall elever | 95 | 130 | 180 | 240 | 310 | 420 | 550 | 680 | 820 | 1000 |
|---|---|---|---|---|---|---|---|---|---|---|
| Med spesialundervisning | 8 | 11 | 15 | 20 | 27 | 35 | 45 | 58 | 68 | 84 |
Finn korrelasjonen mellom de to antallene.
En avis skriver: «Store skoler har et spesialundervisningsproblem.» Hva er galt med slutningen?
Regn ut andelen i prosent for hver skole.
Finn korrelasjonen mellom antall elever og andelen.
Skriv en overskrift som er dekkende.
Når årsaken går motsatt vei
Den andre forklaringen er lettest å overse, fordi den ofte høres absurd ut
først — helt til man ser hvordan tallene ble til.
Spør derfor alltid: hva skjedde først? En årsak må komme før sin virkning.
Er de to variablene målt samtidig, er rekkefølgen ofte umulig å avgjøre ut fra
tallene alene, og da må vi tenke på hvordan situasjonen faktisk oppstår.
Ved åtte branner ble det registrert hvor mange brannfolk som var på stedet, og
hvor store materielle skader brannen gjorde.
| Brannfolk | 4 | 6 | 8 | 10 | 12 | 16 | 20 | 26 |
|---|---|---|---|---|---|---|---|---|
| Skade (mill. kr) | 0,3 | 0,7 | 1,1 | 1,8 | 2,6 | 4,2 | 6,0 | 9,5 |
Korrelasjonen er .
a) En leser konkluderer: «Brannvesenet gjør skaden verre — send færre folk.»
Hva er galt?
b) Hvordan burde spørsmålet «virker brannvesenet?» undersøkes?
Først brenner det. Brannen er stor eller liten. Deretter avgjør
brannvesenet hvor mange enheter de sender — og de sender flere til store
branner.
Årsaksretningen går altså motsatt vei av det leseren tror: det er brannens
størrelse som bestemmer antall brannfolk, ikke antall brannfolk som bestemmer
skaden. Å sende færre ville ikke gitt mindre skade; det ville gitt mer.
Svar a): Leseren har snudd årsaksretningen. Brannstørrelsen kommer først og
påvirker begge de målte tallene.
b) Spørsmålet «virker brannvesenet?» kan ikke besvares ved å sammenligne
branner der det ble sendt ulikt antall folk, for de brannene var ulike fra
starten. Vi måtte sammenlignet like branner som fikk ulik innsats — for
eksempel branner av samme type der utrykningstiden tilfeldigvis var ulik på
grunn av avstand.
Et bedre mål er skade per brann i kommuner med og uten egen brannstasjon, eller
skadeutviklingen før og etter at responstiden ble kortet ned.
Svar b): Ved å sammenligne branner som var like i utgangspunktet, ikke
branner som fikk ulik innsats fordi de var ulike.
NB: Den samme fella finnes overalt der en innsats settes inn fordi
problemet er stort: flere politifolk der kriminaliteten er høy, mer
leksehjelp til elever som sliter, flere sykepleiere på de sykeste pasientene.
I alle disse tilfellene vil en enkel korrelasjon peke gal vei.
For hver påstand: avgjør hvilken av de fire forklaringene som er mest
sannsynlig, og begrunn.
«Barn som har mange bøker hjemme, får bedre karakterer. Kjøp bøker, så går karakterene opp.»
«Pasienter som ligger på intensivavdelingen, har høyere dødelighet enn de på vanlig sengepost. Intensivavdelingen er farlig.»
«Kommuner med mange eldre bruker mer penger på helse per innbygger.»
«Land der folk spiser mye sjokolade, har flere nobelprisvinnere.»
«Elever som spiser frokost, gjør det bedre på prøver.»
Tilfeldige og trend-drevne korrelasjoner
Den fjerde forklaringen er den vanskeligste å ta på alvor, fordi den ikke
peker på noe som helst: sammenhengen er ikke der.
To ting gjør at slike korrelasjoner dukker opp hele tiden:
1. Alt som vokser, korrelerer med alt annet som vokser. To tidsserier som
begge stiger jevnt år for år, får høy uansett hva de måler. Den felles
forklaringen er tiden, og den forklarer ingenting.
2. Leter man lenge nok, finner man alltid noe. Sammenligner man tusen
variabler to og to, blir det nesten en halv million par. Noen av dem vil ha høy
korrelasjon ved ren tilfeldighet. Hvis funnet ble til ved å lete, og ikke ved å
teste en hypotese man hadde på forhånd, er det svakt.
Motgiften mot den første er å se på endringene i stedet for nivåene. Mot
den andre finnes bare én: si på forhånd hva du leter etter, og test funnet på
nye data.
Tabellen viser antall solgte elsykler (tusen) og antall nye podkastepisoder
(tusen) i Norge i elleve år.
| År | 2015 | 2016 | 2017 | 2018 | 2019 | 2020 | 2021 | 2022 | 2023 | 2024 | 2025 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Elsykler | 12 | 19 | 28 | 41 | 55 | 78 | 96 | 112 | 128 | 141 | 155 |
| Podkastepisoder | 8 | 18 | 26 | 38 | 60 | 66 | 75 | 95 | 120 | 133 | 157 |
a) Finn korrelasjonen mellom de to.
b) Hvorfor er tallet nesten uten verdi?
c) Hvordan kan vi undersøke om det finnes en sammenheng ut over trenden?
Svar a): En tilsynelatende svært sterk positiv sammenheng.
b) Vi regner korrelasjonen mellom året og hver av de to seriene:
Begge vokser altså nesten perfekt med tiden. Da må de også korrelere med
hverandre — det følger av at begge følger den samme stigende linja, ikke av at
den ene har noe med den andre å gjøre.
Svar b): Fordi korrelasjonen bare gjenspeiler at begge tallene har steget
gjennom perioden. Det samme ville skjedd med et hvilket som helst annet tall
som har vokst siden 2015.
c) Vi fjerner trenden ved å se på årlige endringer i stedet for nivåer:
Elsykler: , så , og videre
.
Podkast: , så .
Korrelasjonen mellom de ti endringsparene er
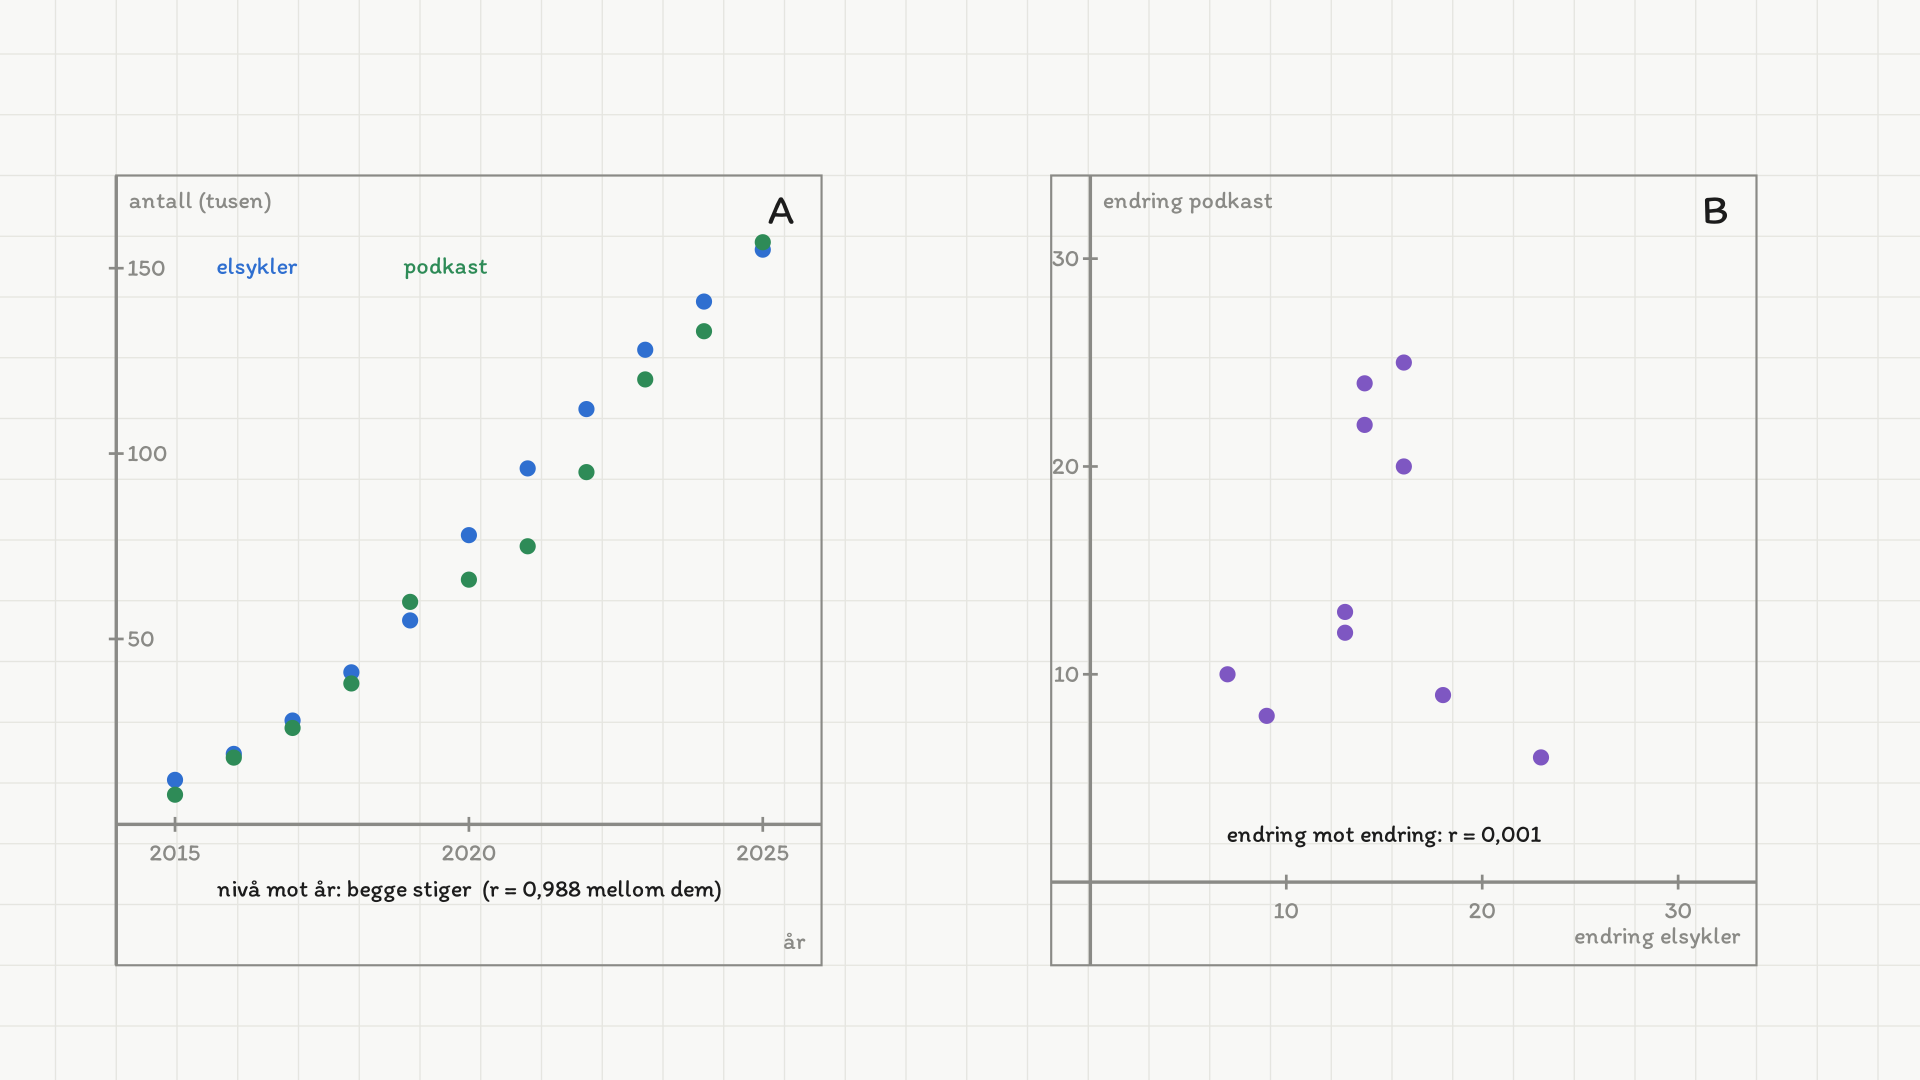
To kurver som begge peker oppover, gir nesten alltid høy korrelasjon. Ser vi i stedet på endringene fra år til år, forsvinner sammenhengen helt — det var trenden, ikke noen sammenheng, som ga tallet 0,988.
Svar c): Ved å korrelere endringene i stedet for nivåene. Da er
praktisk talt null — det finnes ingen sammenheng ut over at begge har vokst.
Andre muligheter: Man kan også dele begge seriene på et mål for hvor stor
«markedet» er blitt — for eksempel folketallet eller antall husholdninger — og
se om noe blir igjen.
En korrelasjon kan ikke bare svekkes eller forsterkes av en skjult variabel —
den kan skifte fortegn.
Deles et materiale i grupper, kan sammenhengen være negativ i hver eneste
gruppe og likevel bli positiv når alt slås sammen. Fenomenet heter Simpsons
paradoks, og det er regnet gjennom med tall i kapittel 4.6, der vi
arbeider med krysstabeller.
Lærdommen er den samme her: før du tolker en korrelasjon, spør om materialet
består av grupper som burde vært sett på hver for seg.
Tolv voksne er spurt hvor mange kopper kaffe de drikker daglig, og hvilepulsen
er målt. De seks første er under år, de seks siste over år.
| Under 30 år — kaffekopper | 0 | 1 | 1 | 2 | 2 | 3 |
|---|---|---|---|---|---|---|
| Hvilepuls | 67 | 65 | 68 | 66 | 69 | 66 |
| Over 60 år — kaffekopper | 3 | 4 | 4 | 5 | 5 | 6 |
| Hvilepuls | 75 | 73 | 76 | 74 | 77 | 74 |
Finn korrelasjonen for alle tolv samlet.
Finn korrelasjonen i hver aldersgruppe for seg.
Forklar hvordan de to svarene kan stemme samtidig.
Hva kalles det å regne korrelasjonen i hver gruppe for seg?
Hvilken konklusjon er dekkende?
Hva skal til for å si «årsak»?
Den eneste framgangsmåten som virkelig skiller årsak fra samvariasjon, er det
randomiserte forsøket:
1. Vi trekker et utvalg.
2. Vi deler det i to grupper tilfeldig — ikke etter hva deltakerne vil,
ikke etter hvem som trenger det mest.
3. Den ene gruppen får tiltaket, den andre (kontrollgruppen) får det ikke.
4. Vi måler utfallet i begge gruppene.
Poenget med den tilfeldige fordelingen er at gruppene da blir like i alt
annet, også i ting vi ikke har tenkt på å måle. Blir utfallet likevel
forskjellig, er tiltaket den eneste kandidaten som står igjen.
Slike forsøk er ikke alltid mulige. Vi kan ikke tilfeldig bestemme hvem som
skal røyke, flytte eller miste jobben. Da må vi bygge saken av flere svakere
holdepunkter:
| Holdepunkt | Spørsmålet det svarer på |
|---|---|
| Tidsrekkefølge | Kom årsaken før virkningen? |
| Styrke | Er sammenhengen sterk, eller så vidt målbar? |
| Konsistens | Finner andre det samme i andre utvalg, andre land, andre år? |
| Dose–respons | Gir mer av mer av ? |
| Mekanisme | Finnes det en forklaring på hvordan kan virke på ? |
| Kontroll | Står sammenhengen når kjente tredjevariabler er kontrollert for? |
Ingen av linjene alene er nok. Til sammen kan de bli sterke — det var slik
sammenhengen mellom røyking og lungekreft ble slått fast, uten at noen noen
gang delte folk tilfeldig i røykere og ikke-røykere.
En kommune vil vite om gratis skolefrokost gir bedre resultater på nasjonale
prøver. De har tall som viser at elever som spiser frokost, skårer poeng
høyere enn de som ikke gjør det.
a) Hvorfor holder ikke dette som bevis?
b) Sett opp et forsøk som kunne gitt svar.
c) Hvilke forbehold ville du tatt selv med et godt forsøk?
derfor trolig på mye annet: søvnrutiner, hvor tidlig de står opp, hvor mye ro
det er hjemme om morgenen, om de rekker skolebussen.
Alt dette kan påvirke prøveresultatet direkte. Forskjellen på poeng kan
skyldes frokosten, eller alle de andre tingene, eller begge deler — tallene
skiller ikke.
Svar a): Fordi gruppene ikke er sammenlignbare. Dette er forklaring 3, en
bakenforliggende variabel, og den er svært sannsynlig her.
b) Et randomisert forsøk:
Steg 1. Velg for eksempel skoler som ligner hverandre i størrelse og
elevgrunnlag.
Steg 2. Trekk tilfeldig ti av dem som skal tilby gratis frokost, og la
de ti andre være kontrollgruppe. Trekkingen er hele poenget: den gjør at de to
gruppene blir like i alt annet, også i det vi ikke har målt.
Steg 3. La ordningen løpe et helt skoleår.
Steg 4. Sammenlign gjennomsnittsresultatet i de to gruppene.
Svar b): Tjue like skoler, tilfeldig delt i to, ett år med tilbud på den
ene halvparten, og sammenligning til slutt.
c) Selv da gjenstår spørsmål:
- Hvem spiste faktisk frokosten? Et tilbud er ikke det samme som at alle
benytter seg av det. Vi måler virkningen av å tilby frokost, ikke av å
spise den.
- Hva ellers ble annerledes? Skoler som får en ny ordning, får også
oppmerksomhet, og lærerne vet hvilken gruppe de er i.
- Gjelder funnet andre steder? Tjue skoler i én kommune er ikke hele landet.
- Hvor stor er forskjellen? En forskjell kan være reell og likevel for
liten til å være verdt kostnaden.
Svar c): At vi måler tilbudet og ikke inntaket, at annet enn frokosten kan
ha endret seg, at resultatet gjelder disse skolene, og at størrelsen på
effekten må vurderes ved siden av om den finnes.
bestemt sykdom er per i året blant dem som ikke er utsatt for et
stoff, og per blant dem som er det.
Hvor mange prosent høyere er risikoen i den utsatte gruppen?
Hvor mye høyere er risikoen målt i tilfeller per ?
En overskrift lyder: «Stoffet øker risikoen med prosent.» Er den riktig? Er den dekkende?
Hvor mange må utsettes for stoffet i ett år før det i gjennomsnitt blir ett ekstra tilfelle?
Undersøkelsen er en spørreundersøkelse der deltakerne selv husket om de hadde vært utsatt. Hvilken svakhet gir det?
syklister og antall sykkelulykker i løpet av et år.
| Syklister | 610 | 880 | 1150 | 1520 | 2050 | 2600 | 3450 | 4150 | 5600 | 7400 |
|---|---|---|---|---|---|---|---|---|---|---|
| Sykkelulykker | 10 | 14 | 19 | 24 | 34 | 41 | 57 | 67 | 92 | 117 |
Finn korrelasjonen mellom antall syklister og antall ulykker.
En politiker sier: «Jo flere som sykler, desto farligere blir det. Vi bør ikke oppfordre til mer sykling.» Vurder slutningen.
Lag en kolonne med ulykker per syklister, og finn korrelasjonen mellom antall syklister og denne raten.
Hva er konklusjonen nå?
Hvilke opplysninger måtte vi hatt for å si noe om årsak?
noe forårsaker noe annet. Bruk kapittelet på den.
Skriv opp påstanden så presist du kan: hva er , hva er , og hvilken retning påstås årsaken å gå?
Gå gjennom alle fire forklaringene fra dette kapittelet, og skriv én setning om hver.
Er tallene antall eller andeler? Er enhetene like store?
Hvilket forsøk måtte vært gjort for å avgjøre spørsmålet, og er det mulig eller forsvarlig å gjennomføre?
Skriv om saken slik at den er dekkende, uten å påstå mer enn tallene bærer.
Oppsummering
I dette kapittelet har du lært:
| Forklaring | Kjennetegn | Motgift |
|---|---|---|
| påvirker | Det vi håper på | Krever at de tre andre er utelukket |
| påvirker | Innsats settes inn der problemet er | Spør hva som skjedde først |
| Skjult variabel | Enhetene er ulikt store, eller består av grupper | Regn om til andeler, kontroller for |
| Tilfeldighet | Begge serier vokser, eller funnet kom av å lete | Se på endringer, test på nye data |
Husk
- Korrelasjon er ikke årsak — heller ikke når .
- Den vanligste skjulte variabelen er størrelse. Antall må gjøres om til
andel eller rate.
- Alt som vokser over tid, korrelerer med alt annet som vokser over tid.
- Sammenslåing av grupper kan snu fortegnet (Simpsons paradoks, kapittel 4.6).
- Det randomiserte forsøket er den eneste framgangsmåten som virkelig skiller —
og den tilfeldige fordelingen er hele poenget med det.
- Uten et slikt forsøk bygges en årsaksslutning av tidsrekkefølge, styrke,
konsistens, dose–respons, mekanisme og kontroll — til sammen, aldri av ett av
dem alene.
Dette kapitlet er skrevet av Anthropics toppmodeller (Claude Opus og Claude Fable) og er foreløpig ikke manuelt gjennomgått — kvalitetskontrollen gjøres av uavhengige KI-agenter, og innmeldte feil rettes fortløpende. Funnet en feil? Meld fra, så retter vi den. Les mer om hvordan innholdet lages.