
Variasjonsbredde, kvartiler og kvartilbredde, varians og standardavvik regnet for hånd og med regneark.
Gjennomsnittet er ikke nok
To fotballag har spilt åtte kamper hver. Antall mål per kamp var
| Gjennomsnitt | |||||||||
|---|---|---|---|---|---|---|---|---|---|
| Lag A | 2 | 3 | 2 | 3 | 2 | 3 | 2 | 3 | 2,5 |
| Lag B | 0 | 6 | 1 | 5 | 0 | 6 | 1 | 1 | 2,5 |
Begge lagene har nøyaktig samme gjennomsnitt, mål per kamp. Likevel er
lagene helt forskjellige: lag A scorer to eller tre mål hver eneste kamp, mens
lag B enten scorer nesten ingenting eller renner over.
Forskjellen er spredningen — hvor mye observasjonene varierer rundt midten.
Et sentralmål alene er derfor aldri nok. Vi trenger alltid et spredningsmål
ved siden av.
I dette kapittelet møter du fire spredningsmål: variasjonsbredde, kvartilbredde,
varians og standardavvik.
observasjonen:
Den er enkel å regne ut og lett å forstå, men den bruker bare to av
observasjonene — de to ytterste. Derfor er den svært følsom for uteliggere.
Finn variasjonsbredden for lag A og lag B i tabellen over, og forklar hva
tallene forteller.
Lag B: Sortert: .
Svar: Lag A har variasjonsbredde mål, lag B har mål.
Her ser vi at de to lagene, som hadde identisk gjennomsnitt, skiller seg
kraftig når vi ser på spredningen. Lag B er seks ganger så «uforutsigbart» målt
på denne måten.
NB: Variasjonsbredden bryr seg ikke om hva som skjer mellom ytterpunktene.
Bytter vi ut lag B sine åtte kamper med , er
variasjonsbredden fortsatt — selv om laget nå er langt jevnere. Det er
grunnen til at vi trenger spredningsmål som bruker alle observasjonene.
Middagstemperaturen ble målt sju dager på rad i to byer (i C):
| By A | 3 | 5 | 4 | 6 | 5 | 4 | 8 |
| By B | 12 | 1 | 9 | 10 | 9 |
Finn gjennomsnittstemperaturen i hver by.
Finn variasjonsbredden i hver by.
Hvilken by vil du si har det mest stabile været? Begrunn med tallene.
Hvorfor holder det ikke å oppgi gjennomsnittstemperaturen alene i en værmelding?
(kvart = fjerdedel):
- Nedre kvartil : av observasjonene er mindre enn eller lik .
- Medianen : ligger under.
- Øvre kvartil : ligger under.
Slik finner vi dem for hånd:
1. Sorter materialet, og finn medianen .
2. er medianen i den nedre halvdelen av materialet.
3. er medianen i den øvre halvdelen.
Er antallet observasjoner et oddetall, holder vi medianen selv utenfor begge
halvdelene.
Kvartilbredden er
Den forteller hvor bredt de midterste av observasjonene ligger — og
siden den hopper over de ytterste fjerdedelene, er den robust mot uteliggere.
Finn medianen, kvartilene, kvartilbredden og variasjonsbredden.
Steg 2 — medianen. Her er , et oddetall, så medianen ligger på plass
Verdien på sjette plass er minutter.
Steg 3 — nedre kvartil. Den nedre halvdelen er de fem verdiene foran
medianen (medianen selv holdes utenfor):
Steg 4 — øvre kvartil. Den øvre halvdelen er de fem verdiene etter medianen:
Steg 5 — bredder.
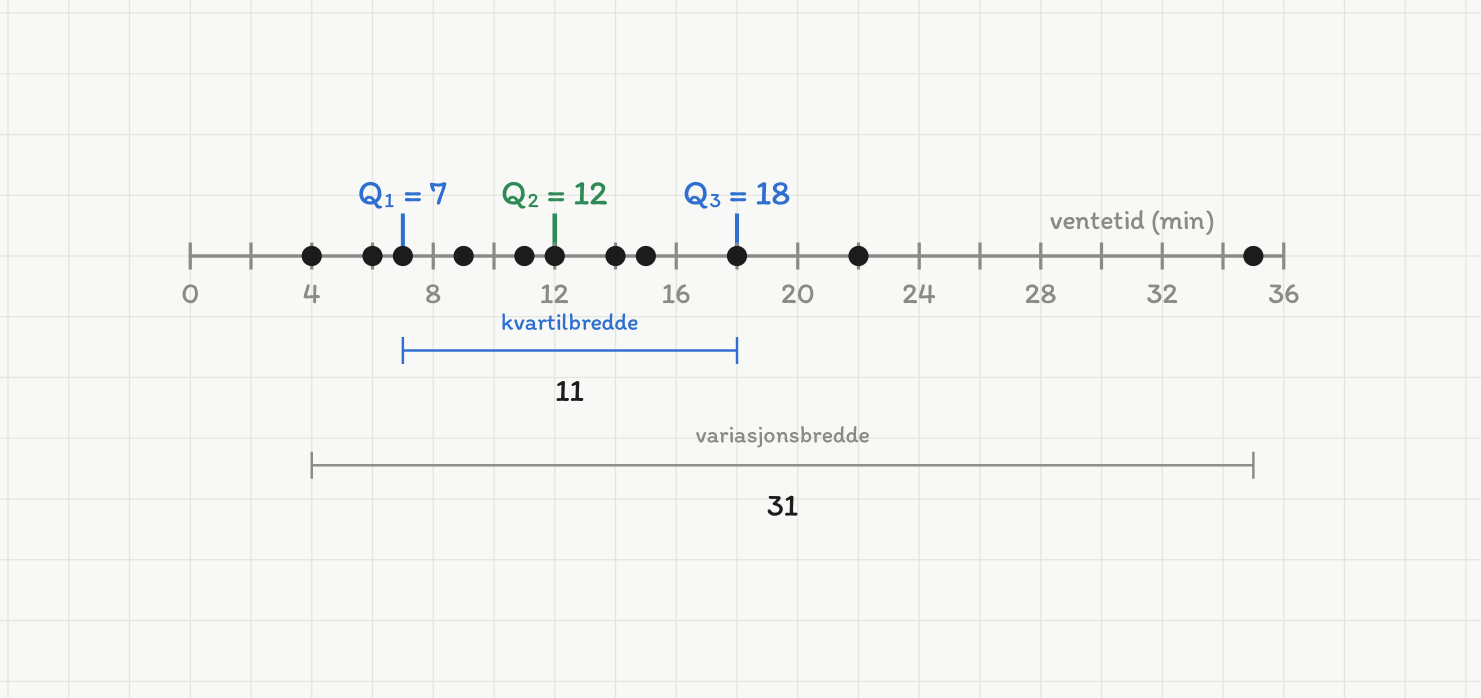
Kvartilene deler materialet i fire. Den ene lange ventetiden på 35 minutter blåser opp variasjonsbredden til 31 minutter, mens kvartilbredden på 11 minutter knapt merker den.
Svar: , , minutter. Kvartilbredden er
minutter og variasjonsbredden minutter.
Tolkning: Halvparten av pasientene ventet mellom og minutter. Den
store variasjonsbredden skyldes i hovedsak den ene som ventet minutter —
kvartilbredden merker knapt den observasjonen.
Det finnes flere måter å plassere kvartilene på når ikke er delelig med
fire. Metoden over er den vi bruker for hånd. Regneark (KVARTIL) og GeoGebra
bruker en metode som regner seg fram til en verdi mellom to observasjoner, og
kan derfor gi et litt annet tall: for ventetidene over gir regnearket
og , mens vi for hånd fikk og .
Ingen av delene er feil — det er to ulike definisjoner. Du må bare si hvilken
du har brukt, og bruke den samme hele veien når du sammenligner
datamaterialer.
Gjør den samme oppgaven som i eksempel 2. Bruk metoden for hånd.
Sorter materialet og finn medianen.
Finn .
Finn .
Finn kvartilbredden og variasjonsbredden.
Forklar hvorfor de to breddene er så ulike her.
Varians og standardavvik
Variasjonsbredden bruker to observasjoner, kvartilbredden bruker to kvartiler.
Nå vil vi ha et spredningsmål som bruker alle observasjonene.
Tanken er enkel: mål hvor langt hver observasjon ligger fra gjennomsnittet, og
finn den typiske avstanden. Avstanden fra gjennomsnittet kaller vi avviket:
Men her møter vi et problem. Legger vi sammen avvikene, blir summen alltid —
de negative avvikene spiser opp de positive. (Det er faktisk en av definisjonene
på gjennomsnittet: det er punktet der avvikene veier hverandre opp.)
Løsningen er å kvadrere avvikene før vi summerer. Da blir alle ledd positive,
og store avvik teller ekstra mye. Til slutt tar vi kvadratroten, slik at svaret
får samme enhet som observasjonene igjen.
er kvadratroten av variansen.
Når tallene er hele materialet vi vil beskrive (en populasjon), deler vi på
, og bruker den greske bokstaven (sigma):
Når tallene er et utvalg som skal si noe om en større populasjon, deler vi på
, og skriver :
kalles utvalgsstandardavviket. Det er alltid litt større enn for
de samme tallene. Grunnen er at et utvalg nesten alltid varierer litt mindre enn
populasjonen det er trukket fra, og divisjonen med retter opp den
skjevheten.
Spør hva tallene dine er:
- «Dette er alle jeg vil si noe om» — de elevene i klassen, alle
timene i døgnet: bruk (del på ).
- «Dette er et utvalg, og jeg vil si noe om alle» — av elever,
av landets husstander: bruk (del på ).
Oppgaveteksten sier som regel hvilken situasjon du er i. Er den uklar, skriver
du hvilken du har valgt og hvorfor. Er stor, betyr valget lite: for
skiller og seg med en halv prosent.
a) Finn standardavviket når vi ser på disse fem som hele materialet.
b) Finn utvalgsstandardavviket når de fem er et utvalg fra hele partiet.
så det må vi ha først:
Vi deler på fordi det er fileter.
Steg 2 — avvikstabellen. Vi setter opp én rad per observasjon, og fyller
kolonne for kolonne:
| 48 | ||
| 52 | ||
| 50 | ||
| 46 | ||
| 54 | ||
| Sum | 0 | 40 |
(Kontroll som har et poeng: summen i midtkolonnen skal alltid bli . Blir den
ikke det, har vi regnet feil gjennomsnitt eller feil avvik — og da er det ingen
vits i å gå videre.)
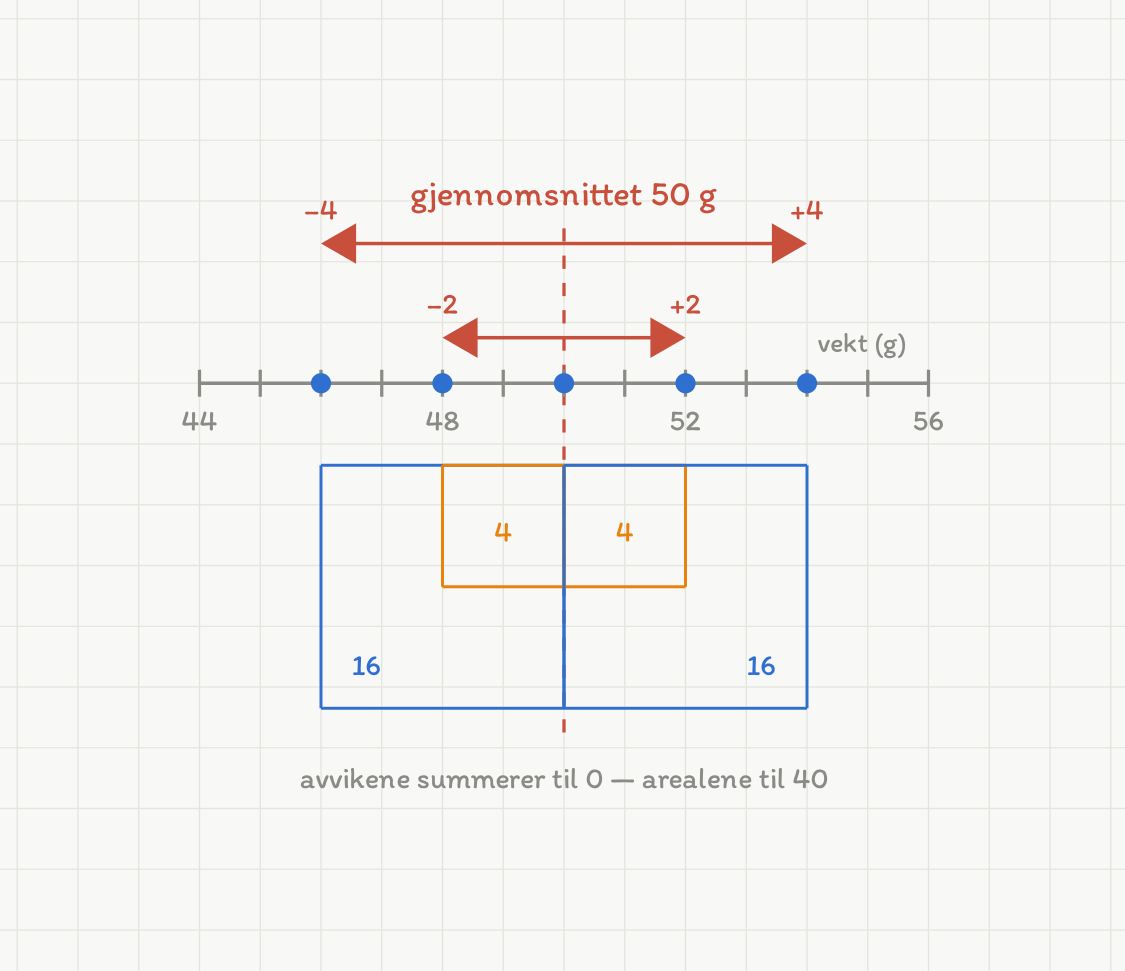
Avviket er avstanden fra gjennomsnittet, og kvadratet har avviket som sidekant. Avvikene selv summerer til null — arealene gjør det ikke, og det er derfor vi kvadrerer før vi summerer.
Steg 3 a) — standardavviket . Formelen først, tom:
og så med tall:
Svar a): gram.
Steg 3 b) — utvalgsstandardavviket . Samme sum over brøkstreken, men vi
deler på :
Svar b): gram.
Her ser vi at , slik det alltid er: vi deler den samme summen på
et mindre tall. Forskjellen er stor her fordi bare er .
Alle kalkulatorer med statistikkmeny og alle regneark har egne funksjoner for
standardavvik — og de har to av dem, én for hver formel:
| Regneark | GeoGebra | |
|---|---|---|
| (del på ) | =STDAV.P(område) | sd(liste) |
| (del på ) | =STDAV.S(område) | stdevsample(liste) |
Bokstaven P står for populasjon og S for stikkprøve (utvalg). Velger du feil
funksjon, får du et tall som ser riktig ut, men som svarer på et annet spørsmål.
Skriv likevel opp formelen og avvikstabellen når oppgaven ber om utregning —
verktøyet gir svaret, føringen viser at du vet hva svaret betyr.
Gjør den samme utregningen som i eksempel 3. Sett opp avvikstabellen.
Finn gjennomsnittet.
Sett opp avvikstabellen og finn summen av de kvadrerte avvikene.
Finn når de seks er hele materialet. Rund av til to desimaler.
Finn når de seks er et utvalg fra hele skolen. Rund av til to desimaler.
Hvorfor skal summen i midtkolonnen bli null?
To butikker i samme kjede talte antall kunder hver dag i én uke:
| man | tir | ons | tor | fre | lør | søn | |
|---|---|---|---|---|---|---|---|
| Butikk A | 102 | 98 | 105 | 101 | 99 | 103 | 100 |
| Butikk B | 70 | 135 | 88 | 150 | 62 | 120 | 83 |
Begge butikkene hadde kunder i løpet av uka.
a) Finn gjennomsnitt og standardavvik for hver butikk.
b) Hvilke konsekvenser har forskjellen for hvordan butikkene bør bemannes?
sju dager:
Standardavvikene regner vi med STDAV.P i regneark (vi ser på uka som hele
materialet vi vil beskrive):
Svar a): Begge butikkene har kunder per dag i gjennomsnitt.
Standardavviket er kunder i butikk A og kunder i
butikk B.
b) Vi forklarer konklusjonen med tallene:
I butikk A ligger alle dagene innenfor – kunder — et spenn på bare
kunder. To standardavvik er , så alle sju dagene ligger
innenfor to standardavvik fra gjennomsnittet (, altså fra
til ). Bemanningen kan være den samme hver dag.
I butikk B svinger dagene fra til kunder. Standardavviket på
er nesten en tredjedel av gjennomsnittet. Setter butikk B opp samme bemanning
hver dag, står de med for mange ansatte på mandag og fredag og for få på tirsdag
og torsdag.
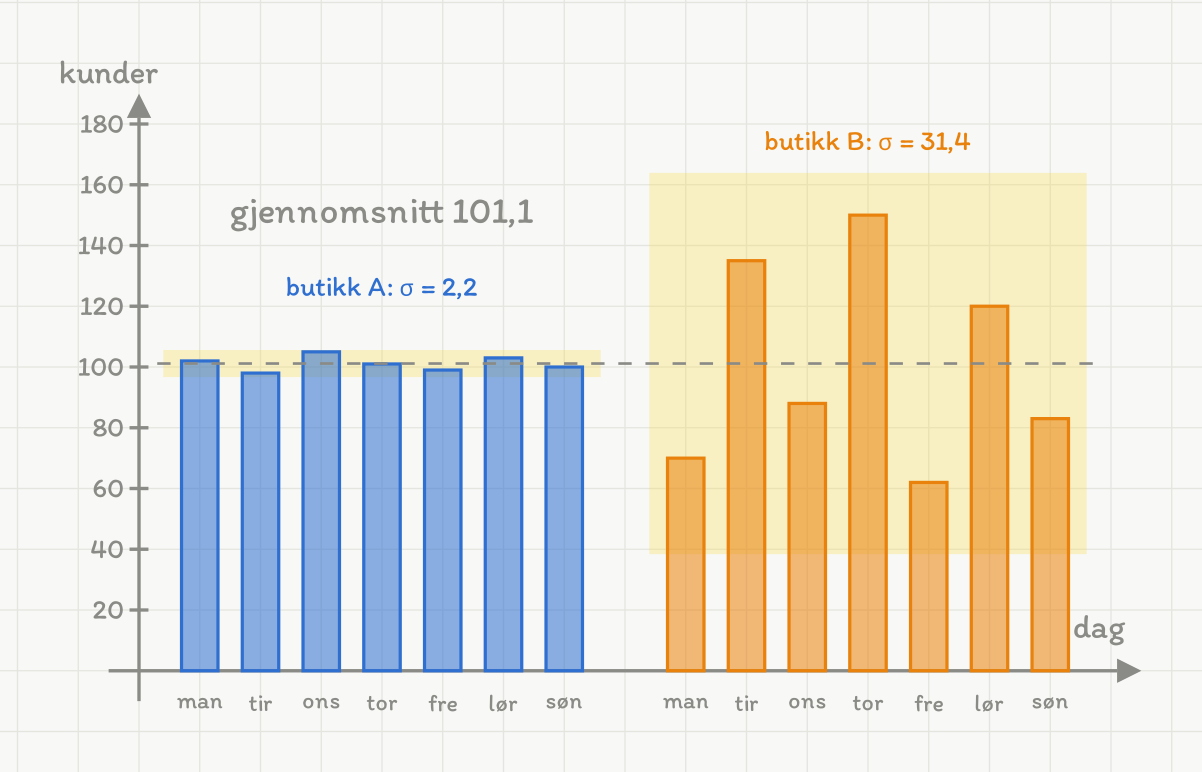
Samme gjennomsnitt, helt ulikt bemanningsbehov. Butikk A holder seg innenfor et bånd på ni kunder, butikk B innenfor et på 125 — og det er båndbredden, ikke gjennomsnittet, som avgjør hvor mange som må være på jobb.
Svar b): Butikk A kan bemanne likt hver dag; butikk B må bemanne etter
ukedag. Gjennomsnittet alene ville skjult hele forskjellen.
Andre muligheter: Butikk B kunne også beskrives med kvartilbredden
( kunder), eller med to gjennomsnitt — ett for
hverdager og ett for helg — hvis mønsteret gjentar seg fra uke til uke.
Gjennomsnittet er og standardavviket er (avrundet).
Legg til hver verdi. Hva blir det nye gjennomsnittet?
Hva blir standardavviket etter at du har lagt til ? Forklar uten å regne alt på nytt.
Gang i stedet hver verdi med . Hva blir gjennomsnittet og standardavviket?
En elev sier: «Standardavviket kan aldri bli negativt.» Har eleven rett?
dager for bestillinger:
De bestillingene er et utvalg fra alle bestillingene i året.
Finn gjennomsnitt, median og kvartilbredde med regneark.
Finn standardavviket. Hvilken av funksjonene STDAV.P og STDAV.S skal du bruke her, og hvorfor?
Fjern observasjonen og regn ut gjennomsnitt, median og på nytt. Hvilke av målene endrer seg mest?
Butikken lover «levering innen dager». Hvor stor andel av bestillingene i utvalget holdt løftet?
Butikken vil oppgi ett tall for leveringstiden på nettsiden. Hva bør de oppgi, og hva bør de eventuelt si i tillegg?
kroner) til fem ansatte i hver bedrift:
| Bedrift 1 | 480 | 490 | 500 | 510 | 520 |
|---|---|---|---|---|---|
| Bedrift 2 | 380 | 420 | 500 | 580 | 620 |
Finn gjennomsnitt og median i hver bedrift.
Finn for hver bedrift (de fem er alle vi har tall for). Rund av til to desimaler.
Hva forteller standardavvikene om de to bedriftene?
Hvilken bedrift ville du valgt, og hvilken tilleggsinformasjon ville du bedt om først?
Bedrift 2 skriver i annonsen: «Hos oss tjener de ansatte i gjennomsnitt kroner — akkurat som hos konkurrenten.» Er det en dekkende beskrivelse?
Oppsummering
I dette kapittelet har du lært:
| Spredningsmål | Formel | Bruker | Robust mot uteliggere? |
|---|---|---|---|
| Variasjonsbredde | 2 observasjoner | Nei | |
| Kvartilbredde | midterste | Ja | |
| Varians | alle | Nei | |
| Standardavvik | alle | Nei |
- Kvartilene deler et sortert materiale i fire like store deler. er
medianen i nedre halvdel, er medianen i øvre halvdel.
- Avvikene summerer seg alltid til . Derfor kvadrerer vi
dem før vi summerer — og tar kvadratroten til slutt, så enheten stemmer igjen.
- deler på (hele materialet), deler på (utvalg
som skal si noe om en større populasjon). er alltid størst. I regneark:
STDAV.P og STDAV.S.
- Å sammenligne to materialer: oppgi alltid både et sentralmål og et
spredningsmål, og forklar konklusjonen med tallene.
Husk
- Sjekk at avvikene summerer seg til før du går videre.
- Standardavviket er aldri negativt. Er , er alle observasjonene like.
- Å legge det samme tallet til alle observasjonene endrer ikke spredningen.
Dette kapitlet er skrevet av Anthropics toppmodeller (Claude Opus og Claude Fable) og er foreløpig ikke manuelt gjennomgått — kvalitetskontrollen gjøres av uavhengige KI-agenter, og innmeldte feil rettes fortløpende. Funnet en feil? Meld fra, så retter vi den. Les mer om hvordan innholdet lages.