
Å analysere reelle data, vurdere gyldighet og presentere funnene.
Når planen møter virkeligheten
I kapittel 8.1 Problemstilling og plan skrev elevrådet ved Fjordbyen
videregående skole en plan i åtte punkter. Problemstillingen var:
Er gjennomsnittlig skjermtid på telefonen en vanlig skoledag høyere enn
minutter blant elevene på VG2 ved skolen?
De trakk elever tilfeldig fra VG2-lista på , og svarte. Nå har
de en fil med tall.
Dette kapittelet følger den samme undersøkelsen gjennom de tre siste trinnene i
arbeidssyklusen: data, analyse og presentasjon. Underveis bruker vi
metoder fra nesten hvert eneste kapittel i boka. Det er meningen — det er her
faget settes sammen.
Én ting skal du vite på forhånd: ingen datainnsamling går helt etter planen.
Noen svarer ikke. Noen svarer «ca 3 timer» i en kolonne der det skal stå et
tall. Én skriver , som er hele døgnet. Det er normalt, og det er
håndterbart — så lenge du dokumenterer hva du gjorde.
åpenbare skrivefeil, håndtere manglende svar og gjøre alle verdier om til
samme format og samme enhet.
Dataloggen er en liste over alt du gjorde under ryddingen, med begrunnelse:
| Rad | Hva som sto | Hva vi gjorde | Hvorfor |
|---|---|---|---|
| 12 | «ca 3 timer» | Eneste rimelige tolkning; avrundet som de andre | |
| 19 | (tomt) | Tatt ut | Ingen verdi å tolke |
| 27 | Tatt ut | Hele døgnet — umulig som skjermtid på telefon |
Dataloggen er ikke ryddearbeid du gjør for deg selv. Den er en del av
rapporten. Uten den kan ingen etterprøve analysen, og du kan ikke skille
mellom en verdi du fjernet fordi den var umulig, og en du fjernet fordi du
ikke likte den.
En verdi kan fjernes når den er umulig eller utenfor det variabelen
måler: en skjermtid på minutter, en alder på år, en
strømregning i feil måned.
En verdi kan ikke fjernes fordi den er uvanlig. En elev med
minutter er en ekte elev som virkelig brukte minutter. Fjerner du de
høyeste verdiene, senker du gjennomsnittet med vilje, og analysen måler ikke
lenger populasjonen — den måler hvor mye du var villig til å fjerne.
Er du i tvil: behold verdien, og regn analysen begge veier. Blir svaret
det samme, spiller det ingen rolle. Blir det forskjellig, er det selve funnet
ditt, og det skal stå i rapporten.
De første radene i elevrådets fil ser slik ut. Kolonne B er skjermtid i
minutter, kolonne C er søvn i timer.
| Rad | Skjermtid | Søvn |
|---|---|---|
| 2 | 240 | 8 |
| 3 | 185 | 6,5 |
| 4 | ca 4 timer | 6,5 |
| 5 | 220 | 7 |
| 6 | (tomt) | (tomt) |
| 7 | 1440 | 7 |
| 8 | 330 | 7 |
Rydd fila, og skriv dataloggen.
Rad 4 — «ca 4 timer». Verdien finnes, men er i feil format. timer er
minutter. Vi gjør den om og noterer det. Alternativet — å
kaste raden — ville fjernet informasjon vi faktisk har.
Rad 6 — tomt. Eleven svarte ikke. Her finnes ingen verdi å tolke, og raden
tas ut. Den teller som frafall, ikke som nedsatt datakvalitet, og skal med
i svarprosenten.
Rad 7 — . Et døgn har minutter. Verdien er
altså hele døgnet, søvnen inkludert, og er umulig som skjermtid. Vi tar den
ut, og noterer at vi mistenker at eleven leste av feil tall i loggen.
Rad 8 — . Dette er den høyeste ekte verdien i materialet, men
timer på telefonen er fullt mulig. Vi beholder den. (Vi kontrollerer senere om
den er en uteligger etter regelen i kapittel 1.5 — det er den ikke.)
Dataloggen:
| Rad | Hva som sto | Hva vi gjorde | Hvorfor |
|---|---|---|---|
| 4 | «ca 4 timer» | Omregnet til minutter, samme enhet som de andre | |
| 6 | tomt | Raden tatt ut | Ingen verdi; telles som frafall |
| 7 | Raden tatt ut | Hele døgnet — umulig verdi |
Svar: Rad 4 gjøres om til , rad 6 og 7 tas ut, rad 8 beholdes. Etter
ryddingen står det brukbare svar igjen av trukne, altså en
svarprosent på
Fila inneholder disse verdiene:
Eleven som skrev , bor i nabobygget til skolen.
Hvilke verdier er umulige og skal ut?
Hva gjør du med ?
Hva gjør du med «under 10» og med den tomme cellen?
Hvor mange verdier står igjen, og hva er gjennomsnittet av dem?
Skriv dataloggen for de tre radene du endret eller fjernet.
Analysetrappa
Når dataene er ryddet, er fristelsen å kaste alt du kan av statistikk på dem.
Ikke gjør det. Analysen skal svare på problemstillingen, og ingenting
annet. En rapport med ti diagrammer som ikke svarer på spørsmålet, er svakere
enn en rapport med to som gjør det.
Analysen har tre trinn, og du går bare så langt opp som problemstillingen
krever:
| Trinn | Hva du gjør | Verktøy | Kapittel |
|---|---|---|---|
| 1. Beskriv | Hvordan ser materialet ut? | , , median, kvartiler, histogram, boksplott | 1.2–1.5 |
| 2. Sammenlign eller se sammenheng | Er gruppene forskjellige? Følger de to variablene hverandre? | Boksplott side ved side, spredningsplott, , regresjonslinje | 1.5, 2.1–2.3 |
| 3. Generaliser | Hva tør vi si om hele populasjonen? | Konfidensintervall, hypotesetest | 7.1–7.7 |
Trinn 1 hopper du aldri over. Det er der du oppdager skrivefeilen du ikke fant
i ryddingen, og det er der du ser om materialet i det hele tatt ser ut slik
metodene i trinn 3 forutsetter.
a) Regn ut og .
b) Finn femtallssammendraget, og undersøk om materialet har uteliggere.
c) Lag et histogram med klassebredde minutter, og beskriv formen.
standardavvik.
Gjennomsnittet er summen delt på antallet:
Summen av alle verdiene er , så
Det er timer og minutter.
For spredningen bruker vi utvalgsstandardavviket , altså den som deler
på . Grunnen står i kapittel 5.7: de elevene er et utvalg som skal
si noe om alle , og da underestimerer -versjonen spredningen i
populasjonen.
I regneark: =STDAV.S(B2:B37). Det gir
(Føres ikke: hele summen regnes av
regnearket.)
b) Femtallssammendraget (kapittel 1.5). Med er medianen snittet av
den og den verdien:
Nedre kvartil er medianen i de laveste, altså snittet av den og
:
Øvre kvartil er medianen i de høyeste, altså snittet av den og
:
Femtallssammendraget er — — — — .
Uteliggergrensene fra kapittel 1.5:
Største verdi er , minste er . Begge ligger godt innenfor. Ingen
uteliggere — og dermed ingen verdi vi trenger å diskutere om skal være med.
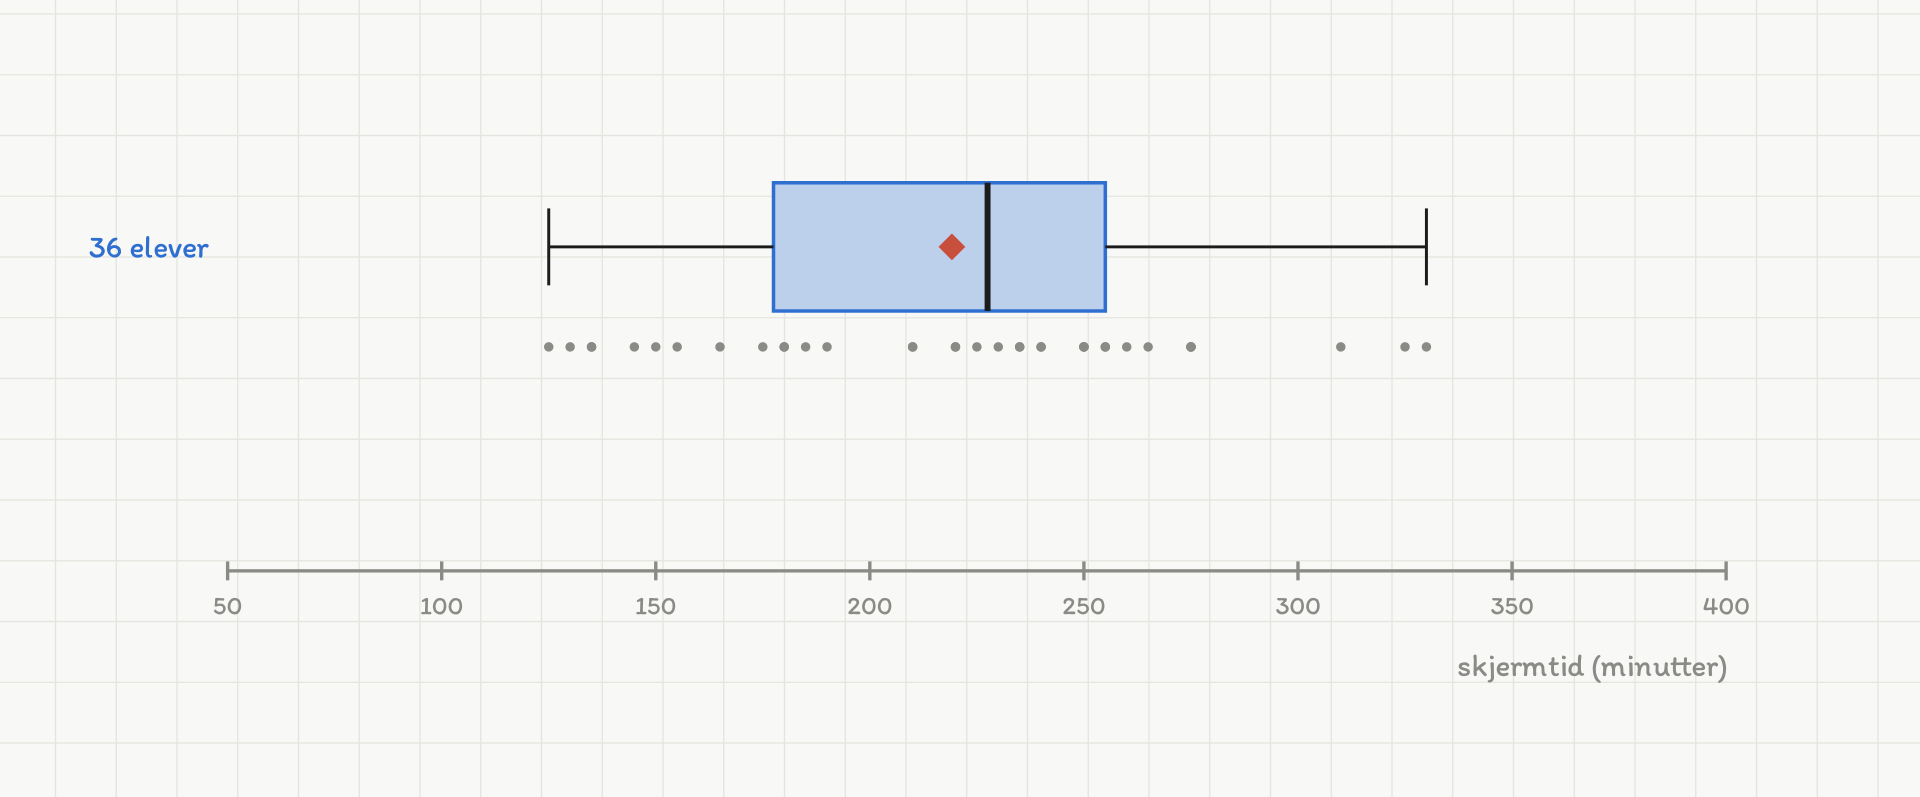
Femtallssammendraget som bilde: 125 — 177,5 — 227,5 — 255 — 330. Boksen rommer de midterste 50 % av elevene, og minutter. Uteliggergrensene og ligger utenfor alle målingene, så materialet har ingen uteliggere. Den røde romben er gjennomsnittet 219,2 — det ligger til venstre for medianen, som i en venstreskjev fordeling.
c) Vi teller opp i klasser med bredde :
| Klasse (min) | Sum | |||||
|---|---|---|---|---|---|---|
| Antall | 5 | 8 | 10 | 10 | 3 | 36 |
Kontroll: . Det stemmer.
Formen: fordelingen er tilnærmet symmetrisk, med tyngdepunktet i
midten. Klassene er , og det er nøyaktig like langt fra
medianen ut til hver ytterverdi: og
. Venstresiden er likevel litt tyngre enn høyresiden:
gjennomsnittet () ligger omtrent minutter under medianen
(), fordi det er flere lave verdier enn høye.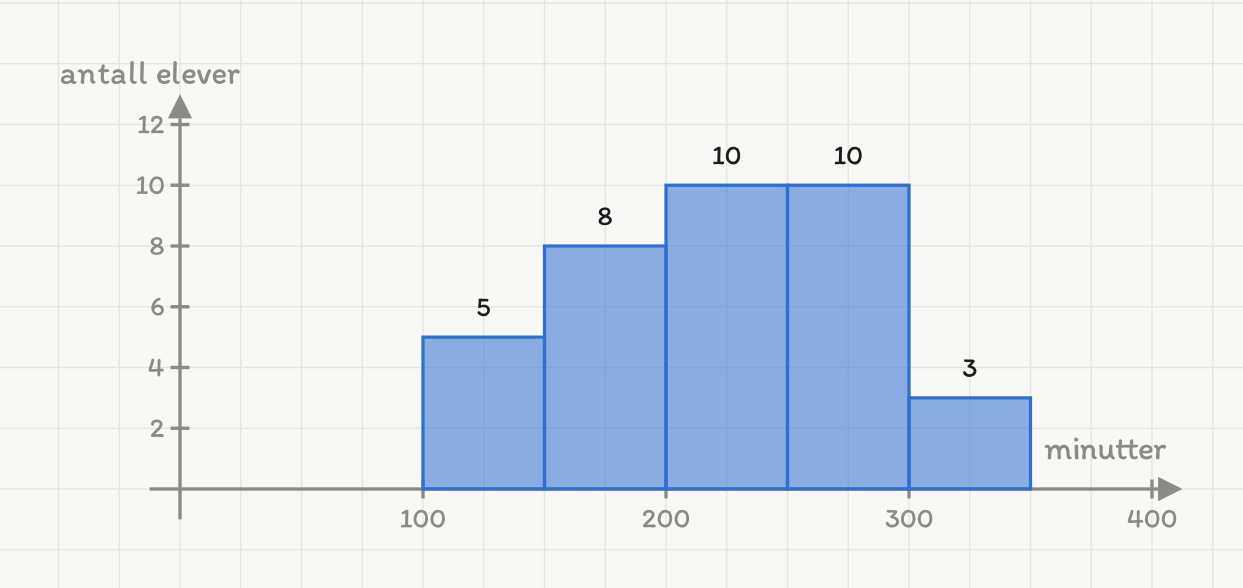
Skjermtid på en skoledag for de 36 elevene som svarte, i klasser på 50 minutter. Tyngdepunktet ligger mellom 200 og 300 minutter, og fordelingen er nesten symmetrisk, med et lite overskudd mot venstre: gjennomsnittet 219,2 ligger litt lavere enn medianen 227,5.
Svar: a) minutter og
minutter; b) — — — — , ingen uteliggere;
c) — en tilnærmet symmetrisk fordeling uten uteliggere.
fikk svar (minutter):
Gjør den samme beskrivende analysen som i eksempel 2.
Regn ut og . Bruk =GJENNOMSNITT(...) og =STDAV.S(...). Rund av til én desimal.
Finn femtallssammendraget.
Undersøk om er en uteligger etter regelen i kapittel 1.5.
Skal fjernes? Begrunn, og regn ut hva blir hvis du fjerner den.
Sammenlign de to skolene. Hvilke to tall vil du sette opp mot hverandre, og hva kan du ikke konkludere med?
Fra utvalget til populasjonen
Så langt har vi bare beskrevet de elevene som svarte. Problemstillingen
handler om alle . Skrittet fra de til de er nettopp det
kapittel 7 handler om, og det består av to deler:
- Konfidensintervallet sier hvor trolig ligger.
- Hypotesetesten sier om materialet er sterkt nok til å forkaste påstanden
om at .
De to henger sammen, og det er nyttig å se dem side om side før du regner:
ligger utenfor det konfidensintervallet, vil den tosidige
testen forkaste på -nivå.
Formlene i kapittel 7.2 og 7.5 er skrevet med , populasjonens
standardavvik. Det kjenner vi nesten aldri. I praksis setter vi inn fra
utvalget i stedet.
Det er en tilnærming, og den er god når er stor nok — som en tommelfingerregel
. Her er .
NB: Tilnærmingen gjør intervallet litt for smalt og testen litt for
villig til å forkaste. Er liten, skal du ikke gjøre det på denne måten.
Da trengs andre fordelinger enn normalfordelingen, og det ligger utenfor dette
faget.
For de svarene er minutter og
minutter.
a) Regn ut et konfidensintervall for .
b) Test : mot : på signifikansnivå.
c) Ville konklusjonen blitt den samme på -nivå?
Hva må vi finne? Intervall, testkonklusjon — og hvor følsom konklusjonen er
for signifikansnivået.
Vi begynner med standardfeilen, som begge delene bygger på:
a) Formelen for konfidensintervallet (kapittel 7.2), først tom:
og så med tall:
Intervallet blir
Vi er altså sikre på at gjennomsnittlig skjermtid blant alle de
VG2-elevene ligger mellom og minutter.
Legg merke til bredden: intervallet er minutter bredt. Undersøkelsen kan
ikke skille fra minutter. Det var akkurat det feilmarginregningen
i kapittel 8.1 eksempel 4 forutsa — der kom vi fram til omtrent minutter
hver vei.
b) Hypotesene:
Testen er ensidig fordi problemstillingen spør om skjermtiden er høyere
enn i fjor, ikke om den er forskjellig fra i fjor.
Testobservatoren (kapittel 7.5), først tom:
og med tall:
Den kritiske verdien for en ensidig test på -nivå er . Siden
forkaster vi .
-verdien er sannsynligheten for å få et gjennomsnitt minst så høyt som vårt,
dersom er sann:
c) På -nivå er den kritiske verdien . Nå er
og vi forkaster ikke. Det samme ser vi på -verdien: .
Dette er verdt å stoppe ved. Det samme datamaterialet gir «forkast» på
-nivå og «forkast ikke» på -nivå. Konklusjonen er altså ikke
solid — den er akkurat på riktig side av grensen vi valgte på forhånd. En
ærlig rapport skriver det, i stedet for bare å skrive «signifikant».
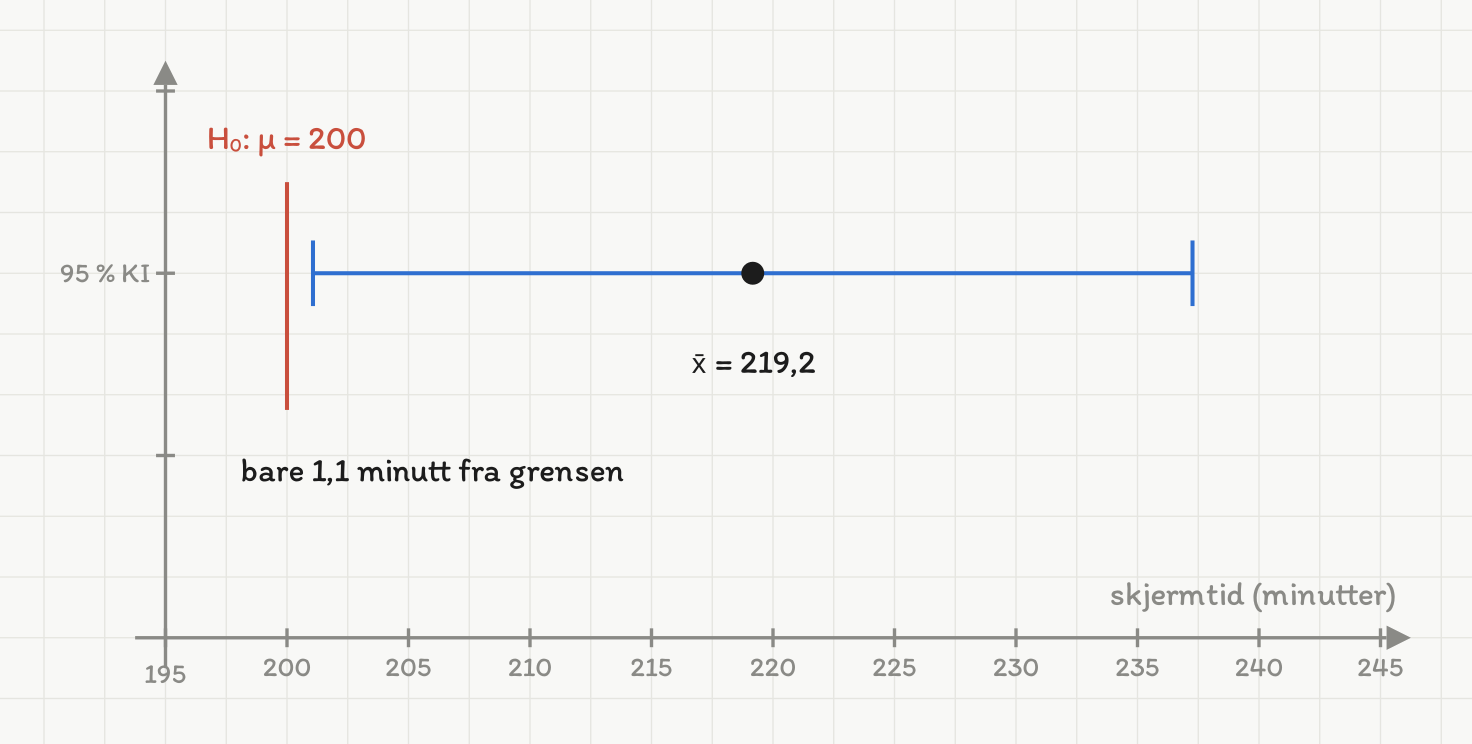
At 200 ligger utenfor intervallet, er den samme opplysningen som at testen forkaster . Men marginen er 1,1 minutt på et intervall som er 36 minutter bredt. Konklusjonen er altså riktig — og tynn. Det er verdt å skrive i rapporten, ikke bare ordet «signifikant».
Svar: a) minutter; b) , , så forkastes på -nivå;
c) nei — på -nivå forkastes ikke .
En kommune har målt ventetiden på legevakten for et tilfeldig utvalg på
pasienter. Utvalget ga minutter og
minutter. Kommunen har lovet at gjennomsnittlig ventetid ikke
overstiger minutter.
Regn ut standardfeilen .
Regn ut et konfidensintervall for .
Sett opp hypotesene, og avgjør om testen skal være ensidig eller tosidig.
Regn ut og avgjør på -nivå.
En avis skriver: «Målingen viser at kommunen holder løftet sitt.» Er det en dekkende tolkning? Begrunn.
Sammenhengen mellom to variabler
Elevrådet spurte også om søvn natten etter. Da har de to tall for hver elev, og
kan undersøke tilleggsspørsmålet fra planen:
Er det en sammenheng mellom skjermtiden på skoledagen og antall timer søvn
natten etter?
Framgangsmåten er den fra kapittel 2.1–2.3, i tre skritt:
1. Tegn spredningsplottet først. Alltid. Korrelasjonskoeffisienten alene
kan ikke skille en rett sammenheng fra en krum, og et tall skjuler en
uteligger som et plott viser med én gang.
2. Regn korrelasjonskoeffisienten , og tolk styrken og retningen.
3. Finn regresjonslinja hvis sammenhengen ser lineær ut — og bare da.
Til slutt kommer det viktigste skrittet, som ikke er regning i det hele tatt:
å si hva sammenhengen ikke betyr.
For de samme elevene er
| Størrelse | Skjermtid (min) | Søvn (timer) |
|---|---|---|
| Gjennomsnitt | ||
| Standardavvik |
Korrelasjonskoeffisienten er .
a) Tolk .
b) Finn regresjonslinja.
c) Hvor mye mindre søvn svarer linja til når skjermtiden øker med
minutter?
d) Hvor stor andel av variasjonen i søvn henger sammen med skjermtid?
e) Kan elevrådet skrive at skjermtid gir dårligere søvn?
materialet. Tallverdien er en middels sterk sammenheng (kapittel
2.2): punktene følger en fallende retning, men med tydelig spredning rundt
den.
b) Stigningstallet til regresjonslinja (kapittel 2.3), først tomt:
og med tall:
Konstantleddet finner vi av at linja går gjennom :
Linja blir
(Føres ikke: vi har regnet videre på de avrundede tallene i tabellen over.
Regner regnearket i stedet direkte på de tallparene, får det
og . Forskjellen sitter i fjerde gjeldende
siffer og skyldes bare avrundingen i tabellen — linja blir den samme.
Konstantleddet må derimot regnes med uavrundet : setter du inn ,
får du , og linja går ikke lenger gjennom .)
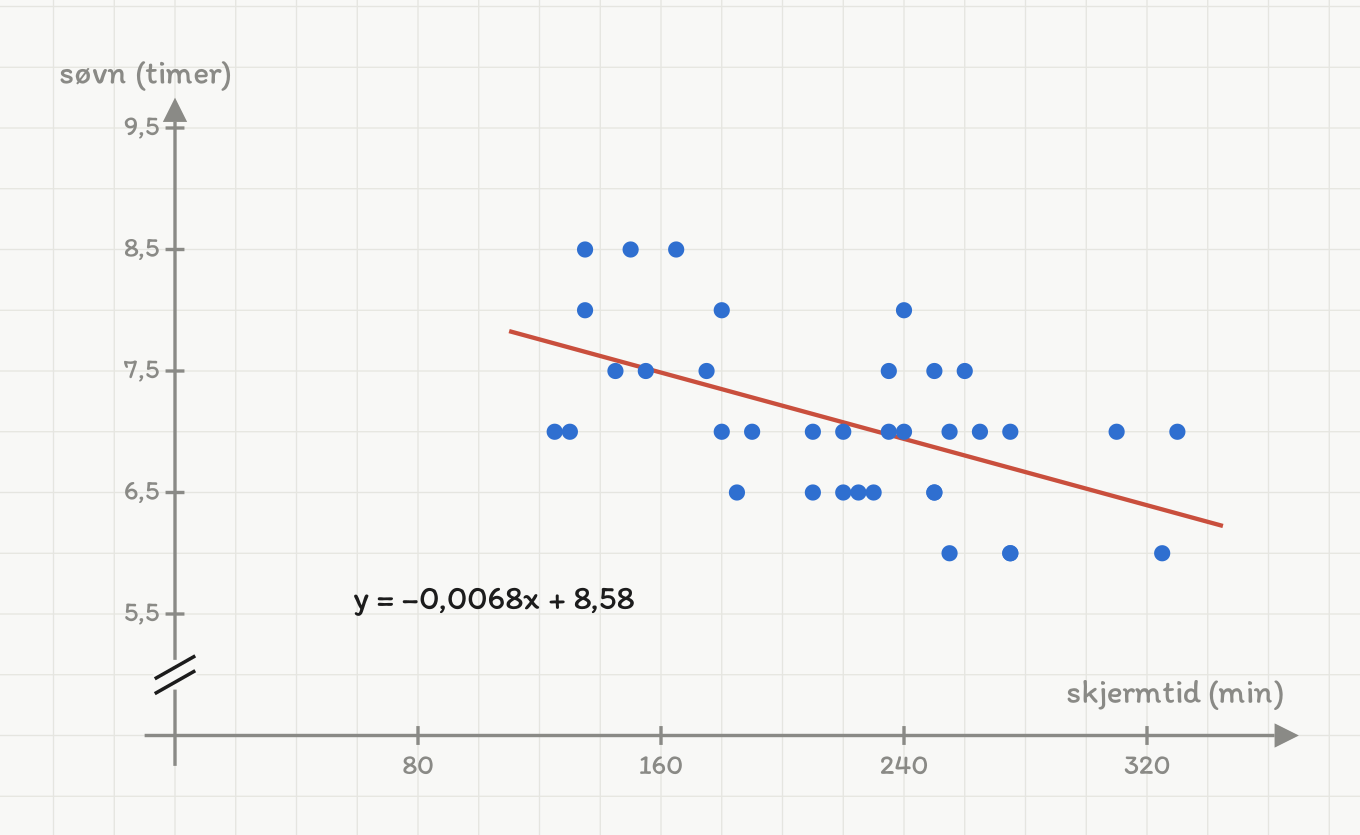
Søvn mot skjermtid for de 36 elevene, med regresjonslinja. Den loddrette aksen har et markert brudd, slik kapittel 1.6 krever av en innzooming. Spredningen rundt linja er stor — r = −0,55.
c) Stigningstallet forteller hvor mye endrer seg når øker med . Vi
ganger med :
Linja svarer til omtrent timer mindre søvn, altså rundt minutter,
per minutter mer skjermtid.
d) Andelen er (kapittel 2.3):
Omtrent av variasjonen i søvn henger sammen med skjermtiden. De
resterende skyldes alt annet: trening, jobb, lekser, bekymringer,
hvor langt eleven har til skolen.
e) Nei. Dette er kjernen i kapittel 2.4. Materialet er observert, ikke
framkalt: ingen ble tildelt mye eller lite skjermtid. Minst tre forklaringer
passer like godt til de samme punktene:
- Skjermtid går ut over søvnen.
- Den som sover dårlig, ligger våken med telefonen — årsaken går andre
veien.
- En tredje faktor, for eksempel kveldsjobb eller stress, gir både mer
skjermtid og mindre søvn.
Skal årsak avgjøres, trengs et forsøk der skjermtiden faktisk tildeles
tilfeldig — og det er noe annet enn en spørreundersøkelse.
Svar: a) middels sterk negativ sammenheng; b) ;
c) omtrent timer, altså rundt minutter; d) omtrent ;
e) nei — sammenheng er ikke årsak.
En iskiosk har registrert temperatur og antall solgte softis på dager.
Materialet oppsummeres slik:
| Størrelse | Temperatur (°C) | Solgte softis |
|---|---|---|
| Gjennomsnitt | ||
| Standardavvik |
Korrelasjonskoeffisienten er .
Tolk med ord.
Finn stigningstallet til regresjonslinja.
Finn hele linja.
Hvor mange softis svarer linja til på en dag med C?
Kiosken vil bruke linja til å anslå salget ved C. Hva må de være klar over, og hva forteller dem?
Presentasjonen
Rapporten er ikke et vedlegg til arbeidet. For alle andre enn deg selv er
rapporten arbeidet. Den følger den samme rekkefølgen som selve undersøkelsen,
og seks deler skal være med:
| Del | Innhold | Lengde |
|---|---|---|
| 1. Problemstilling | Ordrett som i planen, og hvorfor den er interessant | Noen linjer |
| 2. Metode | Populasjon, utvalgsmetode, , svarprosent, hvordan variablene ble målt, datalogg | En halv side |
| 3. Resultater | Tabeller, figurer og tall — uten tolkning | En side |
| 4. Analyse | Konfidensintervall, test, sammenhenger — med tolkning | En side |
| 5. Gyldighet | Feilkilder, og hvilken vei hver av dem trekker | En halv side |
| 6. Konklusjon | Svaret på problemstillingen, med forbehold | Noen linjer |
Legg merke til skillet mellom del 3 og del 4. I resultatdelen står det som ble
målt. I analysedelen står det du mener det betyr. Blander du dem, kan ikke
leseren skille mellom dataene dine og meningene dine.
Fra kapittel 1.5 og 1.6:
1. Begge akser har navn og enhet. «minutter», ikke bare tall.
2. Søylediagram starter på null. Et avkuttet søylediagram overdriver
forskjeller. Skal du zoome inn på et linje- eller punktdiagram, marker
bruddet tydelig.
3. Figuren har en bildetekst som sier hva den viser, hvor mange enheter
den bygger på, og hvor tallene kommer fra.
4. Riktig figurtype. Histogram for numeriske data i klasser, søylediagram
for kategorier, linjediagram bare når den vannrette aksen er tid.
5. Ingen figur uten oppgave. Har du en figur som ikke brukes i teksten,
slett den.
Elevrådet har to utkast til konklusjon. Vurder dem.
Utkast A: «Undersøkelsen vår viser at elevene bruker altfor mye tid på
skjerm, og at skjermtid ødelegger søvnen. Skjermtiden har økt kraftig siden i
fjor.»
Utkast B: Se løsningen.
- «altfor mye» — en verdivurdering. Undersøkelsen har ikke målt noen grense
for hva som er for mye, og kan derfor ikke belegge ordet.
- «skjermtid ødelegger søvnen» — en årsakspåstand fra observerte data
(kapittel 2.4). Sammenhengen er målt; retningen er ikke.
- «økt kraftig» — testen forkastet på -nivå, men ikke på
. Forskjellen er minutter, mot en feilmargin på . «Kraftig»
er ikke dekkende.
- «elevene» — hvilke? Dataene gjelder VG2 ved én skole, på én dag, og bare
telefonen.
Utkast B — en konklusjon materialet bærer:
Blant de VG2-elevene som svarte, var gjennomsnittlig skjermtid på
telefonen mandag 15. september minutter. Et konfidensintervall
for gjennomsnittet blant alle VG2-elevene er
minutter. En ensidig test forkaster : på -nivå
(, ), men ikke på -nivå. Vi har altså et
visst, men ikke sterkt, belegg for at skjermtiden er høyere enn de
minuttene elevrådet målte i fjor.Vi fant også en middels sterk negativ sammenheng mellom skjermtid og søvn
natten etter (). Undersøkelsen kan ikke avgjøre om skjermtid
går ut over søvnen, om dårlig søvn gir mer skjermtid, eller om begge deler
henger sammen med noe tredje.Resultatet gjelder telefonbruk på én skoledag ved én skole, blant de
av de trukne elevene som svarte. PC og nettbrett er ikke målt.
Sammenligningen med fjorårets tall forutsetter at undersøkelsen den gangen
ble gjort på samme måte; det har vi ikke kunnet kontrollere.
Hva utkast B gjør, som A ikke gjør: hvert tall står sammen med
usikkerheten sin, hver påstand er begrenset til det som faktisk ble målt, og
det som ikke kan avgjøres, står som noe som ikke kan avgjøres.
Svar: Utkast A går lenger enn dataene på fire punkter. Utkast B er
dekkende.
1. Tall uten usikkerhet. «Gjennomsnittet er minutter» later som
om vi kjenner populasjonen nøyaktig. Oppgi intervallet.
2. For mange desimaler. minutter er avlest i
femminutters trinn. Rund til .
3. Konklusjon om en større populasjon enn den du målte. «Ungdom» når du
målte VG2 ved én skole.
4. Årsak av sammenheng. Se kapittel 2.4.
5. «Ikke forkastet» presentert som «bevist». En test som ikke forkaster
, har ikke vist at er sann.
Oppsummering
I dette kapittelet har du lært:
- Datarydding: rett format, håndter manglende svar, og fjern bare det som
er umulig — aldri det som bare er uvanlig. Alt du gjør, føres i
dataloggen, som er en del av rapporten.
- Analysetrappa: beskriv først (, , femtallssammendrag,
histogram), så sammenlign eller se sammenheng, og generaliser til slutt. Gå
bare så langt som problemstillingen krever.
- Generalisering: konfidensintervallet sier hvor trolig ligger,
hypotesetesten sier om materialet er sterkt nok til å forkaste påstanden.
Med kan brukes i stedet for .
- Sammenheng: tegn spredningsplottet før du regner , og bruk
regresjonslinja bare når sammenhengen ser lineær ut. sier hvor stor
andel av variasjonen som henger sammen med den andre variabelen.
- Rapporten i seks deler, med resultater og tolkning i hver sin del.
- Konklusjonen skal svare på problemstillingen, oppgi usikkerheten, og
begrense seg til det som faktisk ble målt.
Vurderingskriterier for det utforskende arbeidet
| Kriterium | Hva som vurderes |
|---|---|
| Statistiske begreper | Populasjon, utvalg, og , og , signifikansnivå og -verdi brukes presist og riktig |
| Gjennomføring | Dataene er ryddet og dokumentert; analysen er den problemstillingen krever |
| Gyldighet | Feilkilder er vurdert, og det står hvilken vei hver av dem trekker |
| Presentasjon | Seks deler, figurer med akser og bildetekst, tall med riktig antall desimaler |
| Konklusjon | Svarer på problemstillingen, med usikkerhet og med riktig rekkevidde |
Husk
- Resultater og tolkning i hver sin del av rapporten.
- Det du ikke kan avgjøre, skal stå som noe du ikke kan avgjøre.
kapittel 8.1, og lever rapporten i seks deler.
Bruker du en offentlig kilde i stedet for egen innsamling, er dette et forslag
som fungerer: last ned folketallet i kommunen din 1. januar hvert år fra SSBs
statistikkbank for de siste ti årene, og undersøk problemstillingen «Hvordan
har folketallet i kommunen endret seg fra 2015 til 2025, og hvilken årlig
vekstrate svarer endringen til?»
Regnearket skal inneholde et eget ark for rådata og et for analyse, slik at
rådataene aldri overskrives.
Legg inn rådataene, rydd dem, og skriv dataloggen som en tabell i arket.
Oppgi , og svarprosenten dersom du har samlet inn data selv. Har du brukt en kilde: oppgi hvem, når og hvordan kilden samlet inn dataene.
Gjør den beskrivende analysen: =GJENNOMSNITT(...), =MEDIAN(...), =STDAV.S(...), =MIN(...), =MAKS(...), og minst én figur.
Generaliser: regn ut et konfidensintervall, eller gjennomfør hypotesetesten fra planen din. Bruker du en totaltelling, forklar hvorfor ingen av delene trengs.
Skriv gyldighetsdelen og konklusjonen. Konklusjonen skal ikke være lengre enn ti linjer.
-verdien med simulering (kapittel 4.8), uten å bruke
normalfordelingstabellen.
Ideen er den samme som i enhver hypotesetest: vi later som om er sann,
utfører undersøkelsen mange ganger under den forutsetningen, og teller hvor
ofte vi får et gjennomsnitt minst så høyt som det vi faktisk fikk.
Et program som gjør det:
import random

antall = 100000
mu = 200
sigma = 55
n = 36
observert = 219.17
treff = 0

for i in range(antall):
    sum_x = 0
    for j in range(n):
        sum_x = sum_x + random.gauss(mu, sigma)
    if sum_x / n >= observert:
        treff = treff + 1

print(treff / antall)Forklar linje for linje hva programmet gjør, og hvor i programmet forutsetningen « er sann» ligger.
Hva slags tall venter du at programmet skriver ut? Begrunn ut fra eksempel 3.
Sett opp den samme simuleringen i regneark, med forsøk.
Kjør simuleringen flere ganger med forsøk og noter svarene. Hvorfor blir de ikke like, og hvor stor er usikkerheten i selve simuleringen?
Drøft: hva vinner vi på å gjøre testen med simulering i stedet for med formelen, og hva taper vi?
«Elevene ved fylkets skoler bruker nesten fire timer på telefonen hver
dag»En ny undersøkelse fra elevrådet ved Fjordbyen videregående viser at elevene
i snitt bruker minutter på telefonen. Undersøkelsen viser også at
skjermtid går ut over søvnen.
Undersøkelsen er den du har arbeidet med i dette kapittelet.
Overskriften sier «elevene ved fylkets skoler». Hva var populasjonen, og hva heter feilen?
Tallet står uten usikkerhet. Skriv om setningen slik at usikkerheten kommer med.
«Undersøkelsen viser også at skjermtid går ut over søvnen.» Hvorfor er dette ikke dekkende, og hva ville det krevd å vise det?
«Hver dag» — hva ble faktisk målt, og hvorfor er forskjellen viktig?
Skriv en overskrift og en ingress på til sammen høyst fem linjer som er dekkende for det undersøkelsen viser.
Dette kapitlet er skrevet av Anthropics toppmodeller (Claude Opus og Claude Fable) og er foreløpig ikke manuelt gjennomgått — kvalitetskontrollen gjøres av uavhengige KI-agenter, og innmeldte feil rettes fortløpende. Funnet en feil? Meld fra, så retter vi den. Les mer om hvordan innholdet lages.